


Scrapy-Redis分布式爬虫架构与部署详解

本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
Scrapy-Redis背景与环境配置
1. 背景
Scrapy是一个功能强大的通用爬虫框架,但其原生架构并不支持分布式部署。为了解决这一问题,Scrapy-Redis应运而生,它通过提供基于Redis的组件,使得在Scrapy中实现分布式爬取变得更为便捷。
2. 环境
- 系统:win7
- scrapy-redis
- redis 3.0.5
- python 3.6.1
Scrapy-Redis核心原理与架构
3. 原理
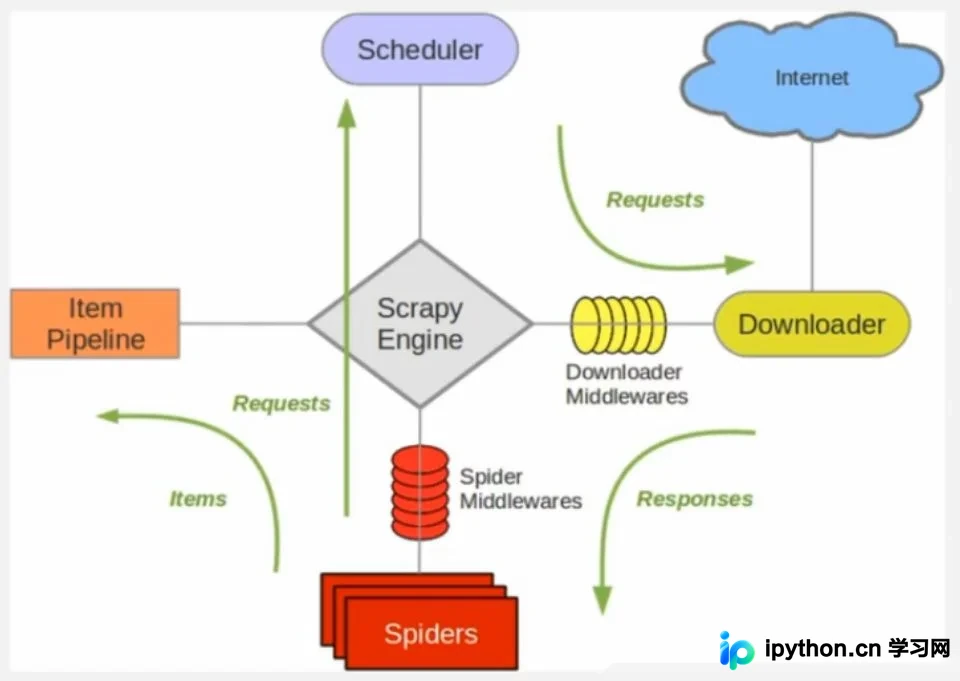
3.1. 对比一下scrapy 和 Scrapy-redis 的架构图。
scrapy架构图:
scrapy-redis 架构图:
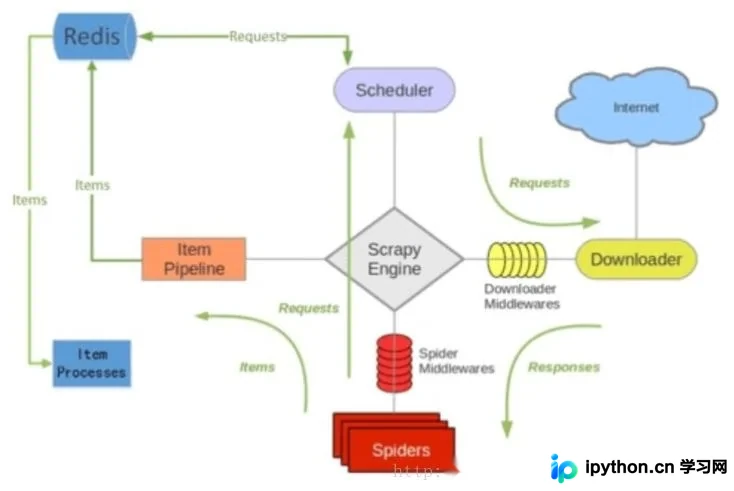
引入Redis组件后,主要影响两个核心模块:调度器和数据处理流程。3.2. Scrapy-Redis分布式策略。
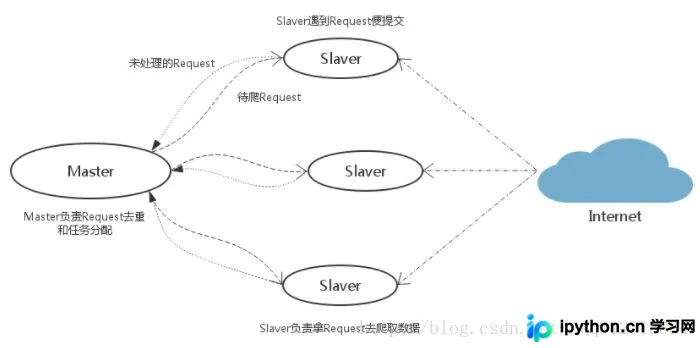
分布式爬虫系统包含Master端(核心服务器)和Slaver端(爬虫执行端)。Master端部署Redis数据库,用于存储start_urls、Request对象及Items数据。Master的核心职责包括URL指纹去重、Request任务的分配以及最终数据的持久化存储(通常结合MongoDB进行Items存储)。Slaver端则负责执行具体的爬虫逻辑,抓取数据,并将新生成的Request提交至Master端的Redis中。
如上图,假设我们有四台电脑:A, B, C, D ,其中任意一台电脑都可以作为 Master端 或 Slaver端。整个流程是:
- 首先Slaver端从Master端拿任务(Request、url)进行数据抓取,Slaver抓取数据的同时,产生新任务的Request便提交给 Master 处理;
- Master端只有一个Redis数据库,负责将未处理的Request去重和任务分配,将处理后的Request加入待爬队列,并且存储爬取的数据。
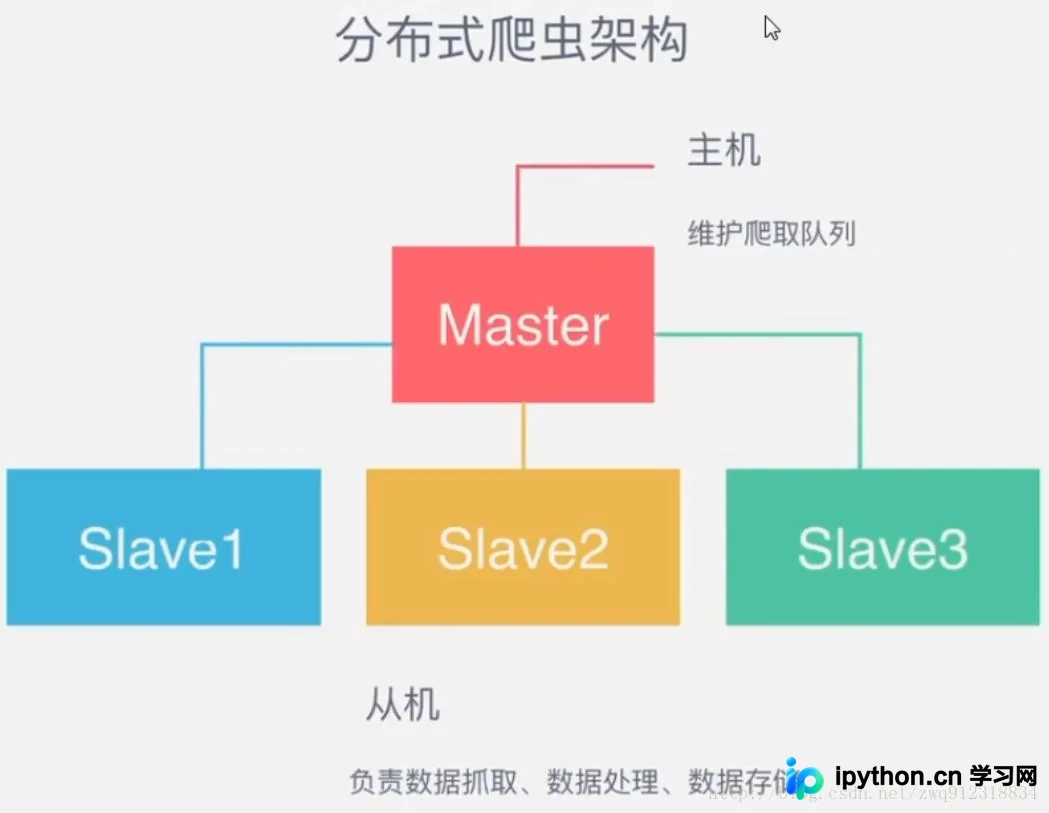
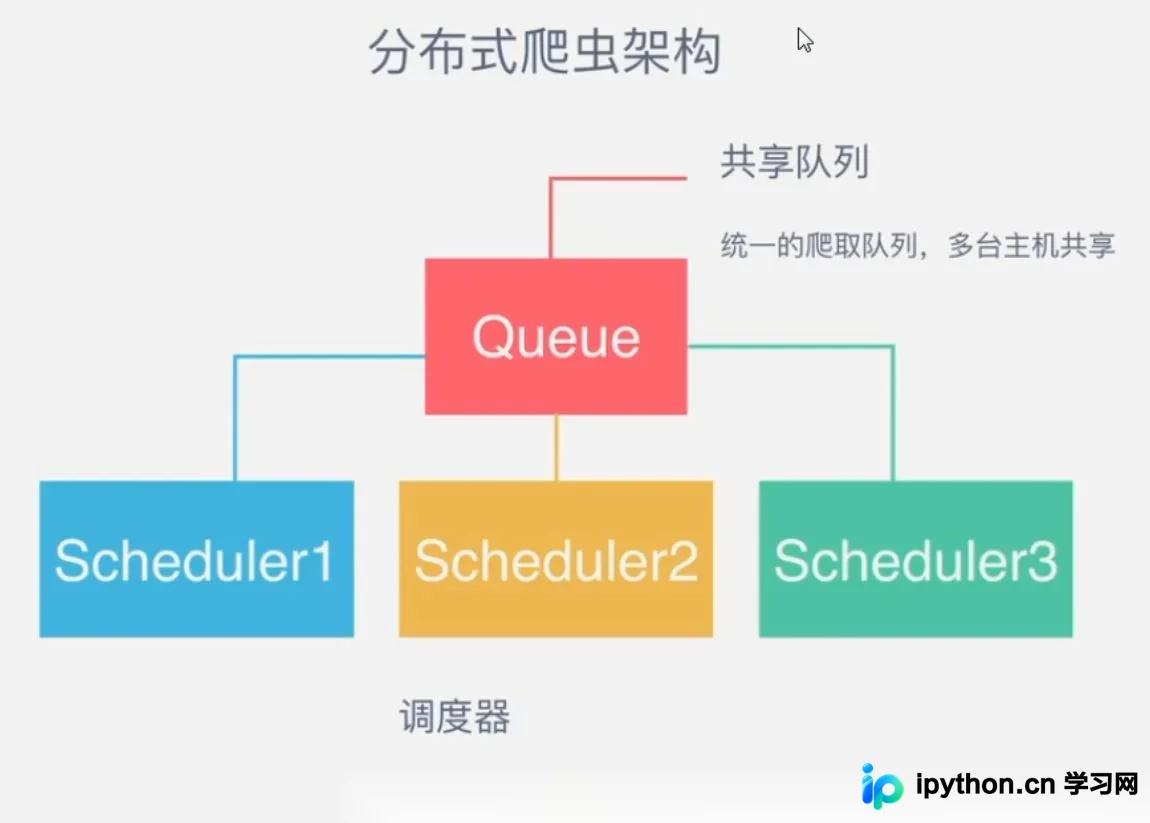
Scrapy-Redis默认使用的就是这种策略,我们实现起来很简单,因为任务调度等工作Scrapy-Redis都已经帮我们做好了,我们只需要继承RedisSpider、指定redis_key就行了。
缺点是,Scrapy-Redis调度的任务是Request对象,里面信息量比较大(不仅包含url,还有callback函数、headers等信息),可能导致的结果就是会降低爬虫速度、而且会占用Redis大量的存储空间,所以如果要保证效率,那么就需要一定硬件水平。
分布式爬虫运行流程详解
4. 运行流程
第一步:在slaver端的爬虫中,指定好 redis_key,并指定好redis数据库的地址,比如:
class MySpider(RedisSpider):
  """Spider that reads urls from redis queue (myspider:start_urls)."""
  name = 'amazon'
  redis_key = 'amazonCategory:start_
# 指定redis数据库的连接参数
'REDIS_HOST': '172.16.1.99',
'REDIS_PORT': 6379,
第二步:启动slaver端的爬虫,爬虫进入等待状态,等待 redis 中出现 redis_key ,Log如下:
2017-12-12 15:54:18 [scrapy.utils.log] INFO: Scrapy 1.4.0 started (bot: scrapybot)
2017-12-12 15:54:18 [scrapy.utils.log] INFO: Overridden settings: {'SPIDER_LOADER_WARN_ONLY': True}
2017-12-12 15:54:18 [scrapy.middleware] INFO: Enabled extensions:
['scrapy.extensions.corestats.CoreStats',
 'scrapy.extensions.telnet.TelnetConsole',
 'scrapy.extensions.logstats.LogStats']
2017-12-12 15:54:18 [myspider_redis] INFO: Reading start URLs from redis key 'myspider:start_urls' (batch size: 110, encoding: utf-8
2017-12-12 15:54:18 [scrapy.middleware] INFO: Enabled downloader middlewares:
['scrapy.downloadermiddlewares.httpauth.HttpAuthMiddleware',
 'scrapy.downloadermiddlewares.downloadtimeout.DownloadTimeoutMiddleware',
 'scrapy.downloadermiddlewares.defaultheaders.DefaultHeadersMiddleware',
 'redisClawerSlaver.middlewares.ProxiesMiddleware',
 'redisClawerSlaver.middlewares.HeadersMiddleware',
 'scrapy.downloadermiddlewares.retry.RetryMiddleware',
 'scrapy.downloadermiddlewares.redirect.MetaRefreshMiddleware',
 'scrapy.downloadermiddlewares.httpcompression.HttpCompressionMiddleware',
 'scrapy.downloadermiddlewares.redirect.RedirectMiddleware',
 'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware',
 'scrapy.downloadermiddlewares.stats.DownloaderStats']
2017-12-12 15:54:18 [scrapy.middleware] INFO: Enabled spider middlewares:
['scrapy.spidermiddlewares.httperror.HttpErrorMiddleware',
 'scrapy.spidermiddlewares.offsite.OffsiteMiddleware',
 'scrapy.spidermiddlewares.referer.RefererMiddleware',
 'scrapy.spidermiddlewares.urllength.UrlLengthMiddleware',
 'scrapy.spidermiddlewares.depth.DepthMiddleware']
2017-12-12 15:54:18 [scrapy.middleware] INFO: Enabled item pipelines:
['redisClawerSlaver.pipelines.ExamplePipeline',
 'scrapy_redis.pipelines.RedisPipeline']
2017-12-12 15:54:18 [scrapy.core.engine] INFO: Spider opened
2017-12-12 15:54:18 [scrapy.extensions.logstats] INFO: Crawled 0 pages (at 0 pages/min), scraped 0 items (at 0 items/min)
2017-12-12 15:55:18 [scrapy.extensions.logstats] INFO: Crawled 0 pages (at 0 pages/min), scraped 0 items (at 0 items/min)
2017-12-12 15:56:18 [scrapy.extensions.logstats] INFO: Crawled 0 pages (at 0 pages/min), scraped 0 items (at 0 items/min)
第三步:启动脚本,往redis数据库中填入redis_key(start_urls)
#!/usr/bin/env python
# -*- coding:utf-8 -*-

import redis

# 将start_url 存储到redis中的redis_key中,让爬虫去爬取
redis_Host = "172.16.1.99"
redis_key = 'amazonCategory:start_urls'

# 创建redis数据库连接
rediscli = redis.Redis(host = redis_Host, port = 6379, db = "0")

# 先将redis中的requests全部清空
flushdbRes = rediscli.flushdb()
print(f"flushdbRes = {flushdbRes}")
rediscli.lpush(redis_key, https://www.baidu.com)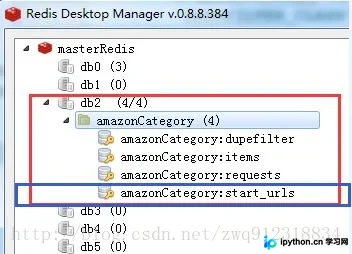
第四步:slaver端的爬虫开始爬取数据。Log如下:
2017-12-12 15:56:18 [scrapy.extensions.logstats] INFO: Crawled 0 pages (at 0 pages/min), scraped 0 items (at 0 items/min)
parse url = https://www.baidu.com, status = 200, meta = {'download_timeout': 25.0, 'proxy': 'http://proxy.abuyun.com:9020', 'download_slot': 'www.baidu.com', 'download_latency': 0.2569999694824219, 'depth': 7}
parse url = https://www.baidu.com, status = 200, meta = {'download_timeout': 25.0, 'proxy': 'http://proxy.abuyun.com:9020', 'download_slot': 'www.baidu.com', 'download_latency': 0.8840000629425049, 'depth': 8}
2017-12-12 15:57:18 [scrapy.extensions.logstats] INFO: Crawled 2 pages (at 2 pages/min), scraped 1 items (at 1 items/min)
第五步:启动脚本,将redis中的items,转储到mongodb中。
这部分代码,请参照:scrapy-redis分布式爬虫的搭建过程(代码篇)
环境安装与代码编写指南
5. 环境安装以及代码编写
5.1. scrapy-redis环境安装
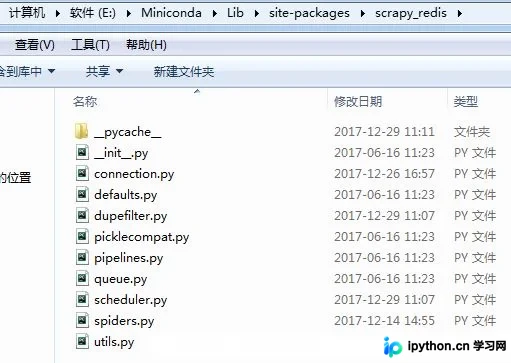
pip install scrapy-redis
代码位置:后面可以进行修改定制。
5.2. scrapy-redis分布式爬虫编写
第一步,下载官网的示例代码,地址:https://github.com/rmax/scrapy-redis (需要安装过git)
git clone https://github.com/rmax/scrapy-redis.git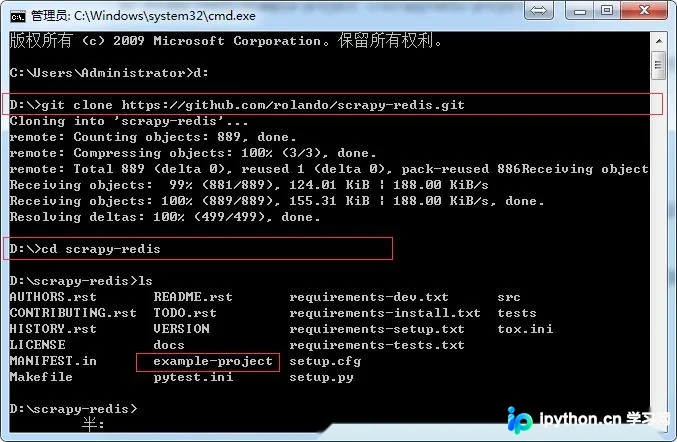
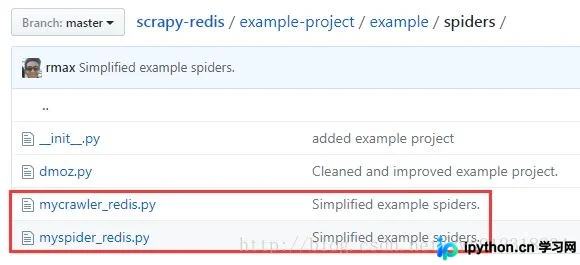
官网提供了两种示例代码,分别继承自 Spider + redis 和 CrawlSpider + redis
第二步,根据官网提供的示例代码进行修改。
到此这篇关于scrapy-redis分布式爬虫的搭建过程(理论篇)的文章就介绍到这了,更多相关scrapy redis分布式爬虫搭建内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















