


CHAR与VARCHAR、FLOAT与DECIMAL:MySQL易混数据类型对比及选型建议

在设计 MySQL 表结构时,字符串和数值类型的选用往往直接决定了存储开销与计算正确性。假设业务需要存储用户固定长度的 MD5 签名和交易订单金额,若给 MD5 字段指定了变长编码,会平白增加字符长度记录位;而若把订单金额错误声明为浮点类型,系统核账时就会出现无法解释的分分角角丢失。本文聚焦开发者最容易混淆的两组类型——CHAR 与 VARCHAR、FLOAT 与 DECIMAL,从底层存储、行为细节到选型链路展开实用解析。
一、CHAR 与 VARCHAR:定长与变长的存储与行为差异
CHAR 与 VARCHAR 最基础的区别在于“定长”与“变长”。但在实际工程中,两者的差别远不止长度是否固定,还涉及到尾部空格处理、实际存储开销以及字符集编码换算。
1. 存储结构与额外开销
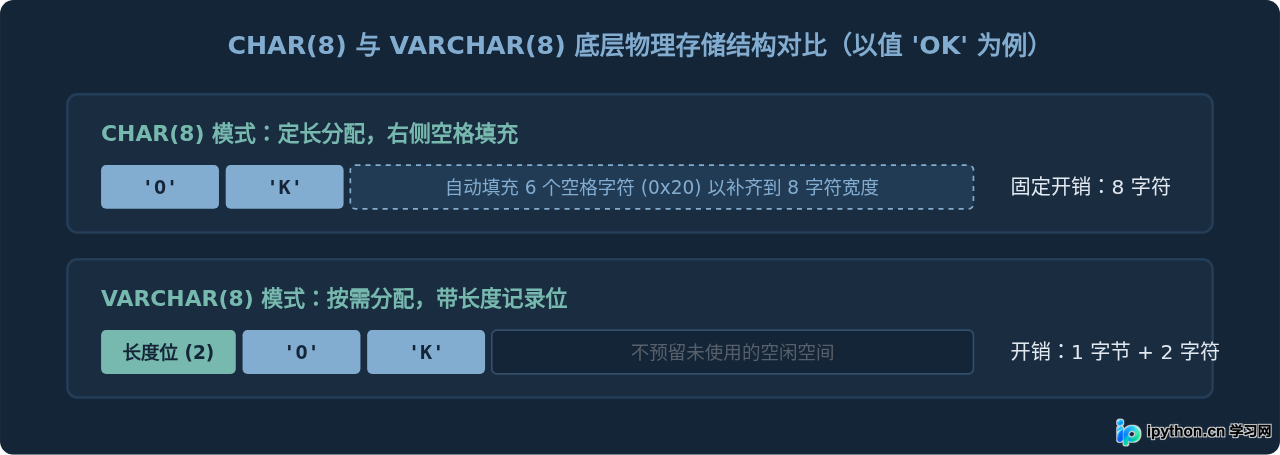
CHAR(M) 中的 M 表示字符数(取值范围 0 到 255)。存储时,无论实际写入的字符串有多短,MySQL 都会分配固定大小的物理空间。如果写入内容短于 M,系统会在右侧自动用空格补齐到 M 个字符长度。
VARCHAR(M) 中的 M 同样表示字符数(MySQL 5.0.3 及以上版本,最大理论上限为 65,535 字节)。它仅占用字符实际所需的空间,但为了记录实际内容长度,必须额外增加 1 或 2 个字节的前缀:当字段定义的最大字节长度小于等于 255 字节时,使用 1 字节记录长度;当超过 255 字节时,使用 2 字节记录长度。
utf8mb4 字符集下,1 个字符最多占用 4 个字节。定义 VARCHAR(100) 时,最大字节数为 400 字节,超过了 255 字节阈值,因此它的长度记录位将占用 2 字节,而非 1 字节。
2. 空格检索与截断特性
在默认的 SQL 模式下,CHAR 类型在被检索(SELECT)时,MySQL 会自动去除右侧补齐的所有空格;而 VARCHAR 在写入、存储和读取时都会保留末尾的所有空格。这意味着:如果业务数据本身在末尾包含具有实质意义的空格,CHAR 类型会静默清除它们,造成数据失真。
3. 验证空格处理的代码示例
我们可以执行以下 SQL 语句,观察两者的行为差异:
-- 1. 创建测试表
CREATE TABLE demo_char_varchar (
  c_val CHAR(6),
  v_val VARCHAR(6)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

-- 2. 插入末尾带有空格的字符串 'A  '(A 后面跟 2 个空格)
INSERT INTO demo_char_varchar (c_val, v_val) VALUES ('A  ', 'A  ');

-- 3. 查看字符长度
SELECT
  c_val,
  CHAR_LENGTH(c_val) AS c_len,
  v_val,
  CHAR_LENGTH(v_val) AS v_len
FROM demo_char_varchar;
示例输出:
+-------+-------+-------+-------+
| c_val | c_len | v_val | v_len |
+-------+-------+-------+-------+
| A     |     1 | A     |     3 |
+-------+-------+-------+-------+查询结果表明,CHAR(6) 自动丢弃了末尾的空格,其 CHAR_LENGTH 仅为 1;而 VARCHAR(6) 完整保留了输入的 2 个空格,长度保持为 3。
二、FLOAT 与 DECIMAL:近似值与精确值的计算分野
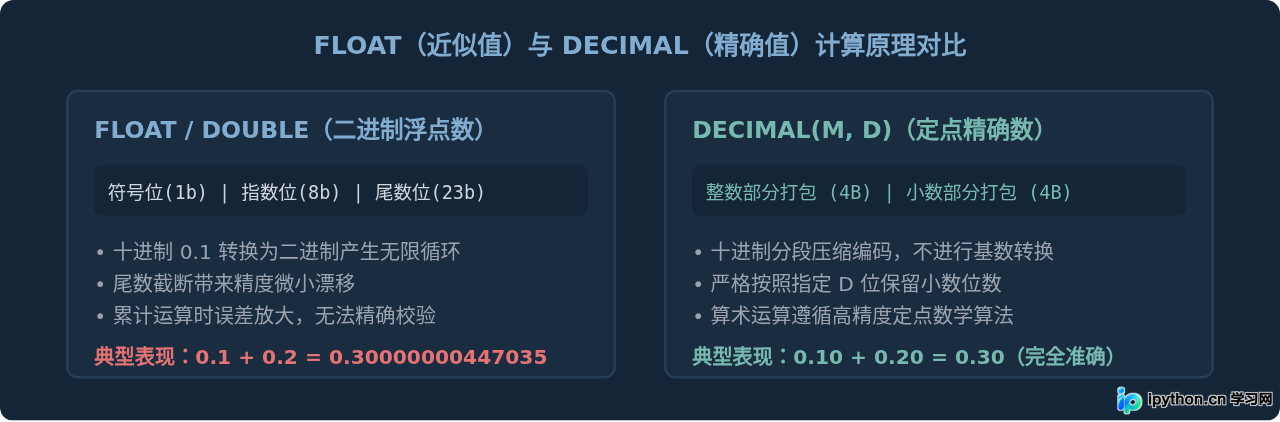
在数值处理上,FLOAT 与 DECIMAL 的核心差别是二进制浮点运算与定点数精确运算的区别。计算机以二进制表示十进制小数时,许多常见数字(如 0.1、0.7)都无法被有限的二进制位精确表示,只能通过无限循环逼近。
1. 底层存储机制
FLOAT 采用 IEEE 754 浮点标准,占用 4 个字节,通常提供约 7 位有效数字精度;DOUBLE 占用 8 个字节,提供约 15 位精度。由于采用科学计数法压缩存储符号、阶码和尾数,浮点数能够覆盖极大的数值范围,但本质是近似值。
DECIMAL(M, D) 属于定点数,在 MySQL 内部以紧凑的二进制打包格式分段存储数字的字符串表示,属于精确值。其中 M 表示总有效数字位数(最大 65),D 表示小数点后的位数(最大 30)。在存储上,MySQL 每 9 个十进制数字打包占用 4 个字节,剩余位根据数量占用 1 到 4 字节,计算时绝无浮点舍入漂移。
2. 精度差异演示
以下示例展示了 FLOAT 类型的累加误差以及精确等值匹配失效的问题:
-- 1. 创建精度对比测试表
CREATE TABLE demo_precision (
  f_val FLOAT,
  d_val DECIMAL(10, 2)
) ENGINE=InnoDB;

-- 2. 插入常见的小数值
INSERT INTO demo_precision VALUES (0.1, 0.10);
INSERT INTO demo_precision VALUES (0.2, 0.20);

-- 3. 统计求和并校验匹配
SELECT
  SUM(f_val) AS float_sum,
  SUM(d_val) AS decimal_sum,
  SUM(f_val) = 0.3 AS float_check,
  SUM(d_val) = 0.3 AS decimal_check
FROM demo_precision;
示例输出:
+--------------------+-------------+-------------+---------------+
| float_sum          | decimal_sum | float_check | decimal_check |
+--------------------+-------------+-------------+---------------+
| 0.3000000044703484 |        0.30 |           0 |             1 |
+--------------------+-------------+-------------+---------------+在上面的示例中,FLOAT 求和结果发生了精度溢出(0.3000000044703484),导致 SUM(f_val) = 0.3 返回布尔假 0;而 DECIMAL 始终保持严格的 0.30,等值比对返回布尔真 1。
三、核心类型参数与技术指标对比
下表归纳了四种数据类型的核心参数、最大容量限制及引擎层面的处理特性:
| 对比维度 | CHAR | VARCHAR | FLOAT | DECIMAL |
|---|---|---|---|---|
| 类型分类 | 定长字符 | 变长字符 | 近似单精度浮点 | 精确高精度定点 |
| 容量定义 | 0 ~ 255 字符 | 0 ~ 65,535 字节 | -3.40E+38 ~ 3.40E+38 | M 位数 ≤ 65,D 精度 ≤ 30 |
| 物理存储开销 | 分配固定 M 字符空间 | 实际字节数 + 1~2 字节 | 固定 4 字节 | 每 9 位数字占用 4 字节 |
| 末尾空格处理 | 读取时静默剔除 | 原样存储与读取 | 不适用 | 按 D 位数进行零补齐 |
| 计算吞吐开销 | 极低(无需变长寻址) | 低(需解析长度字节) | 极低(CPU 硬件级浮点指令) | 中等(软件层分段模拟计算) |
| 索引与碎片 | 更新不产生页裂变 | 字段长度变长可能导致页裂变 | 等值比对易漏命中 | 支持完全确定性等值与范围索引 |
四、字段选型决策流程与实战判断步骤
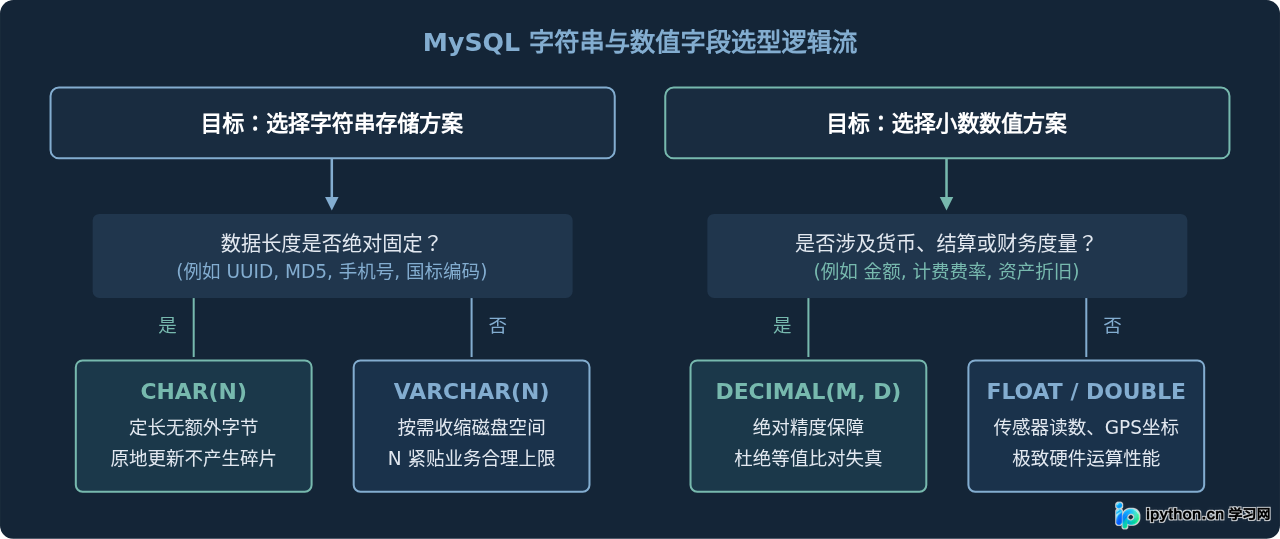
在具体业务建模时,类型选择应当兼顾“数据精度第一、检索效率均衡、物理存储合理”三个目标。可以遵循以下系统化判断流程:
实操建议与具体落地准则
-
哈希串与标识符优先选择
CHAR: MD5(32 位)、SHA-256(64 位)、UUID 标准去连字符串(32 位)等固定长度值,直接采用CHAR。由于定长分配,行内没有变长指针维护开销,更新字段时可以直接原地(In-Place)修改,不会诱发底层数据页裂变与行迁移。 -
长度不均或偏长文本必须使用
VARCHAR: 用户昵称、电子邮箱、商品标题等长度离散度大的属性,统一选用VARCHAR。但切忌盲目声明VARCHAR(255)。在临时表生成、内存排序(Filesort)阶段,MySQL 会按照声明的长度字符上限预分配定长内存缓冲区,过大的M会急剧浪费内存资源。 -
金融、计费与账户资产强制使用
DECIMAL: 所有账户余额、订单应付、优惠券抵扣、手续费等字段,必须使用定点数,推荐DECIMAL(18, 4)或DECIMAL(12, 2)。多保留 2 位(如保留 4 位小数)可以有效避免多笔拆单计算过程中的四舍五入累计失真。 -
海量科学计算与物联指标使用
FLOAT / DOUBLE: 工业网关采集的温度、湿度、气压、车辆瞬时速度及经纬度定位信息,本身来源于物理传感器的模拟转换,存在容错范围,且量级大、需频繁聚合。此时采用FLOAT能大幅节省存储空间并利用硬件 FPU 获得更高算力吞吐。
五、常见问题与注意事项
如果在代码中执行了类似
SELECT * FROM t WHERE float_col = 12.34; 的查询,可能会发现该记录明明存在却查不出来。原因在于 12.34 存入底层时实际是类似 12.34000015... 的近似值。如果非要在浮点列上进行比较,必须改用区间范围查询,例如:WHERE float_col BETWEEN (12.34 - 0.0001) AND (12.34 + 0.0001)。在涉及精确查找的场景中,直接转用 DECIMAL 才是根本解法。
若某个
VARCHAR 字段被频繁修改且长度经常剧烈增长(如从 5 个字扩写到 200 个字),可能导致 InnoDB 数据页原有空间不足,进而触发“行溢出”或“B+树页裂变”,引起额外的磁盘 I/O 开销。对于高频高并发更新的字段,如果长度范围可控,优先考虑定长 CHAR。
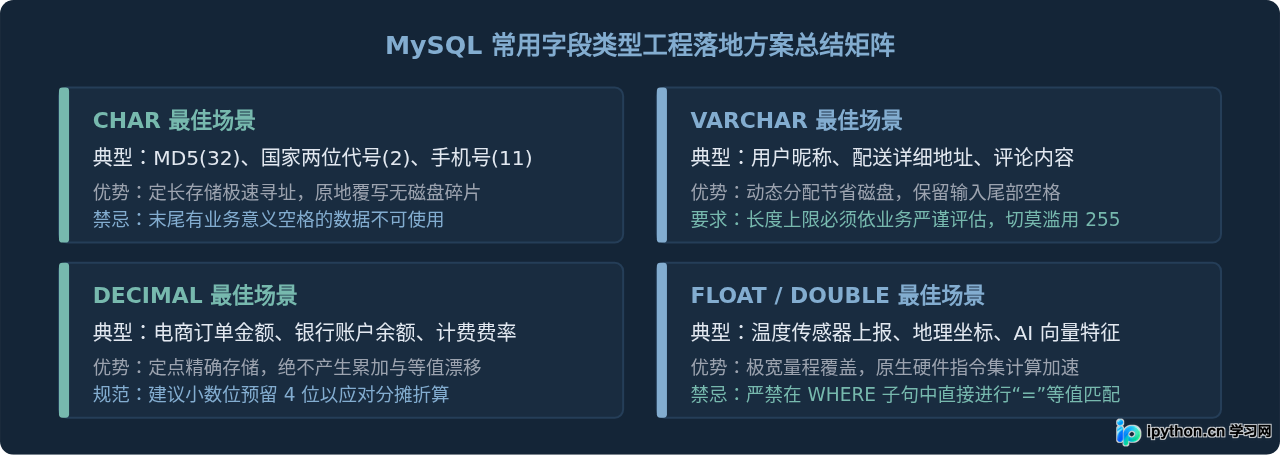
掌握 CHAR、VARCHAR、FLOAT 与 DECIMAL 的底层机制,不仅能让表结构更规整紧凑,更能从根源上避开偶发性精度丢失与性能抖动。在进行数据库设计评审时,参照上述判断步骤树与总结矩阵,便能在架构初期做出稳健的设计决策。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















