


Python文件操作基础与flush函数原理详解

本文详细解析Python文件操作的基本流程,包括打开、读写及关闭文件的标准步骤。重点讲解r、w、x、a等多种文件打开模式及其区别,并深入剖析flush函数的底层原理:通过强制将内存缓冲区数据写入硬盘,解决内存与硬盘速度差异导致的效率问题,确保数据实时持久化。
Python文件操作基本流程
首先需要执行打开文件的操作,获取文件句柄,并将其赋值给一个变量以便后续使用。
接着利用获取到的文件句柄,对文件执行具体的读写操作。
最后完成文件操作后,必须关闭文件以释放资源。
示例文件内容如下:
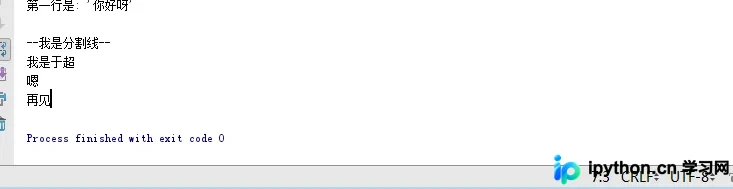
'你好呀' 我是于超 嗯 再见
文件操作的基本流程通常包含上述三个步骤。
f=open('chenli',encoding='utf-8') first_line=f.readline() print('第一行是:',first_line)
print('我是分割线'.center(9,'-')) #9代表字符串总共9长度 data=f.read() #读取所有内容 print(data)
#不指定打开编码,即python解释器默认编码,python2.*为ascii,python3.*为utf-8 f=open('chenli.txt') f.read()
f=open('chenli.txt',encoding='utf-8') f.read()
文件打开模式详解
2.3 文件打开模式
文件句柄 = open ('文件路径','模式')
在打开文件时,必须指定文件路径以及以何种方式打开。成功打开后即可获得该文件句柄,后续即可通过此句柄对文件进行各种操作。
常见的文件打开模式包括以下几种:
- r ,只读模式【默认模式,文件必须存在,不存在则抛出异常】
- w,只写模式【不可读;不存在则创建;存在则清空内容】
- x, 只写模式【不可读;不存在则创建,存在则报错】
- a, 追加模式【可读; 不存在则创建;存在则只追加内容】
"+" 表示可以同时读写某个文件
- r+, 读写【可读,可写】
- w+,写读【可读,可写】
- x+ ,写读【可读,可写】
- a+, 写读【可读,可写】
"b"表示以字节的方式操作
- rb 或 r+b
- wb 或 w+b
- xb 或 w+b
- ab 或 a+b
注:以b方式打开时,读取到的内容是字节类型,写入时也需要提供字节类型,不能指定编码
flush函数原理与内存缓冲区
2.4 文件内置函数flush
flush原理:
- 文件操作是通过软件将文件从硬盘读到内存
- 写入文件的操作也都是存入内存缓冲区buffer(内存速度快于硬盘,如果写入文件的数据都从内存刷到硬盘,内存与硬盘的速度延迟会被无限放大,效率变低,所以要刷到硬盘的数据我们统一往内存的一小块空间即buffer中放,一段时间后操作系统会将buffer中数据一次性刷到硬盘)
- flush即,强制将写入的数据刷到硬盘
滚动条:
import sys,time
for i in range(10):
  sys.stdout.write('#')
  sys.stdout.flush()
  time.sleep(0.2)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















