


Python实现喜马拉雅音频批量下载实战

发布时间:2026-10-14 |
5人浏览过
本文介绍如何使用Python编写脚本,从喜马拉雅网站抓取鬼故事专辑的音频文件。通过解析动态生成的JSON数据获取音频链接,并利用requests库实现批量下载保存为m4a格式。代码包含完整的请求头设置、URL解析及文件写入逻辑,适合初学者学习网络爬虫与文件处理。
Python抓取喜马拉雅音频实现
本节演示如何利用Python抓取喜马拉雅平台上的鬼故事音频资源。
import json  # 在这个url,音频链接为JSON动态生成,所以用到了json模块
import requests
headers = {
  "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.102 Safari/537.36"
}


# 请求网页
def open_url(url):
  r = requests.get(url, headers=headers)
  r.encoding = 'utf-8'
  html = r.text
  # 将JSON转化成字符串
  html = json.loads(html)
  return html


# 得到所有音频的链接
def get_urls(url):
  us = url['data']['tracksAudioPlay']
  return us


def main():
  num = 1
  url = 'https://www.ximalaya.com/revision/play/album?albumId=4256765&pageNum=1&sort=-1&pageSize=30'
  html = open_url(url)
  urls = get_urls(html)
  # 遍历得到每个音频的链接和对应的名称
  for ul in urls:
    uls = ul['src']
    filename = ul['trackName']
    reponse = requests.get(uls).content
    with open(filename + '.m4a', 'wb') as file:
      file.write(reponse)
    print(str(num) + '. ' + filename)
    num += 1

if __name__ == '__main__':
  main()
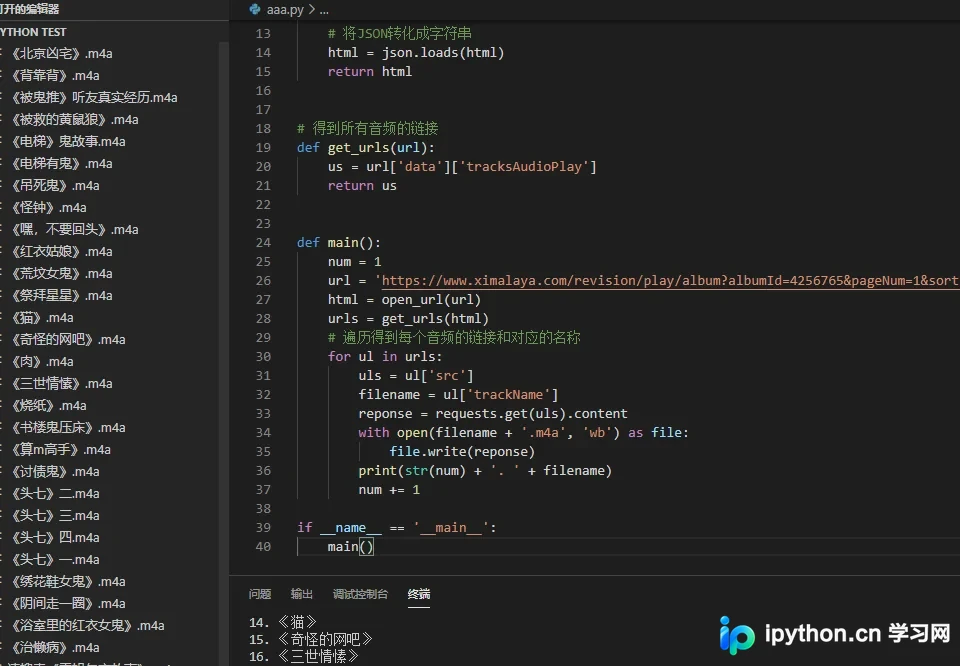
执行上述脚本后,即可在本地目录看到下载完成的音频文件列表。
以上即为使用Python实现音频批量下载的完整示例。如需了解更多Python爬虫相关技巧,欢迎查阅本站其他技术文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















