


Python jieba结巴分词原理及用法解析

发布时间:2026-10-15 |
2人浏览过
本文深入解析Python jieba库的三种分词模式(全模式、精简模式、搜索引擎模式),详解如何添加自定义词典以控制词语切分,并探讨基于隐马尔可夫模型(HMM)和Viterbi算法处理未登录词的底层原理。通过代码示例展示jieba在实际应用中的灵活配置与参数调整方法。
jieba分词概述
简要说明
jieba库支持三种不同的分词模式,并且具备繁体字识别能力,同时允许用户通过自定义词典来优化分词效果。
三种分词模式详解
三种分词模式
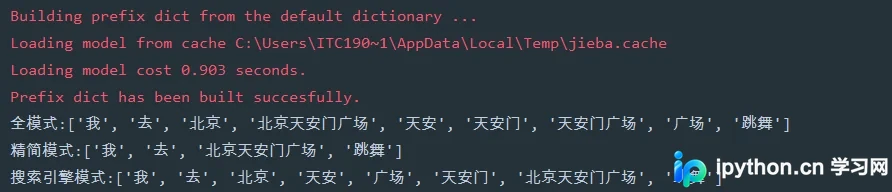
全模式:该模式会扫描句子中所有可能构成词语的片段,虽然执行速度极快,但无法有效解决词语切分中的歧义问题。
精简模式:此模式旨在输出最精确的分词结果,不会添加多余的词汇,其效果类似于对句子进行自然的断句处理。
搜索引擎模式:在精简模式的基础上,该模式会对长词进行进一步的二次切分,以更好地适应搜索引擎的检索需求。
# -*- encoding=utf-8 -*-

import jieba

if __name__ == '__main__':
  str1 = '我去北京天安门广场跳舞'
  a = jieba.lcut(str1, cut_all=True) # 全模式
  print('全模式:{}'.format(a))
  b = jieba.lcut(str1, cut_all=False) # 精简模式
  print('精简模式:{}'.format(b))
  c = jieba.lcut_for_search(str1) # 搜索引擎模式
  print('搜索引擎模式:{}'.format(c))
运行
自定义词典控制分词
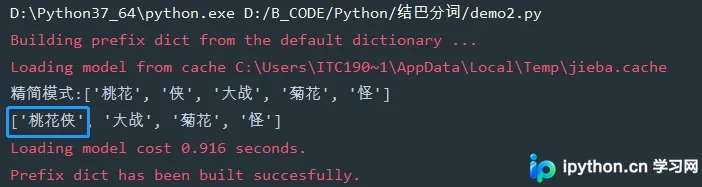
当遇到某些特定词语时,用户可能希望保持其完整性不被切分。
# -*- encoding=utf-8 -*-

import jieba

if __name__ == '__main__':
  str1 = '桃花侠大战菊花怪'
  b = jieba.lcut(str1, cut_all=False) # 精简模式
  print('精简模式:{}'.format(b))
  # 如果不把桃花侠分开
  jieba.add_word('桃花侠')
  d = jieba.lcut(str1) # 默认是精简模式
  print(d)
运行
HMM模型与未登录词处理
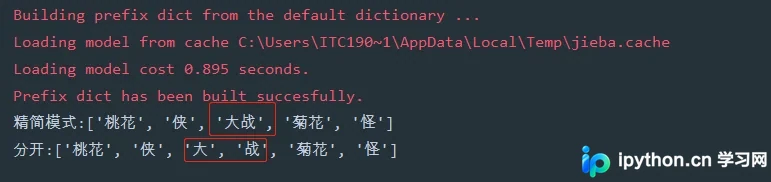
反之,如果希望强制将某个复合词拆分为更小的单元,可以通过调整词典频率来实现。
# -*- encoding=utf-8 -*-

import jieba

if __name__ == '__main__':
  # HMM参数,默认为True
  '''HMM 模型,即隐马尔可夫模型(Hidden Markov Model, HMM),是一种基于概率的统计分析模型,
  用来描述一个系统隐性状态的转移和隐性状态的表现概率。
  在 jieba 中,对于未登录到词库的词,使用了基于汉字成词能力的 HMM 模型和 Viterbi 算法,
  其大致原理是:
  采用四个隐含状态,分别表示为单字成词,词组的开头,词组的中间,词组的结尾。
  通过标注好的分词训练集,可以得到 HMM 的各个参数,然后使用 Viterbi 算法来解释测试集,得到分词结果。
  '''
  str1 = '桃花侠大战菊花怪'
  b = jieba.lcut(str1, cut_all=False, HMM=False) # 精简模式,且不使用HMM模型
  print('精简模式:{}'.format(b))
  # 分开大战为大和战
  jieba.suggest_freq(('大', '战'), True)
  e = jieba.lcut(str1, HMM=False) # 不使用HMM模型
  print('分开:{}'.format(e))
运行
以上内容涵盖了jieba分词的核心功能与使用方法,希望能为读者提供有价值的参考,欢迎继续支持本站获取更多技术资讯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















