Python jieba库中文分词原理与三种模式实战详解
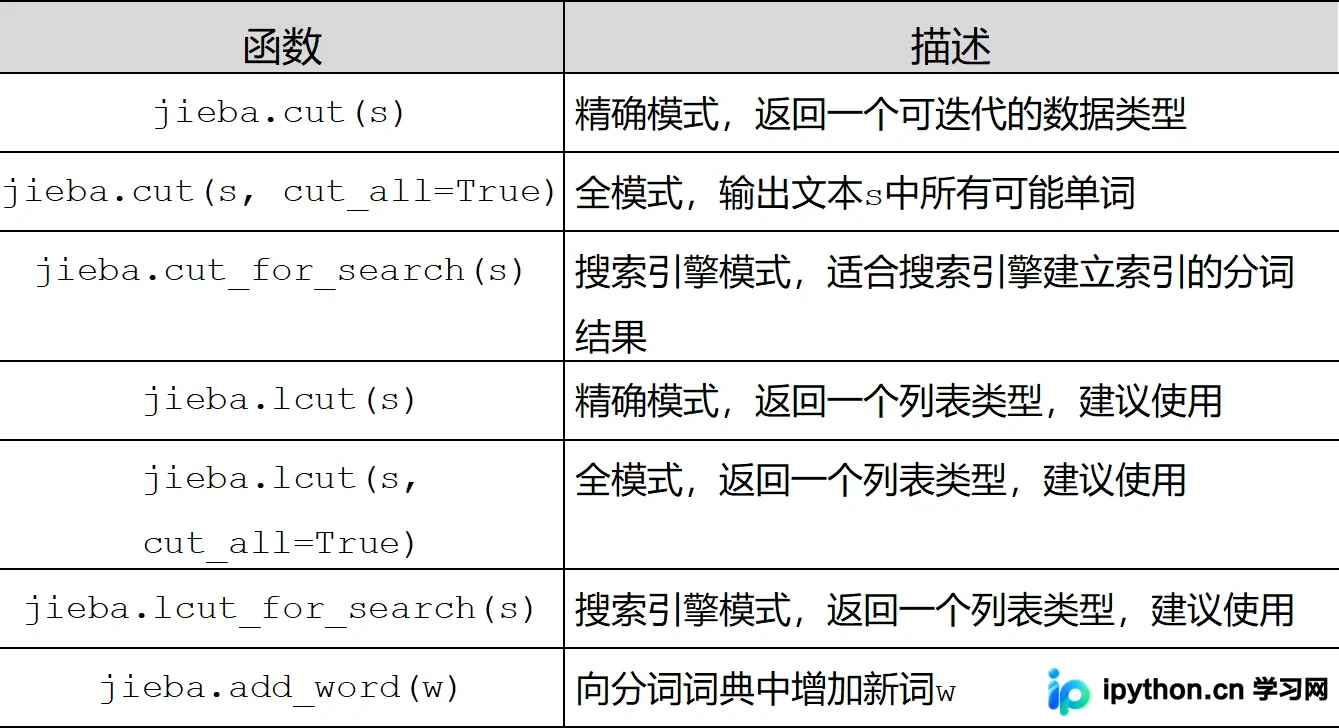
本文详解Python jieba库的中文分词原理,介绍基于词库与动态规划的算法机制。重点解析精确模式、全模式及搜索引擎模式的区别与适用场景,并通过jieba.lcut等常用函数展示代码实操,涵盖安装、自定义新词及不同模式下的分词效果对比。
10-15
4




本文详解Python jieba库的中文分词原理,介绍基于词库与动态规划的算法机制。重点解析精确模式、全模式及搜索引擎模式的区别与适用场景,并通过jieba.lcut等常用函数展示代码实操,涵盖安装、自定义新词及不同模式下的分词效果对比。
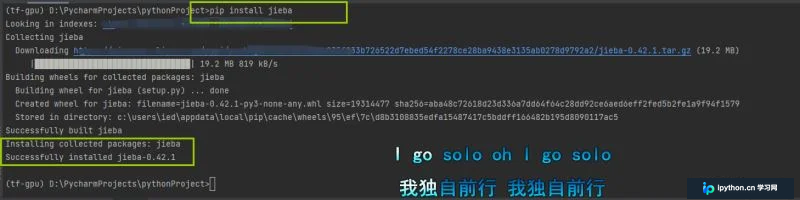
本文深入解析Python jieba库的三种分词模式(全模式、精简模式、搜索引擎模式),详解如何添加自定义词典以控制词语切分,并探讨基于隐马尔可夫模型(HMM)和Viterbi算法处理未登录词的底层原理。通过代码示例展示jieba在实际应用中的灵活配置与参数调整方法。
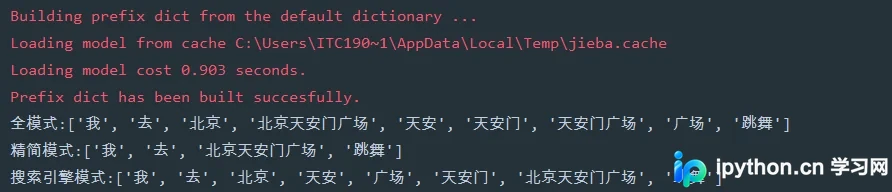
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
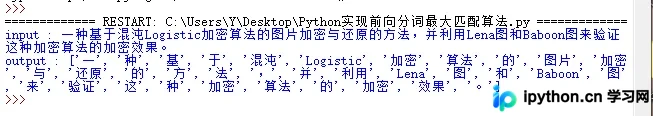
本文详细介绍基于词表的中文分词方法,重点讲解前向最大匹配算法的原理与Python实现。通过定义最大词长、递归匹配字典及主循环处理,演示如何对包含英文、数字及特定术语的中文句子进行有效分词,并提供完整代码供参考。
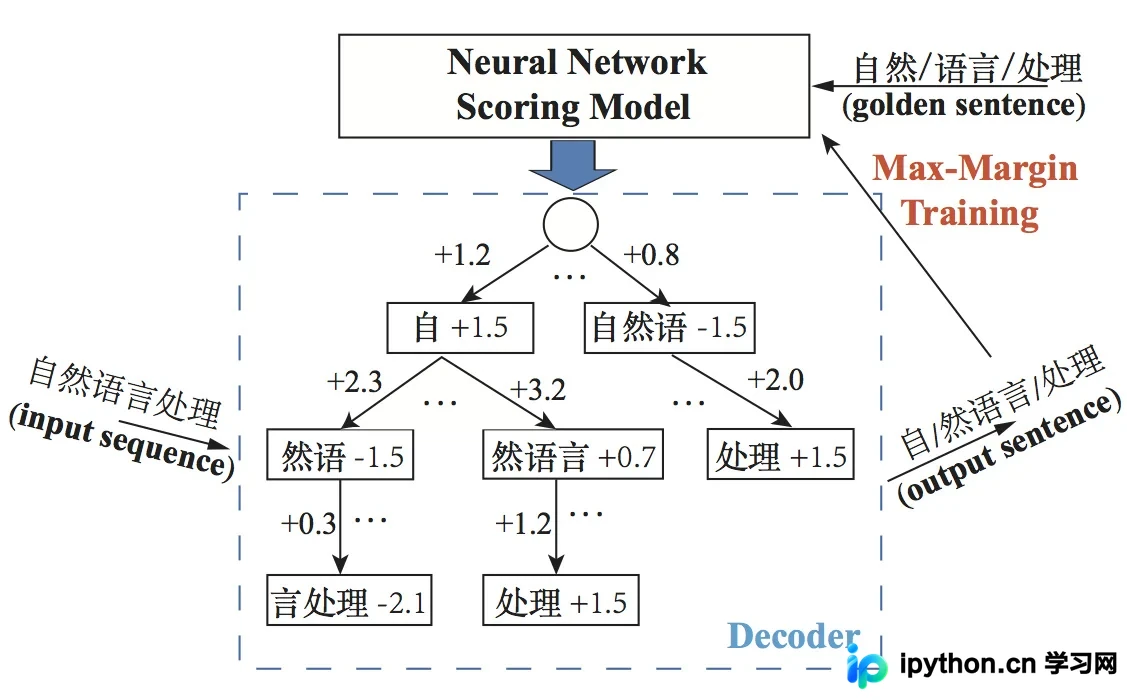
本文对比分析Python中常用的中文分词库jieba与pkuseg。详细讲解jieba的三种分词模式、自定义词典及停用词处理,并介绍pkuseg的多领域预训练模型优势。通过京东评论数据实例,对比两者在分词准确率与执行速度上的表现,为不同场景下的分词工具选择提供参考。
本文详细介绍Python中优秀的中文分词第三方库jieba。解析其基于中文词库的分词原理,对比精确模式、全模式和搜索引擎模式三种分词方式的区别。通过统计《三国演义》人物出场次数的完整代码示例,展示jieba在实际文本处理中的应用,帮助开发者掌握分词技巧与数据处理流程。
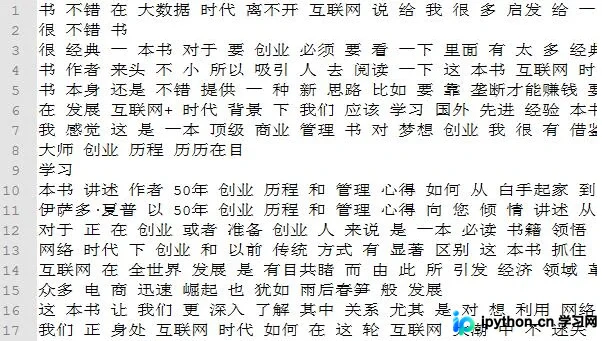
本文详解如何利用Python Gensim库中的Word2Vec模型处理中文语料。内容涵盖语料收集、中文分词工具选择(如结巴、LTP)、模型训练参数设置及相似度计算。通过亚马逊书评数据示例,展示如何计算词语关联度、查找相关词及识别异常词,并提供完整的代码实现与结果分析。
本文介绍Python中过滤字母、数字及特殊符号的多种实现方式,涵盖filter内置方法、正则表达式re模块及isnumeric等字符串处理技巧,适用于中文分词前的数据清洗场景。
本文详解如何利用Python的aiml库搭建基于AIML协议的聊天机器人。内容涵盖库安装、语料库加载、自定义AIML文件编写、会话管理与断言机制,以及Brain加速加载技巧。针对中文AI应用难点,分析了规则库匮乏与分词问题,并提供了jieba分词及开源项目等解决方案,帮助开发者快速构建智能对话系统。
本文介绍如何使用Python的jieba库进行中文分词,涵盖精确模式、全模式和搜索引擎模式三种用法。通过示例代码演示如何结合停用词表过滤无意义词汇,实现高效的文本预处理流程,适用于NLP基础场景。
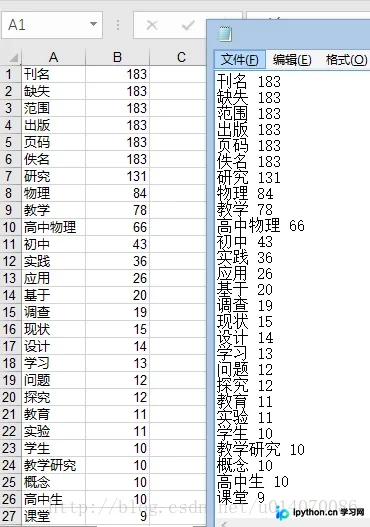
本文介绍如何利用Python的jieba库对中文论文题目进行分词与词频统计。通过安装jieba和xlwt库,读取文本文件后提取关键词并计算频率,最终将结果分别保存为txt和xls格式文件,适用于学术数据处理场景。
本文详细解析自然语言处理中基础的中文分词算法——前向最大匹配法。通过设定最大词长,从左至右扫描文本并与词典比对,逐步缩短候选子串直至匹配成功或转为单字。文章提供了完整的Python代码示例,演示如何读取输入文件与词典,并输出分词结果,适合NLP初学者参考学习。



