


PhantomJS加载网页并截图的实战方法

本文介绍PhantomJS加载网页并保存为图片的实例方法。通过创建webpage对象调用open方法加载指定URL,判断响应状态成功后使用render方法生成截图。适用于需要批量处理网页快照或进行页面测试的场景,提供完整的JavaScript代码示例及命令行执行步骤。
PhantomJS页面加载与截图概述
PhantomJS作为常用的页面获取工具,此前我们已探讨过页面测试、代码评估及屏幕捕获等应用场景。其中,网页内容的抓取与处理尤为关键,此处不再赘述。本文将重点介绍一种较为小众但实用的PhantomJS页面加载技巧,许多开发者可能尚未掌握这一用法。该方法在实际操作中十分常见,接下来我们将深入探讨具体实现过程。
借助PhantomJS可以实现网页页面的加载操作,以下示例展示了如何将加载后的页面保存为图片文件。
核心代码实现与执行步骤
var page = require('webpage').create();
page.open('http://cuiqingcai.com', function (status) {
    console.log("Status: " + status);
    if (status === "success") {
        page.render('example.png');
    }
    phantom.exit();
});
首先,需要实例化一个webpage对象,随后利用该对象加载目标站点的主页。在代码中需判断网络请求的响应状态,若状态为成功,则执行截图保存操作,将结果存储为example.png文件。该段代码通常被保存为pageload.js,并通过命令行工具执行。
phantomjs pageload.js执行结果显示操作成功,在当前目录下生成了名为example.png的图片文件。
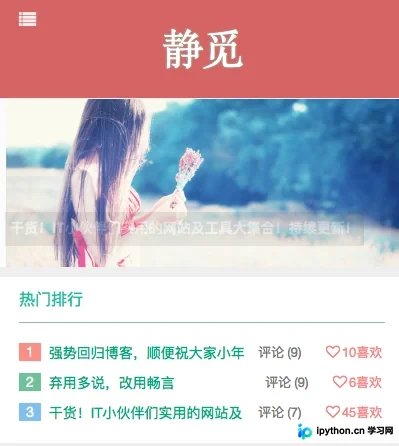
由于PhantomJS内置了render方法,因此在网页截图场景中,PhantomJS被广泛使用。
至此,关于Python爬虫中PhantomJS加载页面的实例方法介绍完毕。如需了解更多相关技术细节,建议查阅本站往期文章或继续阅读后续内容。感谢大家的支持与关注!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















