


Python 爬虫实现百度翻译:绕过反爬机制与代码详解

本文详解如何使用 Python 爬虫调用百度翻译接口。通过浏览器开发者工具定位 v2transapi 接口,获取 Cookie 和 Token 以通过基础验证。重点解析由 JS 算法生成的 Sign 参数,利用 Python 的 execjs 库执行 JS 代码动态生成签名,从而绕过百度翻译的反爬限制,实现稳定的文本翻译功能。
环境配置与前言
环境
| python版本号 | 系统 | 游览器 |
|---|---|---|
| python 3.7.2 | win7 | google chrome |
关于本文
本文演示如何利用爬虫技术调用百度翻译接口。文中提供的代码仅供技术学习与研究,严禁用于任何商业用途。如需商业使用,请前往 api.fanyi.baidu.com 购买官方付费 API。若涉及侵权,将立即删除相关内容!
实现思路与反爬机制分析
实现思路
整个流程的核心在于定位网站内部隐藏的免费 API 接口。我们需要构造符合要求的请求参数并发送 POST 请求,随后解析返回的 JSON 数据,从中提取出对应的翻译结果。
百度翻译的反爬机制
- 由 js 算法生成的 sign
- cookie 检测
- token 暗号
定位隐藏 API 接口
在网站文件中找到隐藏的免费 api
首先打开百度翻译页面,输入任意待翻译文本。当翻译结果加载完成后,按下 F12 键打开开发者工具,切换到 NETWORK(网络)选项卡,并筛选 XHR 类型请求。此时页面文件已加载完毕,建议按 F5 刷新页面以捕获完整的网络请求。
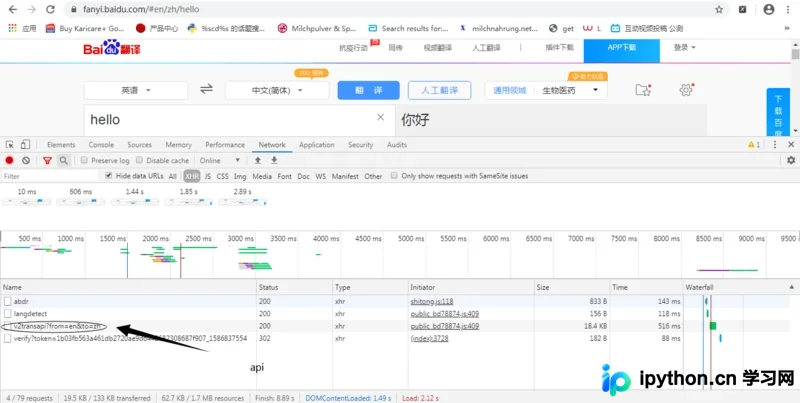
刷新后,在请求列表中即可发现以 v2transapi? 开头的文件,这正是我们要调用的 API 接口。点击该请求进入 Preview(预览)标签页,若能在返回的 JSON 数据中看到翻译结果,则验证成功。此外,我们还需要记录 Cookie 和 Token 的位置,这两者在后续绕过反爬机制时将发挥关键作用。
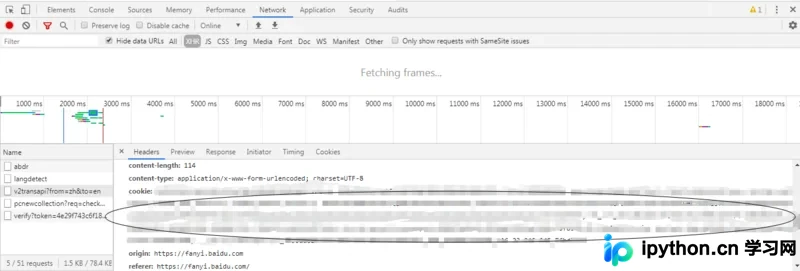
token 位置:
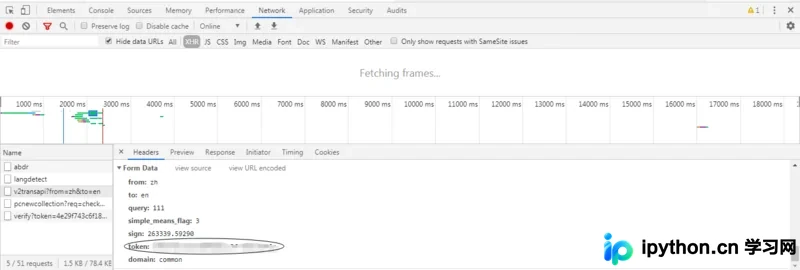
api 信息
接口地址:https://fanyi.baidu.com/v2transapi 请求方式:POST
请求参数大全
| 参数 | 介绍 |
|---|---|
| from | 源语言 |
| to | 目标语言 |
| query | 翻译文本 |
| sign | 由js算法生成的签名(反爬) |
| token | 请求暗号 |
Python 代码实现与反爬处理
开始写代码
导入 request 和 execjs 库
import requests
import execjs- requests HTTP 库,用于发送网络爬虫请求
- execjs 用于在 Python 环境中调用 JS 代码
反反爬虫
鉴于百度翻译存在 Cookie 识别的反爬机制,我们需要在请求头中设置之前获取的 Cookie,以此伪装网络爬虫的身份,通过基础验证。
headers = {'cookie':'请在这里输入你的cookie'}同时,我们还需要配置 Token(即请求暗号)。
token = '请在这里放置你的token'最后需要解决的是 Sign 反爬机制。Sign 是通过特定的 JS 算法对译文生成的签名。经过检索,找到了对应的 JS 算法实现,现分享如下。
var i = "320305.131321201"
function n(r, o) {
  for (var t = 0; t < o.length - 2; t += 3) {
    var a = o.charAt(t + 2);
    a = a >= "a" ? a.charCodeAt(0) - 87 : Number(a), a = "+" === o.charAt(t + 1) ? r >>> a : r << a, r = "+" === o.charAt(t) ? r + a & 4294967295 : r ^ a
  }
  return r
}


function e(r) {
  var o = r.match(/[\uD800-\uDBFF][\uDC00-\uDFFF]/g);
  if (null === o) {
    var t = r.length;
    t > 30 && (r = "" + r.substr(0, 10) + r.substr(Math.floor(t / 2) - 5, 10) + r.substr(-10, 10))
  } else {
    for (var e = r.split(/[\uD800-\uDBFF][\uDC00-\uDFFF]/), C = 0, h = e.length, f = []; h > C; C++) "" !== e[C] && f.push.apply(f, a(e[C].split(""))), C !== h - 1 && f.push(o[C]);
    var g = f.length;
    g > 30 && (r = f.slice(0, 10).join("") + f.slice(Math.floor(g / 2) - 5, Math.floor(g / 2) + 5).join("") + f.slice(-10).join(""))
  }
  var u = void 0, l = "" + String.fromCharCode(103) + String.fromCharCode(116) + String.fromCharCode(107);
  u = null !== i ? i : (i = window[l] || "") || "";
  for (var d = u.split("."), m = Number(d[0]) || 0, s = Number(d[1]) || 0, S = [], c = 0, v = 0; v < r.length; v++) {
    var A = r.charCodeAt(v);
    128 > A ? S[c++] = A : (2048 > A ? S[c++] = A >> 6 | 192 : (55296 === (64512 & A) && v + 1 < r.length && 56320 === (64512 & r.charCodeAt(v + 1)) ? (A = 65536 + ((1023 & A) << 10) + (1023 & r.charCodeAt(++v)), S[c++] = A >> 18 | 240, S[c++] = A >> 12 & 63 | 128) : S[c++] = A >> 12 | 224, S[c++] = A >> 6 & 63 | 128), S[c++] = 63 & A | 128)
  }
  for (var p = m, F = "" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(97) + ("" + String.fromCharCode(94) + String.fromCharCode(43) + String.fromCharCode(54)), D = "" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(51) + ("" + String.fromCharCode(94) + String.fromCharCode(43) + String.fromCharCode(98)) + ("" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(102)), b = 0; b < S.length; b++) p += S[b], p = n(p, F);
  return p = n(p, D), p ^= s, 0 > p && (p = (2147483647 & p) + 2147483648), p %= 1e6, p.toString() + "." + (p ^ m)
}
既然我们使用的是 Python 进行爬虫开发,如何处理 JS 代码呢?Python 拥有强大的第三方库生态,其中 execjs 库便是专门用于调用 JS 代码的工具。尽管市面上有多种调用方式,但 execjs 因其简洁性和功能完整性,是本文推荐的首选方案。
在调用 JS 算法之前,我们需要先获取用户输入的待翻译文本。
q = input('翻译:')随后,利用 execjs 的 compile 和 call 方法即可计算出所需的 Sign 值。
js = '''var i = "320305.131321201"
function n(r, o) {
  for (var t = 0; t < o.length - 2; t += 3) {
    var a = o.charAt(t + 2);
    a = a >= "a" ? a.charCodeAt(0) - 87 : Number(a), a = "+" === o.charAt(t + 1) ? r >>> a : r << a, r = "+" === o.charAt(t) ? r + a & 4294967295 : r ^ a
  }
  return r
}


function e(r) {
  var o = r.match(/[\uD800-\uDBFF][\uDC00-\uDFFF]/g);
  if (null === o) {
    var t = r.length;
    t > 30 && (r = "" + r.substr(0, 10) + r.substr(Math.floor(t / 2) - 5, 10) + r.substr(-10, 10))
  } else {
    for (var e = r.split(/[\uD800-\uDBFF][\uDC00-\uDFFF]/), C = 0, h = e.length, f = []; h > C; C++) "" !== e[C] && f.push.apply(f, a(e[C].split(""))), C !== h - 1 && f.push(o[C]);
    var g = f.length;
    g > 30 && (r = f.slice(0, 10).join("") + f.slice(Math.floor(g / 2) - 5, Math.floor(g / 2) + 5).join("") + f.slice(-10).join(""))
  }
  var u = void 0, l = "" + String.fromCharCode(103) + String.fromCharCode(116) + String.fromCharCode(107);
  u = null !== i ? i : (i = window[l] || "") || "";
  for (var d = u.split("."), m = Number(d[0]) || 0, s = Number(d[1]) || 0, S = [], c = 0, v = 0; v < r.length; v++) {
    var A = r.charCodeAt(v);
    128 > A ? S[c++] = A : (2048 > A ? S[c++] = A >> 6 | 192 : (55296 === (64512 & A) && v + 1 < r.length && 56320 === (64512 & r.charCodeAt(v + 1)) ? (A = 65536 + ((1023 & A) << 10) + (1023 & r.charCodeAt(++v)), S[c++] = A >> 18 | 240, S[c++] = A >> 12 & 63 | 128) : S[c++] = A >> 12 | 224, S[c++] = A >> 6 & 63 | 128), S[c++] = 63 & A | 128)
  }
  for (var p = m, F = "" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(97) + ("" + String.fromCharCode(94) + String.fromCharCode(43) + String.fromCharCode(54)), D = "" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(51) + ("" + String.fromCharCode(94) + String.fromCharCode(43) + String.fromCharCode(98)) + ("" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(102)), b = 0; b < S.length; b++) p += S[b], p = n(p, F);
  return p = n(p, D), p ^= s, 0 > p && (p = (2147483647 & p) + 2147483648), p %= 1e6, p.toString() + "." + (p ^ m)
}
'''
sign = execjs.compile(js).call("e",q)
(以上代码获取了 sign)
完成上述反爬参数的准备后,我们可以设置“源语言”和“目标语言”这两个最终参数。
From = 'en'
To = 'zh'
(以上代码代表英译中,若需进行其他语言翻译,请输入对应的语言英文缩写,具体对应表见本文末尾) 接下来,构建用于请求的 JSON 数据对象。
data = {'from':From,
'to':To,
'query':q,
'sign':sign,
'token':'14b5f31e3c65d89a0b1c3f756e53942e'}
最后,发送数据请求并打印返回结果。
text = requests.post(url,headers=headers,data=data).json()
print(text)
观察打印结果可知,返回的是一个 JSON 字典对象。由于我们仅需翻译文本,因此可以通过索引定位到具体结果字段并输出。
text = requests.post(url,headers=headers,data=data).json()['trans_result']['data'][0]['dst']
print(text)
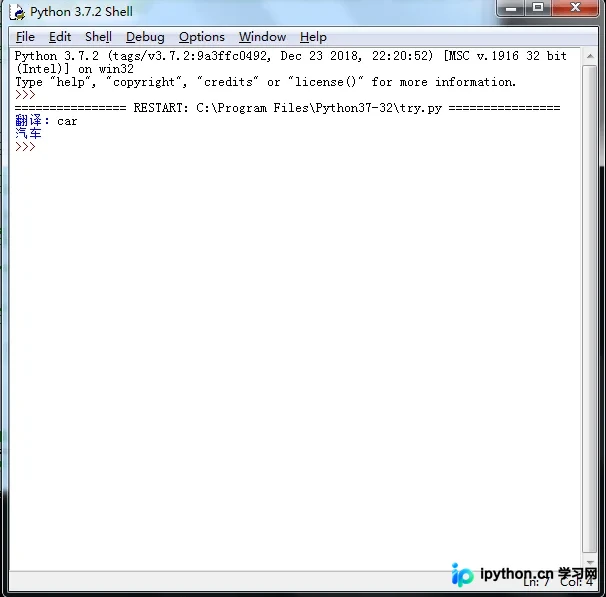
运行结果:
完整代码:
import requests
import execjs
url = 'https://fanyi.baidu.com/v2transapi'
headers = {'cookie':'你的cookie'}
js = '''var i = "320305.131321201"
function n(r, o) {
  for (var t = 0; t < o.length - 2; t += 3) {
    var a = o.charAt(t + 2);
    a = a >= "a" ? a.charCodeAt(0) - 87 : Number(a), a = "+" === o.charAt(t + 1) ? r >>> a : r << a, r = "+" === o.charAt(t) ? r + a & 4294967295 : r ^ a
  }
  return r
}


function e(r) {
  var o = r.match(/[\uD800-\uDBFF][\uDC00-\uDFFF]/g);
  if (null === o) {
    var t = r.length;
    t > 30 && (r = "" + r.substr(0, 10) + r.substr(Math.floor(t / 2) - 5, 10) + r.substr(-10, 10))
  } else {
    for (var e = r.split(/[\uD800-\uDBFF][\uDC00-\uDFFF]/), C = 0, h = e.length, f = []; h > C; C++) "" !== e[C] && f.push.apply(f, a(e[C].split(""))), C !== h - 1 && f.push(o[C]);
    var g = f.length;
    g > 30 && (r = f.slice(0, 10).join("") + f.slice(Math.floor(g / 2) - 5, Math.floor(g / 2) + 5).join("") + f.slice(-10).join(""))
  }
  var u = void 0, l = "" + String.fromCharCode(103) + String.fromCharCode(116) + String.fromCharCode(107);
  u = null !== i ? i : (i = window[l] || "") || "";
  for (var d = u.split("."), m = Number(d[0]) || 0, s = Number(d[1]) || 0, S = [], c = 0, v = 0; v < r.length; v++) {
    var A = r.charCodeAt(v);
    128 > A ? S[c++] = A : (2048 > A ? S[c++] = A >> 6 | 192 : (55296 === (64512 & A) && v + 1 < r.length && 56320 === (64512 & r.charCodeAt(v + 1)) ? (A = 65536 + ((1023 & A) << 10) + (1023 & r.charCodeAt(++v)), S[c++] = A >> 18 | 240, S[c++] = A >> 12 & 63 | 128) : S[c++] = A >> 12 | 224, S[c++] = A >> 6 & 63 | 128), S[c++] = 63 & A | 128)
  }
  for (var p = m, F = "" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(97) + ("" + String.fromCharCode(94) + String.fromCharCode(43) + String.fromCharCode(54)), D = "" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(51) + ("" + String.fromCharCode(94) + String.fromCharCode(43) + String.fromCharCode(98)) + ("" + String.fromCharCode(43) + String.fromCharCode(45) + String.fromCharCode(102)), b = 0; b < S.length; b++) p += S[b], p = n(p, F);
  return p = n(p, D), p ^= s, 0 > p && (p = (2147483647 & p) + 2147483648), p %= 1e6, p.toString() + "." + (p ^ m)
}
'''

From = '源语言'
To = '目标语言'
token = '你的token'
q = input('翻译:')
sign = execjs.compile(js).call("e",q)
data = {'from':From,
'to':To,
'query':q,
'sign':sign,
'token':token}


text = requests.post(url,headers=headers,data=data).json()['trans_result']['data'][0]['dst']
print(text)
语言英文缩写对应表
{
        'zh': '中文','jp': '日语','jpka': '日语假名','th': '泰语','fra': '法语','en': '英语','spa': '西班牙语','kor': '韩语','tr': '土耳其语','vie': '越南语','ms': '马来语','de': '德语','ru': '俄语','ir': '伊朗语','ara': '阿拉伯语','est': '爱沙尼亚语','be': '白俄罗斯语','bul': '保加利亚语','hi': '印地语','is': '冰岛语','pl': '波兰语','fa': '波斯语','dan': '丹麦语','tl': '菲律宾语','fin': '芬兰语','nl': '荷兰语','ca': '加泰罗尼亚语','cs': '捷克语','hr': '克罗地亚语','lv': '拉脱维亚语','lt': '立陶宛语','rom': '罗马尼亚语','af': '南非语','no': '挪威语','pt_BR': '巴西语','pt': '葡萄牙语','swe': '瑞典语','sr': '塞尔维亚语','eo': '世界语','sk': '斯洛伐克语','slo': '斯洛文尼亚语','sw': '斯瓦希里语','uk': '乌克兰语','iw': '希伯来语','el': '希腊语','hu': '匈牙利语','hy': '亚美尼亚语','it': '意大利语','id': '印尼语','sq': '阿尔巴尼亚语','am': '阿姆哈拉语','as': '阿萨姆语','az': '阿塞拜疆语','eu': '巴斯克语','bn': '孟加拉语','bs': '波斯尼亚语','gl': '加利西亚语','ka': '格鲁吉亚语','gu': '古吉拉特语','ha': '豪萨语','ig': '伊博语','iu': '因纽特语','ga': '爱尔兰语','zu': '祖鲁语','kn': '卡纳达语','kk': '哈萨克语','ky': '吉尔吉斯语','lb': '卢森堡语','mk': '马其顿语','mt': '马耳他语','mi': '毛利语','mr': '马拉提语','ne': '尼泊尔语','or': '奥利亚语','pa': '旁遮普语','qu': '凯楚亚语','tn': '塞茨瓦纳语','si': '僧加罗语','ta': '泰米尔语','tt': '塔塔尔语','te': '泰卢固语','ur': '乌尔都语','uz': '乌兹别克语','cy': '威尔士语','yo': '约鲁巴语','yue': '粤语','wyw': '文言文','cht': '中文繁体'  }
以上就是 python 爬虫如何实现百度翻译的详细内容,更多关于 python 爬虫实现百度翻译的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















