


Python数据结构入门:列表、字典与集合的高效用法

Python 中最常用的三种内置数据结构是列表 list、字典 dict 和集合 set。
它们看起来都能“保存一批数据”,但解决的问题并不相同:列表适合保存有顺序的数据,字典适合通过键快速找到对应值,集合则特别适合去重和成员判断。
真正用好它们,重点不是记住所有方法,而是先判断数据之间是什么关系,再选择合适的结构。
一、先理解列表、字典和集合分别解决什么问题
可以先从三个很常见的需求理解它们。
- 保存用户最近浏览过的文章,并保持浏览顺序:使用列表。
- 根据用户名查找用户资料:使用字典。
- 判断某个标签是否已经存在,或者删除重复标签:使用集合。
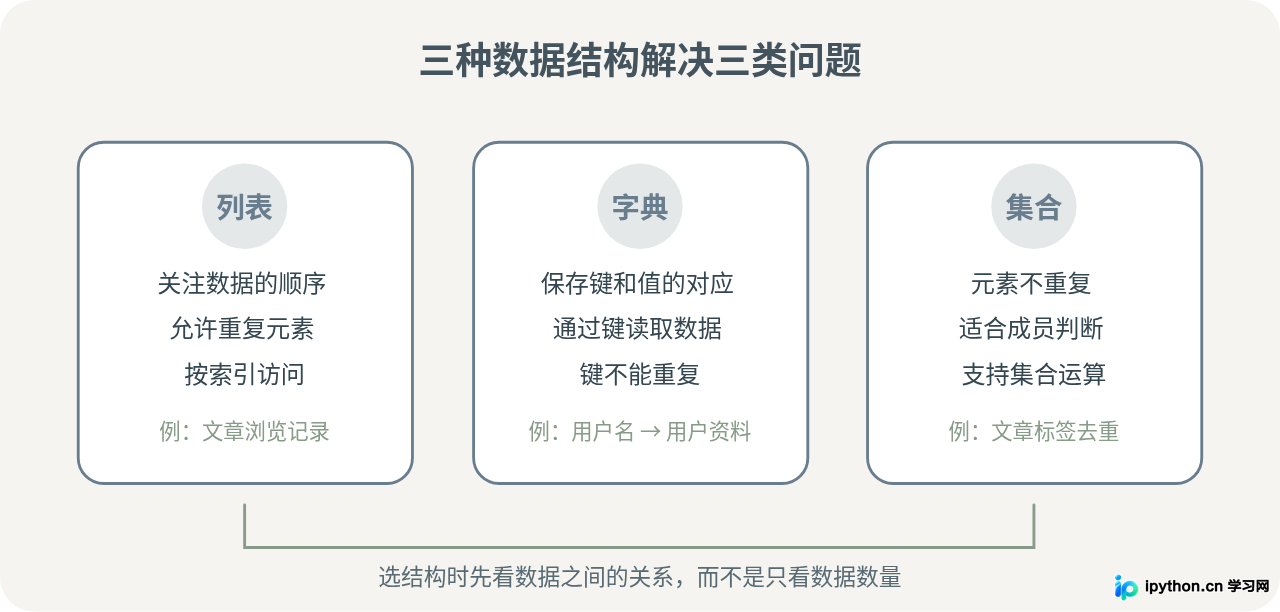
| 数据结构 | 写法示例 | 主要特点 | 典型场景 |
|---|---|---|---|
| 列表 list | ["Python", "PHP", "Java"] |
有顺序,可以重复,可按索引访问 | 步骤、记录、商品列表、文章列表 |
| 字典 dict | {"name": "Tom", "age": 20} |
一个键对应一个值,通过键读取 | 配置、用户信息、数据映射 |
| 集合 set | {"Python", "PHP", "Java"} |
元素唯一,适合判断成员和集合运算 | 去重、权限判断、标签比较 |
二、列表:处理有顺序的一组数据
列表适合处理“第一个、第二个、下一个”这类有顺序关系的数据。 列表中的元素可以重复,也可以随时增加、删除或修改。
1. 创建和读取列表
假设要保存一组正在学习的编程语言:
languages = ["Python", "Java", "PHP"]

print(languages[0])
print(languages[1])
print(languages[-1])
示例输出:
Python
Java
PHP
列表索引从 0 开始,因此 languages[0] 表示第一个元素。
负数索引从末尾开始计算,-1 就是最后一个元素。
2. 添加、修改和删除元素
languages = ["Python", "Java"]

# 在末尾增加一个元素
languages.append("PHP")

# 修改第二个元素
languages[1] = "Go"

# 删除指定元素
languages.remove("PHP")

print(languages)
示例输出:
['Python', 'Go']
append() 是添加单个元素时最常见的写法。
如果需要一次加入多个元素,可以使用 extend():
languages = ["Python", "Java"]
languages.extend(["PHP", "Go"])

print(languages)
示例输出:
['Python', 'Java', 'PHP', 'Go']append(["PHP", "Go"]) 会把整个列表作为一个元素加入;
extend(["PHP", "Go"]) 才会把两个字符串分别加入原列表。
3. 使用列表推导式完成简单转换
当需求是“遍历一个列表,把每个元素按照相同规则转换后组成新列表”时,列表推导式通常比手工创建空列表更加紧凑。
numbers = [1, 2, 3, 4, 5]

squares = [number * number for number in numbers]

print(squares)
示例输出:
[1, 4, 9, 16, 25]还可以加入条件:
numbers = [1, 2, 3, 4, 5, 6]

even_numbers = [number for number in numbers if number % 2 == 0]

print(even_numbers)
示例输出:
[2, 4, 6]
不过,推导式适合规则比较简单的转换。如果条件很多、嵌套层次较深,普通的 for 循环往往更容易阅读。
“代码更短”并不等于“代码更高效”。
三、字典:通过键快速找到对应的数据
如果数据不是单纯排成一列,而是存在明确的“名称 → 值”关系,字典通常比列表更合适。 例如一个用户包含姓名、年龄和所学语言,这些值都有自己的字段名称。
user = {
    "name": "Tom",
    "age": 20,
    "language": "Python"
}

print(user["name"])
print(user["language"])
示例输出:
Tom
Python
1. 修改和增加键值
user = {
    "name": "Tom",
    "age": 20
}

user["age"] = 21
user["language"] = "Python"

print(user)
示例输出:
{'name': 'Tom', 'age': 21, 'language': 'Python'}如果键已经存在,赋值会修改原值;如果键不存在,则会创建新的键值对。
2. 读取可能不存在的键时使用 get()
直接读取不存在的键会产生 KeyError:
user = {"name": "Tom"}

print(user["email"])
如果一个字段本来就可能缺失,可以改用 get():
user = {"name": "Tom"}

email = user.get("email", "未填写")
print(email)
示例输出:
未填写
这里第二个参数表示默认值。只有当业务上允许字段不存在时,才适合这样处理。
如果某个键按设计必须存在,直接使用 user["name"] 反而可以让错误更早暴露。
3. 遍历字典时同时取得键和值
user = {
    "name": "Tom",
    "age": 20,
    "language": "Python"
}

for key, value in user.items():
    print(key, value)
示例输出:
name Tom
age 20
language Python
如果只需要键,可以直接遍历字典;需要键和值时,使用 items() 更清楚。
4. 用字典统计出现次数
字典还很适合做计数。下面统计一组语言名称出现了多少次:
languages = ["Python", "PHP", "Python", "Java", "Python", "PHP"]

counts = {}

for language in languages:
    counts[language] = counts.get(language, 0) + 1

print(counts)
示例输出:
{'Python': 3, 'PHP': 2, 'Java': 1}这里的关键不是字典本身有“计数功能”,而是每一种语言都可以作为键,对应的值保存出现次数。
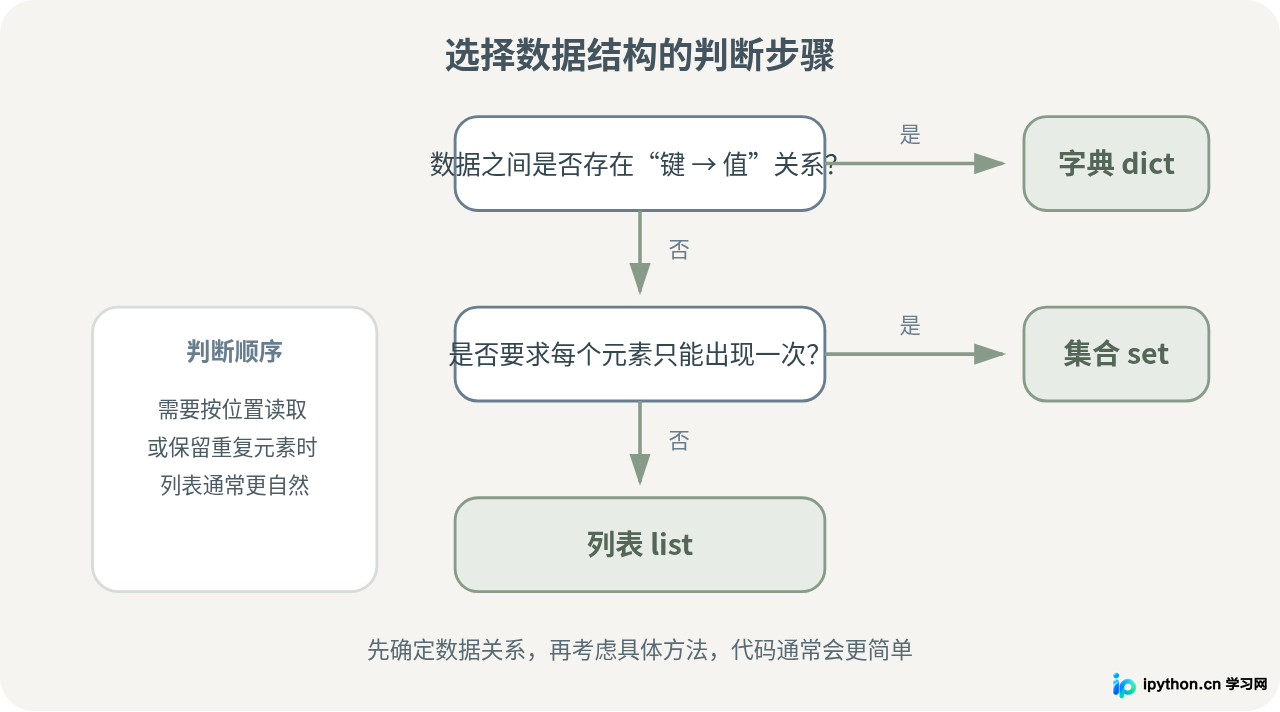
四、集合:去重和成员判断更直接
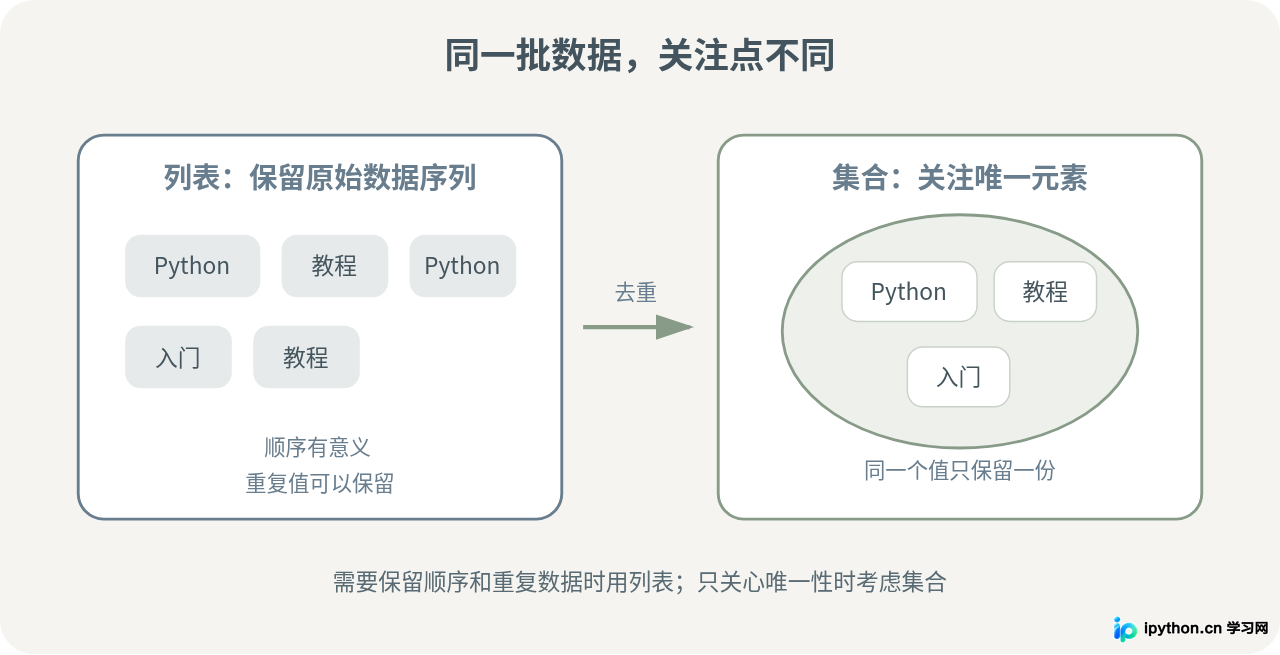
集合与列表最大的区别之一,是集合不会保留重复元素。 如果业务本身只关心“某个值有没有出现”,而不关心同一个值出现几次,集合往往更符合数据本身的含义。
1. 使用集合完成去重
tags = ["Python", "教程", "Python", "入门", "教程"]

unique_tags = set(tags)

print(unique_tags)
输出中的元素只会各保留一份。需要注意,集合不应该用于依赖固定位置索引的场景,因此不要把
set 当成“自动去重版列表”来理解。
如果最终仍然需要列表,可以进行转换:
tags = ["Python", "教程", "Python", "入门", "教程"]

unique_tags = list(set(tags))

print(unique_tags)list(set(data))。
这种写法解决的是“得到唯一元素”,不是“按原顺序去重”。
2. 判断元素是否存在
例如有一组允许访问后台的角色:
allowed_roles = {"admin", "editor", "author"}

role = "editor"

if role in allowed_roles:
    print("允许访问")
else:
    print("拒绝访问")
示例输出:
允许访问这种场景只关心“是否包含某个值”,没有必要维护元素的位置,因此集合比列表更贴近需求。
3. 交集、并集和差集
集合的另一个优势,是可以直接表达两组数据之间的关系。 例如两个用户分别关注了一些技术标签:
user_a = {"Python", "Linux", "Docker"}
user_b = {"Python", "Java", "Docker"}

# 两个人都关注
common = user_a & user_b

# 两个人关注的全部标签
all_tags = user_a | user_b

# A关注而B没有关注
only_a = user_a - user_b

print(common)
print(all_tags)
print(only_a)
这里三个符号分别表达:
&:交集,两边都存在。|:并集,合并两边所有唯一元素。-:差集,只保留左边有、右边没有的元素。
五、相同需求下,选对结构比写复杂代码更重要
初学时容易出现一种情况:已经习惯列表,于是不管什么数据都先放进列表。 数据量小时代码往往也能运行,但随着逻辑增加,会出现大量遍历和判断。
例如,要根据用户 ID 保存多个用户名,可以使用列表:
users = [
    {"id": 101, "name": "Tom"},
    {"id": 102, "name": "Alice"},
    {"id": 103, "name": "Bob"}
]

target_id = 102

for user in users:
    if user["id"] == target_id:
        print(user["name"])
        break
这段代码没有错误。如果主要需求是按照原始顺序依次展示用户,这样的列表很合理。
但如果程序的核心操作变成了“反复根据 ID 找到用户名”,数据关系其实更接近
ID → 用户名:
users = {
    101: "Tom",
    102: "Alice",
    103: "Bob"
}

print(users[102])
示例输出:
Alice两种做法解决的是略有不同的问题。列表强调“这一批用户按照什么顺序排列”,字典强调“给定一个 ID,对应哪个用户”。 差异重要的地方并不是少写了几行代码,而是数据结构与实际访问方式保持一致。
六、列表、字典和集合可以组合使用
实际程序中的数据通常不会只用一种结构。 例如一篇文章可以使用字典表示,而文章列表又可以由多个字典组成:
articles = [
    {
        "id": 101,
        "title": "Python列表入门",
        "tags": {"Python", "列表", "入门"}
    },
    {
        "id": 102,
        "title": "Python字典用法",
        "tags": {"Python", "字典"}
    }
]

print(articles[0]["title"])
print("Python" in articles[1]["tags"])
示例输出:
Python列表入门
True
这个结构中三种数据结构各自承担了不同职责:
- 外层列表负责保存多篇文章,并允许按照顺序遍历。
- 每篇文章用字典保存 ID、标题、标签等字段。
- 标签使用集合,表示标签不能重复,并方便判断某个标签是否存在。
这比强行把所有数据都塞进同一种结构更容易理解,也更方便后续修改。
七、几个容易混淆的高效用法
1. 判断是否存在:不要先手工遍历
如果只是判断一个值是否存在,直接使用 in:
languages = ["Python", "Java", "PHP"]

if "Python" in languages:
    print("已存在")
如果程序需要频繁判断大量唯一值是否存在,可以进一步考虑把这批数据保存为集合,而不是每次都自己写循环。
2. 不要一边遍历列表,一边随意删除元素
例如想删除所有小于 60 的成绩,与其边遍历边删除,更适合直接构造一个新列表:
scores = [95, 42, 68, 55, 87]

scores = [score for score in scores if score >= 60]

print(scores)
示例输出:
[95, 68, 87]遍历过程中修改正在遍历的列表,容易导致某些元素被跳过。过滤数据时生成新列表通常更直观。
3. 空集合不能写成 {}
这是初学者很容易遇到的区别:
empty_dict = {}
empty_set = set()

print(type(empty_dict))
print(type(empty_set))
示例输出:
<class 'dict'>
<class 'set'>
{} 表示空字典。要创建空集合,必须使用 set()。
4. 集合元素和字典键需要可哈希
字符串、数字、元组等常见不可变对象通常可以作为集合元素或字典键。 列表本身是可变对象,因此不能直接作为集合元素或字典键。
# 可以
coordinates = {
    (10, 20): "A点",
    (30, 40): "B点"
}

# 不可以把列表直接作为字典键
# data = {[10, 20]: "A点"}
如果一组数据需要作为键使用,又不应该被修改,可以考虑用元组 tuple 表示。
八、一个完整例子:整理文章标签
下面把列表、字典和集合放到同一个小任务中。 假设程序接收到多篇文章,需要统计每个标签出现在哪些文章中。
articles = [
    {
        "id": 101,
        "title": "Python列表入门",
        "tags": ["Python", "列表", "入门", "Python"]
    },
    {
        "id": 102,
        "title": "Python字典入门",
        "tags": ["Python", "字典", "入门"]
    },
    {
        "id": 103,
        "title": "Linux基础命令",
        "tags": ["Linux", "命令", "入门"]
    }
]

tag_articles = {}

for article in articles:
    unique_tags = set(article["tags"])

    for tag in unique_tags:
        if tag not in tag_articles:
            tag_articles[tag] = []

        tag_articles[tag].append(article["id"])

for tag, article_ids in tag_articles.items():
    print(tag, article_ids)
这个例子中:
articles使用列表,因为需要保存多篇文章。- 单篇文章使用字典,因为 ID、标题和标签都是明确字段。
set(article["tags"])用于删除同一篇文章中的重复标签。tag_articles使用字典,因为需要建立“标签 → 文章 ID 列表”的对应关系。
可以看到,所谓“高效使用数据结构”并不是寻找一种万能写法,而是让每一种结构负责它擅长表达的关系。
九、如何快速判断该用哪一种
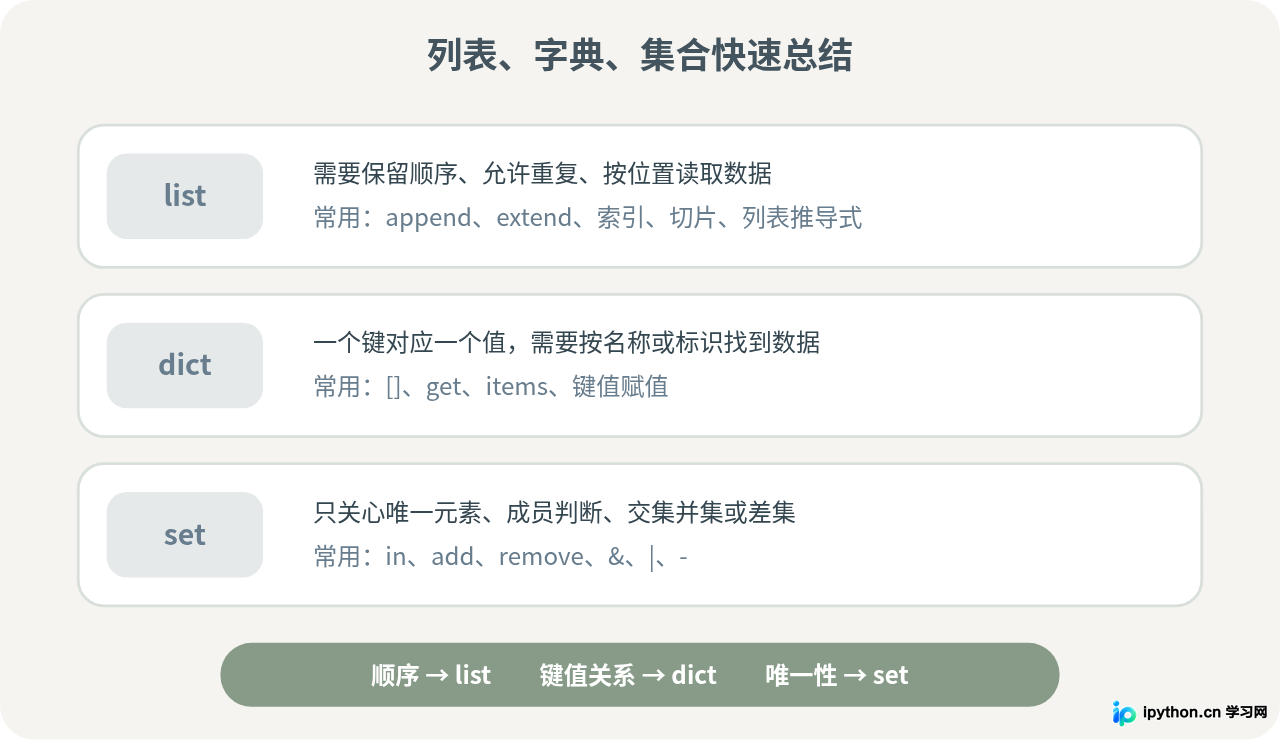
实际写代码时,可以按下面的方式判断:
- 如果你会问“第几个元素是什么”,通常优先考虑列表。
- 如果你会问“这个键对应什么值”,通常优先考虑字典。
- 如果你会问“这个值有没有出现过”,并且不关心重复次数,通常可以考虑集合。
- 如果需要按照原始顺序保存重复数据,不要因为想去重就直接把整个数据结构改成集合。
- 如果同一批数据同时存在不同关系,可以组合使用列表、字典和集合,而不是强行三选一。
append()、get()、items()、in、
集合运算和推导式等常用功能,代码通常就会更加清晰,也更容易维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















