


Python集合与字典的核心区别:语法、底层实现及应用场景
深入对比Python集合(set)与字典(dict)的本质区别,涵盖字面量语法规范、CPython哈希表底层数据结构、内存模型、核心操作流程与工程选型决策。
set)与字典(dict)虽然都基于高效的散列表(Hash Table)实现元素查找,并且在代码形式上都依赖大括号 {},但两者的定位截然不同:字典构建的是“键到值(Key-to-Value)”的映射网络,致力于解决关联实体的存储与检索;而集合仅保存“唯一键(Key-Only)”的无序单值,专门用于快速去重与数学集合逻辑运算。本文将从语法差异、CPython 底层存储结构到业务选型,全面拆解两者的异同。
一、语法与声明形态对比
对于刚接触 Python 的开发者而言,两者在字面量上的相似极易引发混淆。字典采用冒号分割键与值,而集合直接存放离散元素。
1. 字面量初始化与空容器陷阱
Python 最典型的语法陷阱之一就是空容器的初始化。由于字典在早期的 Python 语言中被更普遍地使用,大括号 {} 默认被解释为空字典,而非空集合:
# 字典字面量声明
user_scores = {"alice": 95, "bob": 88}

# 集合字面量声明
allowed_roles = {"admin", "editor", "viewer"}

# 空容器初始化
empty_dict = {}         # 类型为 <class 'dict'>
empty_set = set()       # 必须使用构造函数声明空集合,不能使用 {}
2. 元素可哈希性(Hashability)与嵌套约束
无论是集合的元素,还是字典的键(Key),都必须是“可哈希”对象(在 Python 中意味着不可变且具有生命周期恒定的哈希值,如 int、str、tuple)。然而,字典的值(Value)没有任何限制,可以自由嵌套列表、字典甚至函数:
- 字典的约束边界:Key 必须不可变(不可使用
list、dict作为键),Value 允许任意类型。 - 集合的约束边界:集合本身的所有元素都必须不可变。因此,集合不能包含列表,也不能直接包含普通集合;若需要嵌套集合,必须使用不可变的
frozenset。
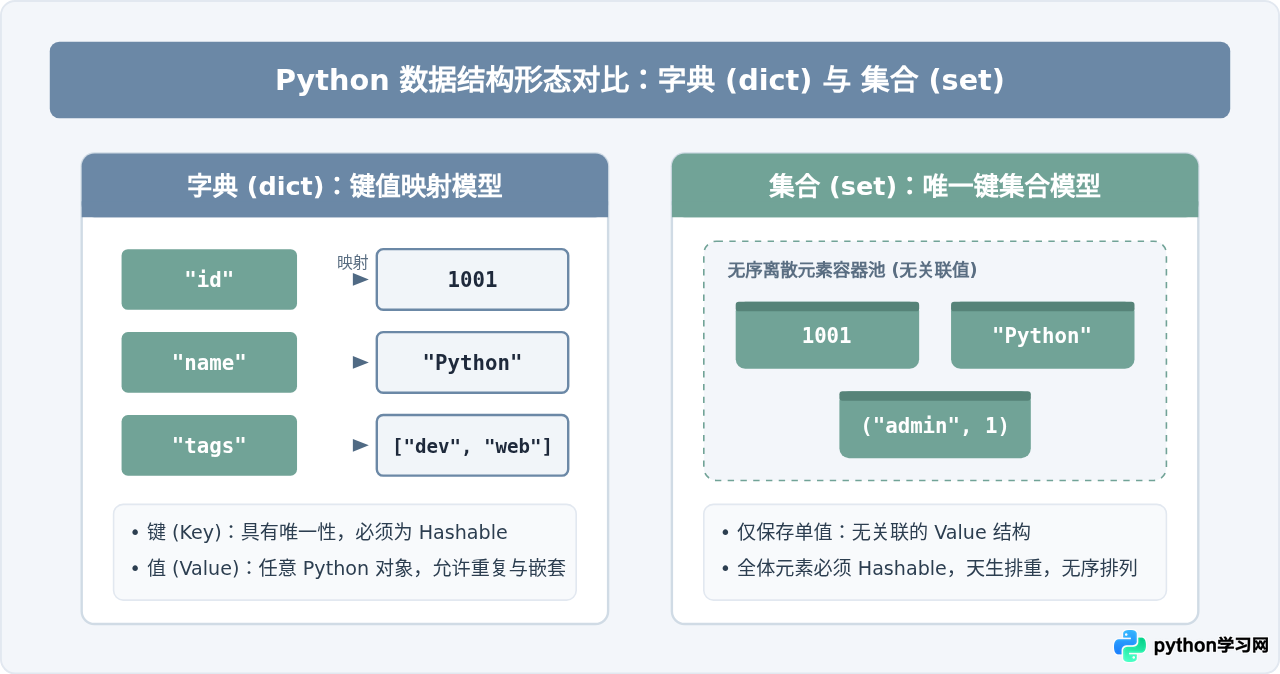 图 1:Python 字典的“键-值”成对绑定形态与集合的“无序单值”去重池形态对比
二、底层实现与内存模型剖析
在 CPython 解释器中,字典和集合虽然在底层都建立在开放寻址法(Open Addressing)与伪随机探测(Perturb Algorithm)的哈希表基石上,但两者的内部组织演进产生了显著区别。
1. 字典的“紧凑数组”(Compact Dict)革命
自 Python 3.6 起(并在 3.7 正式成为语言标准),字典采用了全新的紧凑哈希表架构(Raymond Hettinger 提出)。在此之前,字典使用一个稀疏的大数组,每一个槽位都同时存储 hash、key 和 value。当数组由于保证负载因子而大量留空时,空间浪费非常严重。
现代 Python 字典将数据拆分为两部分:
- 稀疏索引数组(Indices):仅存放非常小的整数(如
int8或int16),作为数据表的下标偏移量。 - 紧凑条目数组(Entries):连续、密集地保存每个条目的
hash、key指针与value指针。新插入的键值对依次追加在 entries 尾部。
这种设计带来了两大直接收益:内存节省 20%~40%,同时天生让字典获得了保留插入顺序(Insertion Order Preserved)的特性。
2. 集合的底层结构(PySetTable)
与字典不同,集合(PySetObject)在 CPython 中依然维持了较为传统的散列表结构:
- 集合的条目结构为
setentry,内部仅包含key对象指针和预先计算好的hash整数,没有value指针。 - 集合并不采用“稀疏索引 + 紧凑连续表”的分离结构,而是直接分配一个大小为 \(2^n\) 的
table数组,散列冲突时直接在该数组内部进行探测定位。 - 集合始终是无序的:由于直接基于散列位置落槽,当集合进行元素增删、触发扩容(Resize)或重建时,元素在物理表中的顺序随时会变化,因此 Python 官方明确声明
set不保证任何迭代顺序。
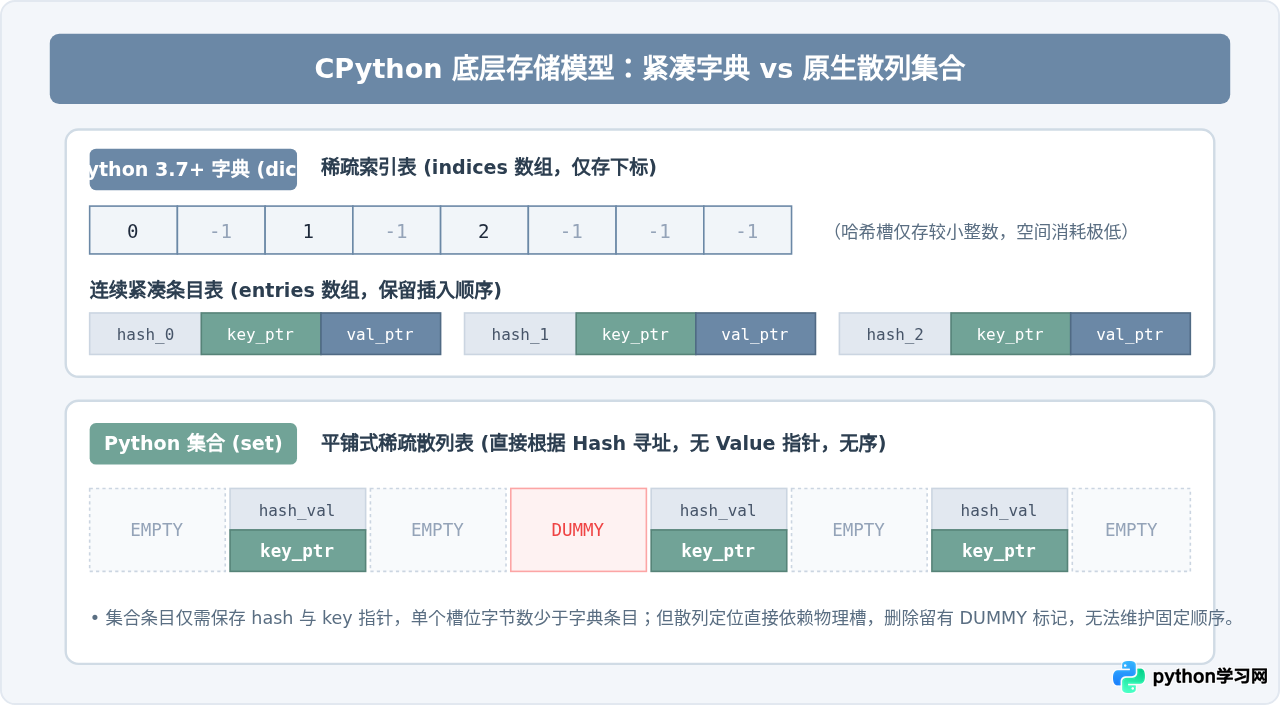 图 2:CPython 中字典的双数组紧凑结构(Compact Hash Table)与集合的扁平开放寻址哈希表对比
三、核心操作方法与处理流程
由于底层数据组织不同,两者在 API 设计与高频操作的实现语义上呈现出截然不同的方向。
1. 集合特有的数学集合运算
集合拥有强大的集合代数能力,支持求交集、并集、差集和对称差。这些操作在底层利用 C 语言实现的散列快速扫描,性能远超纯 Python 编写的循环判断:
frontend_devs = {"Alice", "Bob", "Charlie"}
backend_devs = {"Bob", "David", "Eve"}

# 交集:同时精通前后端(& 运算符或 intersection 方法)
fullstack = frontend_devs & backend_devs           # {'Bob'}

# 并集:所有研发人员(| 运算符或 union 方法)
all_devs = frontend_devs | backend_devs            # {'Alice', 'Bob', 'Charlie', 'David', 'Eve'}

# 差集:仅前端但非后端(- 运算符或 difference 方法)
pure_frontend = frontend_devs - backend_devs       # {'Alice', 'Charlie'}

# 对称差:仅在一个领域的开发者(^ 运算符)
specialists = frontend_devs ^ backend_devs # {'Alice', 'Charlie', 'David', 'Eve'}&、|)时,两边操作数都必须是集合对象;而调用方法(如 frontend_devs.intersection(["Bob", "Frank"]))时,参数可以是任何可迭代对象(列表、元组或生成器),具有更强的容错性。
2. 字典的访问、默认值与合并
字典关注的是通过 Key 快速存取 Value。在日常开发中,安全取值与字典更新是核心流程:
config = {"timeout": 30, "retry": 3}
# 安全获取:避免 KeyError 异常
timeout = config.get("timeout", 10)
debug_mode = config.get("debug", False)
# Python 3.9+ 字典合并运算符 (| 与 |=)
override = {"timeout": 60, "env": "prod"}
final_config = config | override # {'timeout': 60, 'retry': 3, 'env': 'prod'}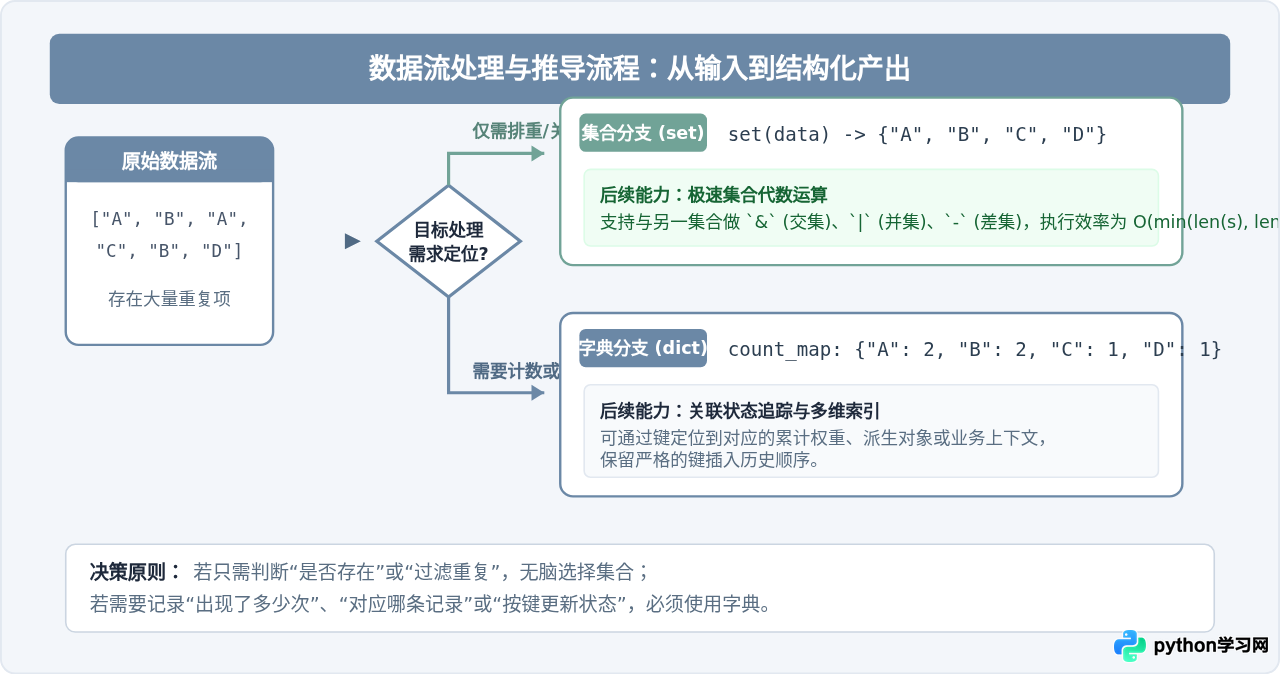 图 3:数据从输入流向集合(去重与代数运算)与字典(状态映射与频次统计)的处理流程推导
四、应用场景与工程选型决策
在实际业务开发中,合理选用 set 或 dict 能在显著提升代码运行速度的同时降低内存开销。
| 对比维度 | 集合 (set) | 字典 (dict) |
|---|---|---|
| 数据存储结构 | 仅存储唯一的 Key 对象 | 存储唯一的 Key 及其关联的 Value |
| 插入顺序性 | 无序(不保证任何插入或迭代顺序) | 保序(自 Python 3.7+ 正式保障维持插入次序) |
| 查找复杂度 | 平均 \(O(1)\),最坏 \(O(n)\) | 平均 \(O(1)\),最坏 \(O(n)\) |
| 单元素内存占用 | 较低(仅存放 Hash 与 Key 指针) | 略高(紧凑表结构需存放 Hash、Key 与 Value 指针) |
| 不可变版本 | frozenset(内置原生类型) |
types.MappingProxyType(只读视图代理) |
| 典型业务场景 | 权限名单校验、海量数据去重、数学交并差计算 | 实体属性映射、统计频次、配置管理、缓存表 |
1. 集合的经典业务场景
- 超快成员资格测试(Membership Testing):列表使用
x in my_list是 \(O(n)\) 的线性扫描,随着数据增长性能急剧恶化;而x in my_set是 \(O(1)\) 的哈希直达。百万级黑名单校验场景下,性能差距可达数百倍。 - 数据清洗与排重:从数据库导出的大量非唯一记录,通过
unique_ids = set(raw_ids)瞬间完成去重。 - 权限与标签匹配:判断当前用户是否具有某些权限节点中的任意一个:
bool(user_permissions & required_permissions)。
2. 字典的经典业务场景
- 数据模型建模:JSON 格式在 Python 中的天然载体就是字典,用于承载 RESTful API 响应与配置信息。
- 频次统计与计数桶:通过
dict(或其子类collections.Counter)遍历统计文本中每个词汇出现的频次。 - 快速检索缓存(Memoization):利用不可变的输入参数作为 Key,函数的计算结果作为 Value 实现函数级内存缓存。
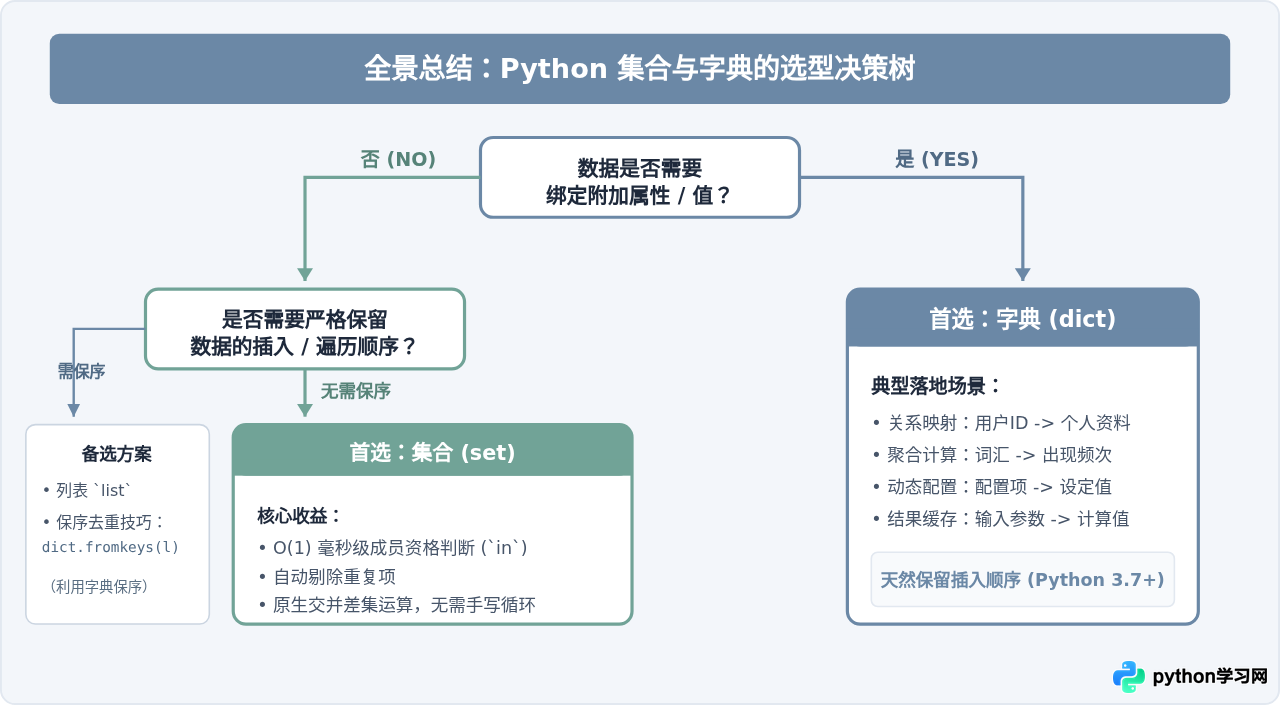 图 4:Python 容器选型全景决策树:依据值映射需求、保序要求及运算目标快速定型
五、常见混淆与实践避坑指南
1. 为什么不能用列表(list)作为集合的元素或字典的键?
如果在集合中加入列表,或者用列表作为字典的键,Python 会立即抛出异常:
broken_set = {[1, 2, 3]}
# 抛出异常: TypeError: unhashable type: 'list'
原因解释:散列表必须保证同一个对象在整个生命周期内的散列值永远保持恒定。列表是可变对象(Mutable),允许执行 append() 或原地修改。如果允许列表作为哈希槽索引,列表修改后其哈希值改变,将导致此前放入散列表的条目永远无法被检索出来,直接摧毁哈希表的一致性。如果需要类似功能,必须先转换为不可变的元组(tuple)。
2. 为什么字典的值允许是可变对象?
因为字典在进行哈希寻址时,只针对 Key 计算哈希值。Value 在内存中仅作为一个普通的指针存储在 entries 结构中,并不参与任何散列槽的计算与定位。因此修改 Value 里的列表内容,完全不会影响字典根据 Key 找到该指针的路径。
3. 保留顺序去重技巧
日常开发中,经常需要对一个有序列表进行去重,且要求保留原有出现次序。如果直接使用 list(set(items)),由于集合是无序的,原有次序会被打乱。
在现代 Python 中,最高效的标准做法是利用字典的保序特性:
raw_records = ["apple", "banana", "apple", "orange", "banana"]

# 传统集合去重:失去原有顺序
unordered_unique = list(set(raw_records))
# 结果可能是: ['banana', 'orange', 'apple']

# 现代字典保序去重:保留首次出现的严格顺序
ordered_unique = list(dict.fromkeys(raw_records))
# 结果始终是: ['apple', 'banana', 'orange']本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















