


Python解压ZIP包中文乱码的解决方案

发布时间:2026-10-14 |
4人浏览过
本文介绍了Python中解压ZIP文件时常见的中文乱码问题及其解决方法。由于ZipFile模块在处理中文文件名时可能遇到编码问题,导致解压后的文件名显示异常。文章提供了三种解决方案,包括创建文件名映射表、修改源码解码格式以及手动处理文件写入和文件夹创建。推荐采用手动处理的方式,以确保文件名正确显示。
问题背景
乱码产生的原因:
在使用ZipFile模块导出文件时,如果遇到中文解码不正确,Windows系统上会出现乱码现象。至于Linux系统是否会出现类似情况,由于未进行测试,目前尚不清楚。
解决方案
解决方式:
1. 创建一个文件名映射表(这种方法不太方便,但在处理少量文件夹嵌套时还可以使用)。
2. 修改源码中的解码格式(这种方法也不太方便,我自己尝试后遇到了其他错误)。
3. 手动写入文件并创建文件夹(推荐方法)。
手动创建的写法:
代码实现
with zipfile.ZipFile(file=zip_save_path, mode='r') as zf:
      # 解压到指定目录,首先创建一个解压目录
      os.mkdir(unzip_dir_path)
      for old_name in zf.namelist():
        # 获取文件大小,目的是区分文件夹还是文件,如果是空文件应该不好用。
        file_size = zf.getinfo(old_name).file_size
        # 由于源码遇到中文是cp437方式,所以解码成gbk,windows即可正常
        new_name = old_name.encode('cp437').decode('gbk')
        # 拼接文件的保存路径
        new_path = os.path.join(unzip_dir_path, new_name)
        # 判断文件是文件夹还是文件
        if file_size > 0:
          # 是文件,通过open创建文件,写入数据
          with open(file=new_path, mode='wb') as f:
            # zf.read 是读取压缩包里的文件内容
            f.write(zf.read(old_name))
        else:
          # 是文件夹,就创建
          os.mkdir(new_path)
结果验证
结果正常:
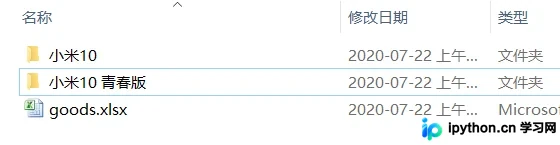
以上就是Python解压ZIP包中文乱码解决方法的详细内容,更多关于Python解压ZIP包中文乱码的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















