


Python与Java、C++的应用场景区别在哪里

Python、Java与C++的核心应用场景区别,本质上是由内存控制精度、执行吞吐能力与业务迭代速度三者之间的取舍决定的:C++用于需要极致性能与硬件直接控制的底层基础设施;Java用于追求高吞吐、长时间稳定运行的大型企业级后端与分布式系统;Python则主导快速交付、数据计算编排与人工智能模型实验。
一、底层约束差异:为什么语言特性决定了业务边界
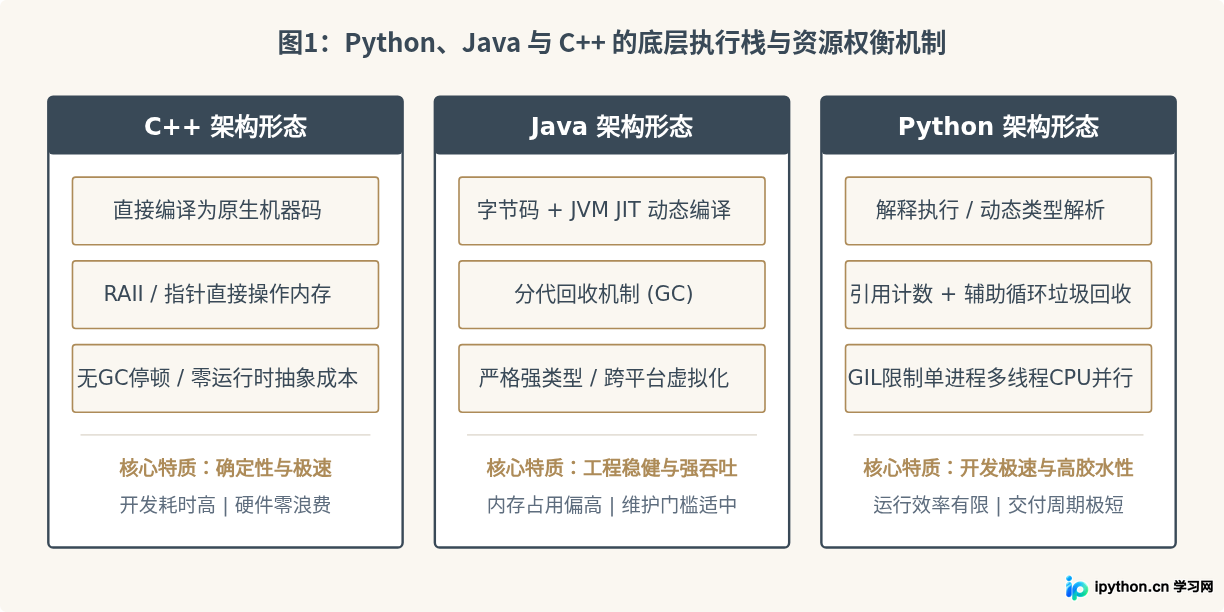
讨论应用场景前,必须先看三者在执行机制和内存管理上的根本差别。编程语言不是凭空选择业务领域的,而是系统资源约束倒逼工程团队做出的合理妥协。
- C++(机器码直接执行,手工/RAII内存管理):程序直接编译为目标平台的机器指令。它没有虚拟机,没有垃圾回收(GC)暂停,内存分配与释放严格受控。因此它的CPU与内存利用率达到上限,适合硬件控制和硬实时环境,但代价是极高的编码门槛与边界检查风险。
- Java(JVM字节码,分代垃圾回收):通过JVM运行字节码,由即时编译器(JIT)在运行时将热点代码编译优化为机器码。自动内存管理降低了崩溃率,强静态类型在大型团队协同中保障了接口契约,但代价是运行时初始内存占用高且GC偶有延迟。
- Python(解释型虚拟机,引用计数为主的GC):代码被编译为字节码后在解释器(如CPython)中逐行解析运行,受全局解释器锁(GIL)约束。动态类型让代码极度紧凑,开发效率极高,但单纯依靠CPU运算的底层执行速度通常比C++和Java慢1到2个数量级。
二、场景一:C++ 的核心阵地——资源受限与极限性能领域
当程序的延时指标要求在微秒(μs)甚至纳秒级别,或者运行环境受到极端严格的功耗、内存限制时,C++几乎是唯一成熟的工程选择。
1. 高频交易与量化匹配系统
在撮合交易场景中,99.9%分位的网络响应延迟往往需要被压制在微秒级。Java的垃圾回收无论如何优化,在突发Full GC或长时间STW(Stop The World)时都会引发数十毫秒的停顿,这种停顿在金融撮合中可能造成巨大资金损失。C++允许开发者预先分配环形缓冲区(Ring Buffer)和无锁队列,杜绝运行时内存申请,从而保证执行延迟平稳可控。
2. 游戏引擎与3D图形渲染
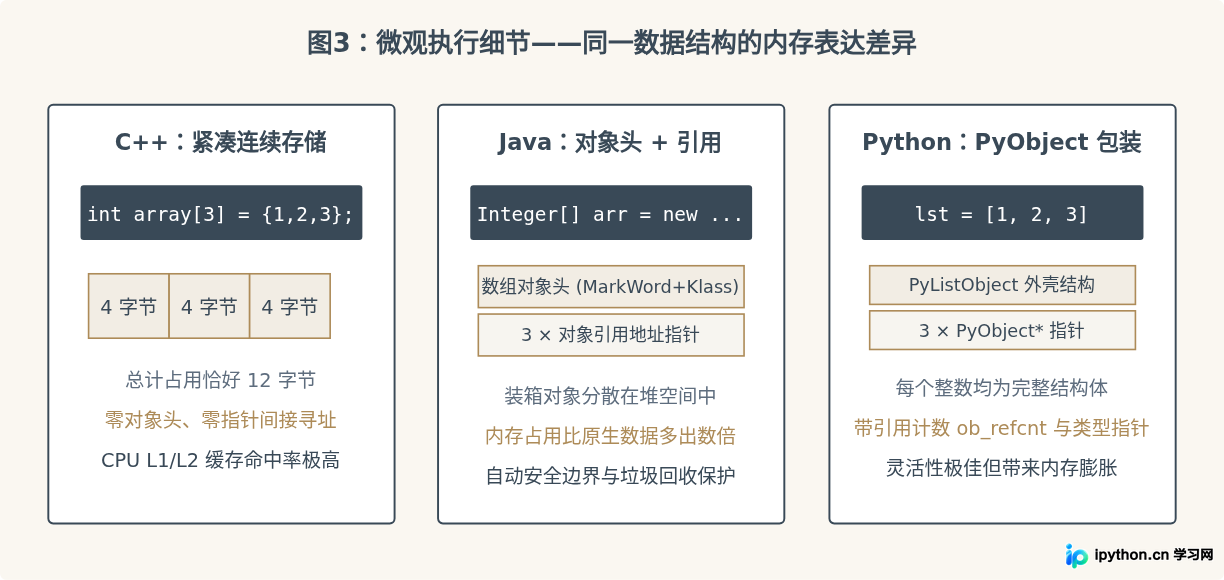
主流商用引擎(如Unreal Engine)及自研大型3D引擎完全由C++主导。显卡与CPU之间的数据频繁传递、顶点矩阵变换、物理碰撞检测等计算,要求程序拥有直接管理CPU一级/二级缓存友好的内存布局(Data-Oriented Design)能力。这种针对硬件拓扑优化内存连续性的能力,带有虚拟层或自动引用的语言难以做到。
3. 基础设施软件(操作系统核心、数据库底层、浏览器引擎)
Google Chrome的Blink引擎、MySQL/ClickHouse存储引擎、Redis底层(虽然Redis核心使用C语言,但同属直接原生编译范畴)均重度依赖C/C++。这些软件必须榨干服务器的每一块硬件性能,且不能接受外部运行时的额外负担。
三、场景二:Java 的核心阵地——高并发、大规模企业级系统
当项目规模扩展到几百个团队协同、上万个接口服务、需要数年不间断迭代升级时,Java的工程化红利便显露出来。
1. 超大型微服务与分布式事务体系
现代银行核心系统、电商交易链路(如阿里巴巴、京东)普遍使用Java(Spring Cloud、Dubbo生态)。在涉及数千张数据库分表、复杂的库存扣减事务中,C++虽然快,但团队协作中指针越界或内存泄漏导致的崩溃风险过高;Python虽然开发快,但在多层领域模型(DDD)下难以提供同等级别的类型检查与重构工具支持。Java凭借成熟的JVM调优工具、强类型接口契约与庞大的中间件生态,达成了“高性能”与“高开发安全性”的平衡。
2. 大数据离线与实时计算平台
Apache Hadoop、Apache Spark、Apache Flink、Kafka 等流批处理系统均基于Java及运行于JVM的Scala构建。大数据系统处理的是GB到PB级的海量吞吐,JVM对大堆内存的并发管理能力,以及历经数十年演进的JIT编译优化,保障了分布式计算节点在高压力下的长时间吞吐稳定。
四、场景三:Python 的核心阵地——数据智能与高效交付
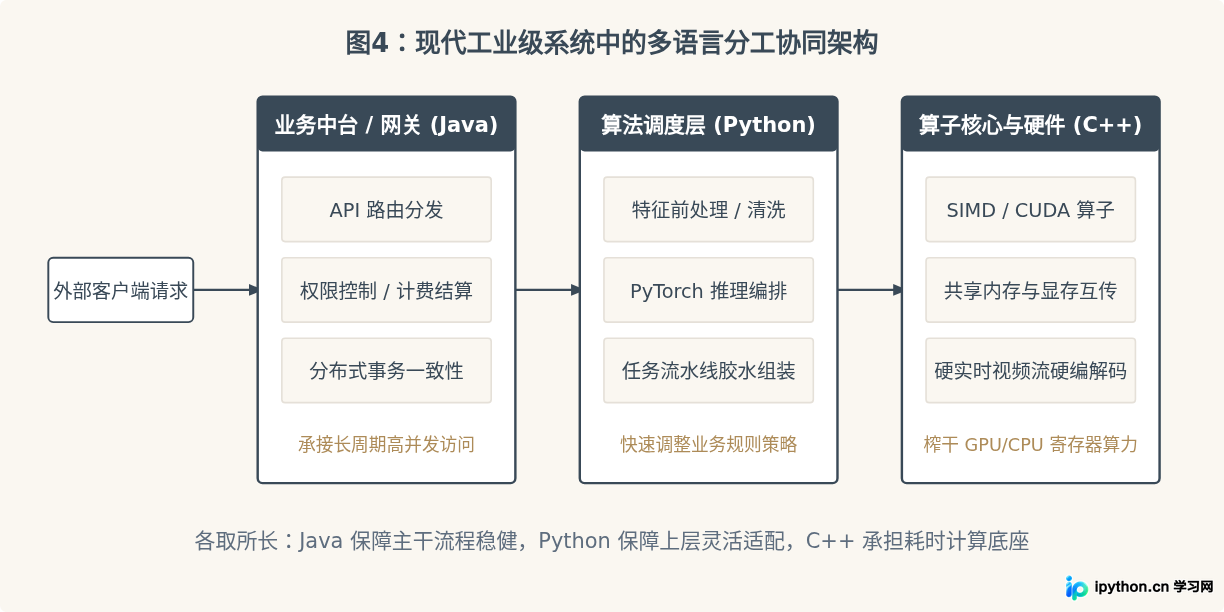
Python的核心竞争力在于开发心智负担低与极强的库生态粘性。它的执行速度虽然慢,但通过胶水语言的特性将计算密集部分卸载给底层的C/C++动态链接库,达成了“写Python代码,享C底层速度”的独特优势。
1. 人工智能、机器学习与科学计算
PyTorch、TensorFlow、NumPy、Pandas等主流计算生态全部使用Python作为前端交互语言。在这类应用中,实际的张量乘法、反向传播梯度求解、CUDA算子全部由底层的C++与CUDA编写。开发者只需在Python层组织神经网络拓扑与管道调度:
# Python 示例:调用底层 C/CUDA 加速的张量运算
import torch

# 语法简洁明了,但底层的 GEMM 矩阵运算完全由 C++/CUDA 硬件加速执行
device = "cuda" if torch.cuda.is_available() else "cpu"
x = torch.randn(4096, 4096, device=device)
y = torch.randn(4096, 4096, device=device)
z = torch.matmul(x, y)  # 耗时几乎全部在底层的原生指令,Python 解析消耗占比微乎其微
如果强行换成Java或纯C++来做算法实验,前者缺乏灵活的动态切片与科学计算工具箱,后者编译一次修改耗时过久,极大地拖慢了算法调优与学术研究的探索节奏。
2. 运维编排、自动化测试与数据采集
当面对基础设施配置(Ansible)、自动化流水线脚本、网页数据抓取(Requests / Scrapy)时,程序往往处于大量网络或磁盘I/O等待中。此时CPU计算速度根本不是瓶颈,能够在10行代码内完成请求重试、JSON解析与本地写入的能力才是关键。
五、多维度横向参数对照
为方便清晰对照三者在实际开发过程中涉及的关键维度,以下汇总主要特性的差异表现:
| 对比维度 | C++ | Java | Python |
|---|---|---|---|
| 运行时模型 | 直接编译为机器码 | JVM 字节码 + JIT 运行时编译 | 解释器逐行解析(CPython 为主) |
| 内存管理 | 程序员手动 / RAII / 智能指针 | JVM 垃圾回收器(ZGC, G1等) | 引用计数 + 分代垃圾回收 |
| 类型系统 | 静态弱/强类型,编译期检查 | 静态强类型,编译期与运行期检查 | 动态强类型,运行期检查(支持类型注解) |
| 原生多线程并发 | 基于系统级线程,完全并行 | 基于系统级线程 / 虚拟线程(Loom) | 受GIL限制,多线程无法利用多核CPU算力 |
| 初始内存开销 | 极小(几十KB~几MB即可启动) | 较大(JVM基础开销通常数百MB起) | 小(数MB~数十MB) |
| 典型交付物形态 | 单平台原生二进制文件 / 动态库 | 跨平台 .jar / .war 包(带 JRE 运行) | 源码脚本 / 打包环境容器 |
六、选型注意事项与常见误区
如果任务是纯 CPU 密集的循环逻辑(例如图像滤镜的逐像素运算、未经 NumPy 向量化的复杂数学循环),纯 Python 代码执行速度较慢。此时应选用 C++ 编写核心算子并通过 pybind11 导出给 Python 调用,或使用 Numba / Cython 编译加速,切勿单靠多线程尝试提升纯计算任务性能(受 GIL 限制)。
许多初创业务由于预估“需要高性能”,过早选择 C++ 编写常规 CRUD 业务接口。然而在常规网络业务中,90% 以上的瓶颈在于 SQL 查询慢、跨机网络传输以及缓存策略失效,C++ 的语言级性能优势被数据库和网络 I/O 稀释得微乎其微,反而大幅拉长了产品迭代周期,增加了内存踩踏引发服务器崩溃的风险。
七、总结
选择哪门语言,不是给语言贴“优劣”标签,而是衡量当前项目中最昂贵且最稀缺的成本:
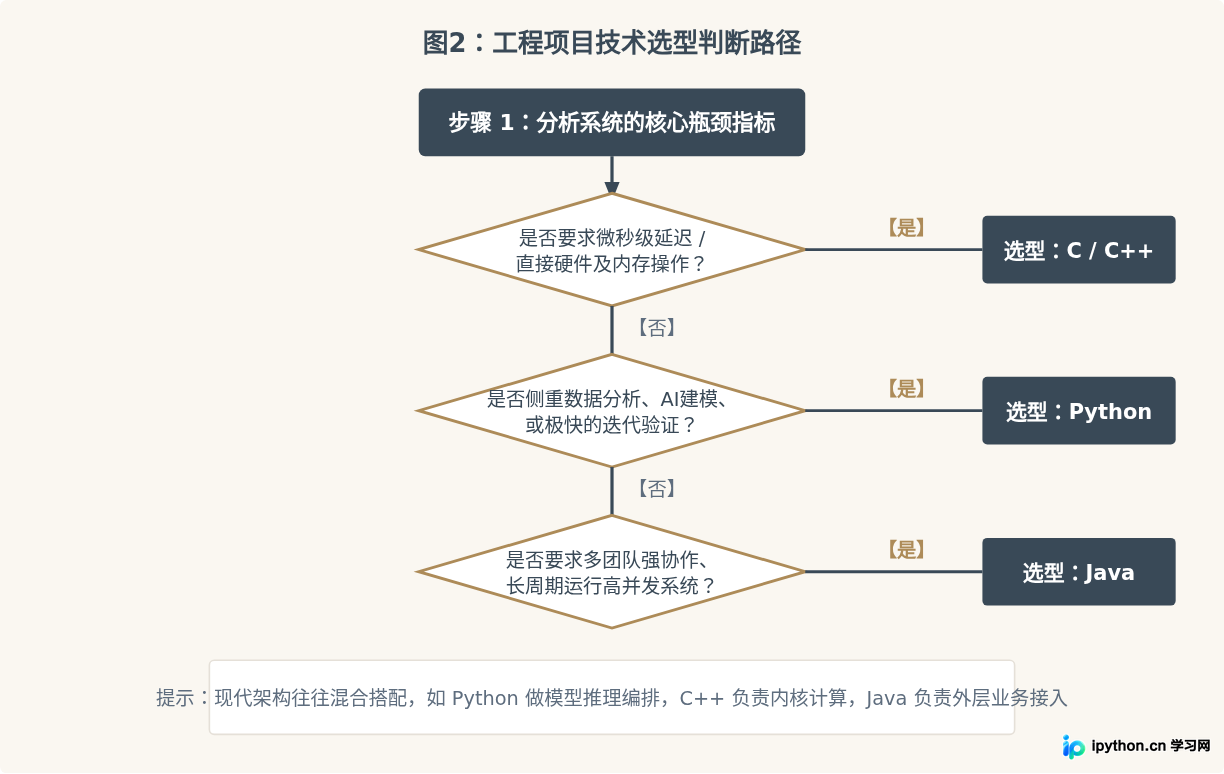
- 如果最昂贵的是时间与实验速度(需要快速上线业务逻辑、验证AI模型、编写测试脚本),选择 Python;
- 如果最昂贵的是系统故障成本与协作维护成本(需要上百人协同维护一套跑数年都不宕机的金融级大型企业系统),选择 Java;
- 如果最昂贵的是硬件开销与运行延迟(每一毫秒甚至每一微秒的计算延迟、每一兆内存都直接决定产品成败),选择 C++。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















