


Python爬虫URL管理器去重机制详解

发布时间:2026-10-14 |
4人浏览过
本文详细介绍Python爬虫中URL管理器的核心功能,重点解析如何利用Python的set()函数实现链接去重。通过对比新旧URL仓库,阐述如何高效识别并过滤重复链接,从而提升爬虫抓取效率。文中提供了完整的UrlManager类代码示例,帮助开发者掌握去重逻辑的具体实现。
在构建爬虫系统时,URL管理器扮演着类似仓库的角色,负责集中管理待抓取和已抓取的链接,而下载器则负责执行具体的抓取任务。本篇内容聚焦于URL管理器的核心挑战:如何有效识别并剔除重复链接,避免资源浪费。我们将深入探讨这一机制的实现原理。
URL管理器的核心功能定义
- 一个标准的URL管理器需维护两个独立的数据集合:一个用于存储尚未抓取的链接(新URL仓库),另一个用于记录已抓取过的链接(旧URL仓库)。
- 管理器需提供相应的接口函数,支持向上述两个数据集合中添加新的链接数据。
- 管理器应包含一个提取函数,能够从新URL仓库中随机选取一条链接,供下载器进行后续抓取操作。
- 管理器必须具备链接去重能力,自动识别并忽略已经存在于旧URL仓库中的链接,防止重复抓取。
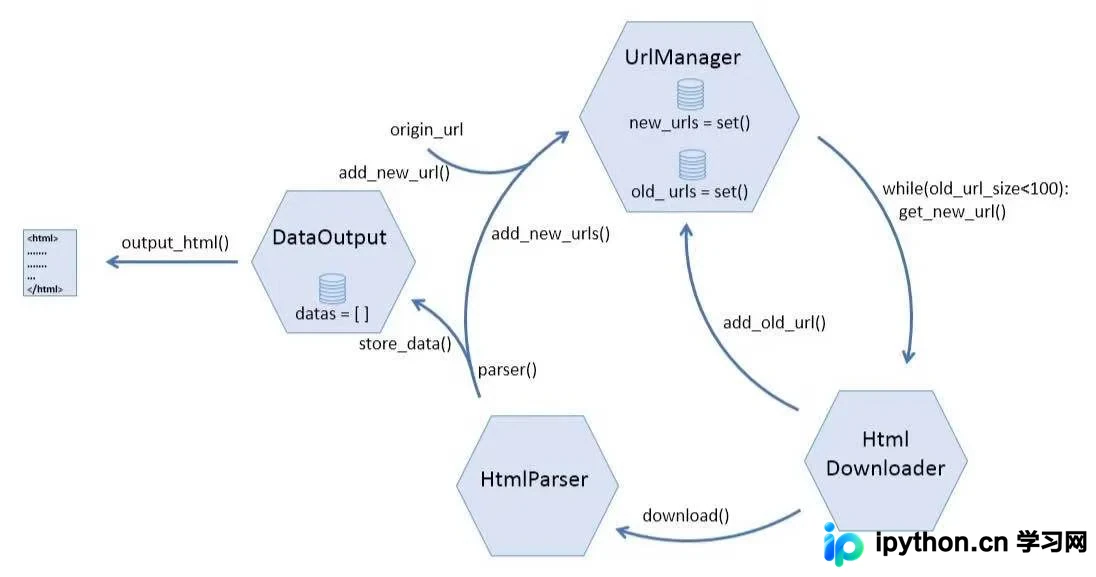
若URL管理器具备上述四项基本功能,即可视为基础完备。然而,实现高效的链接去重是提升爬虫性能的关键,接下来我们将探讨具体的技术实现方案。
链接去重直接影响爬虫的运行效率,尤其在数据量庞大时更为关键。在本示例中,鉴于数据规模较小,无需采用复杂的去重算法,直接利用Python内置的set()函数即可。Set集合的特性保证了其内部元素唯一性,天然适合用于去重场景。
基于上述分析,URL管理器的具体实现代码如下:
'''
UrlManager
class UrlManager(object):
  def __init__(self):
    #初始化的时候就生成两个url仓库
    self.new_urls = set()
    self.old_urls = set()
  #判断新url仓库中是否还有没有爬取的url
  def has_new_url(self):
    return len(self.new_urls)
  #从new_url仓库获取一个新的url
  def get_new_url(self):
    return self.new_urls.pop()
  def add_new_url(self, url):  #这个函数后来用不到了……
    '''
    将一条url添加到new_urls仓库中
    parm url: str
    return:
    if url is None:
      return
    #只需要判断old_urls中没有该链接即可,new_urls在添加的时候会自动去重
    if url not in self.old_urls:
      self.new_urls.add(url)
  def add_new_urls(self, urls):
    将多条url添加到new_urls仓库中
    parm url: 可迭代对象
    print "start add_new_urls"
    if urls is None or len(urls) == 0:
    for url in urls:
      self.add_new_url(url)
  def add_old_url(self, url):
    self.old_urls.add(url)
    print "add old url succefully"
  #获取已经爬取过的url的数目
  def old_url_size(self):
    return len(self.old_urls)
通过实践上述代码,您已成功掌握利用URL管理器进行数据筛选和去重的方法。希望本文能帮助读者深入理解URL管理器的基本功能及其在实际应用中的使用技巧。
以上就是关于Python爬虫中URL管理器去重操作的详细解析。如需了解更多相关技术内容,欢迎查阅本站历史文章或继续关注后续更新。感谢您的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















