


Python Scrapy框架实战:梨视频数据抓取与持久化存储详解

发布时间:2026-10-12 |
2人浏览过
本文基于Scrapy框架解析梨视频网站的数据抓取流程。针对视频标题与描述分属不同页面的特点,通过自定义parse方法与meta参数传递Item对象,实现跨页面数据解析。结合items定义字段与pipeline管道类,完成数据的清洗、持久化存储及多管道优先级处理,提供完整的代码示例与配置说明。
此前曾介绍过利用lxml库对梨视频网站视频进行下载的操作,有兴趣的读者可参考相关历史文章。
接下来,我们将使用Scrapy框架来爬取梨视频网站中的视频标题以及视频详情页中关于视频的具体描述信息。
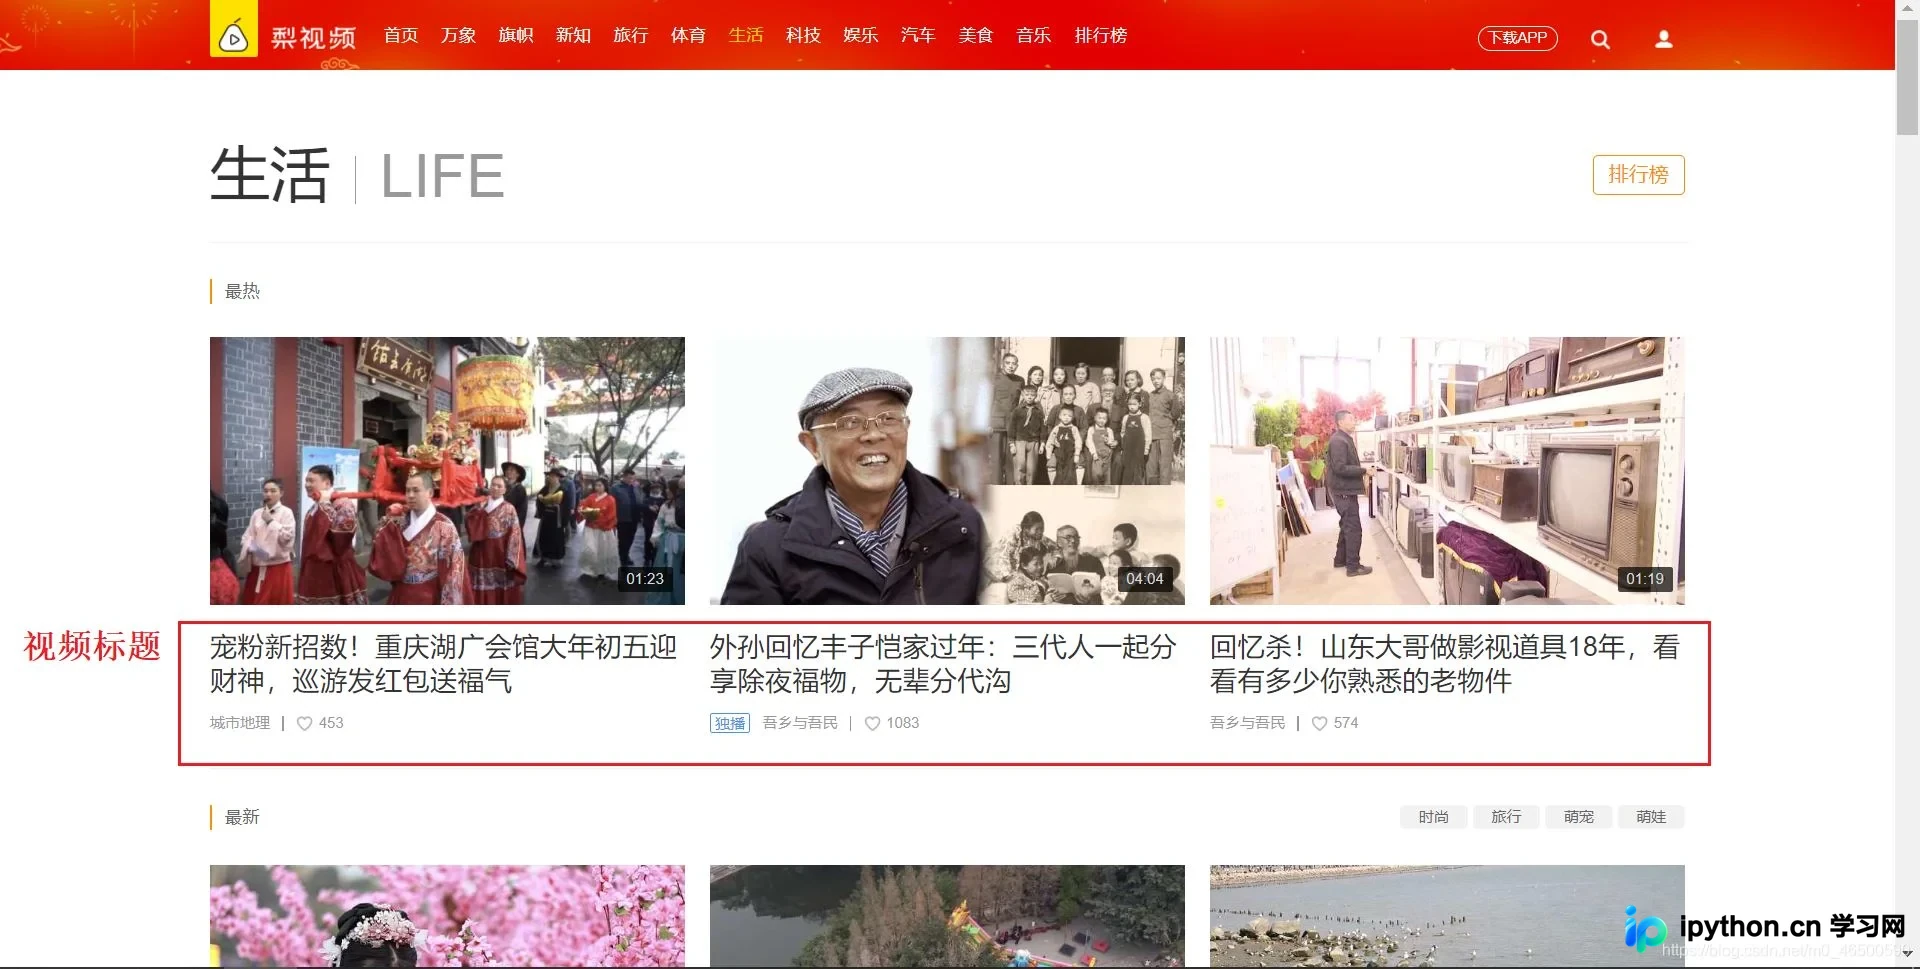
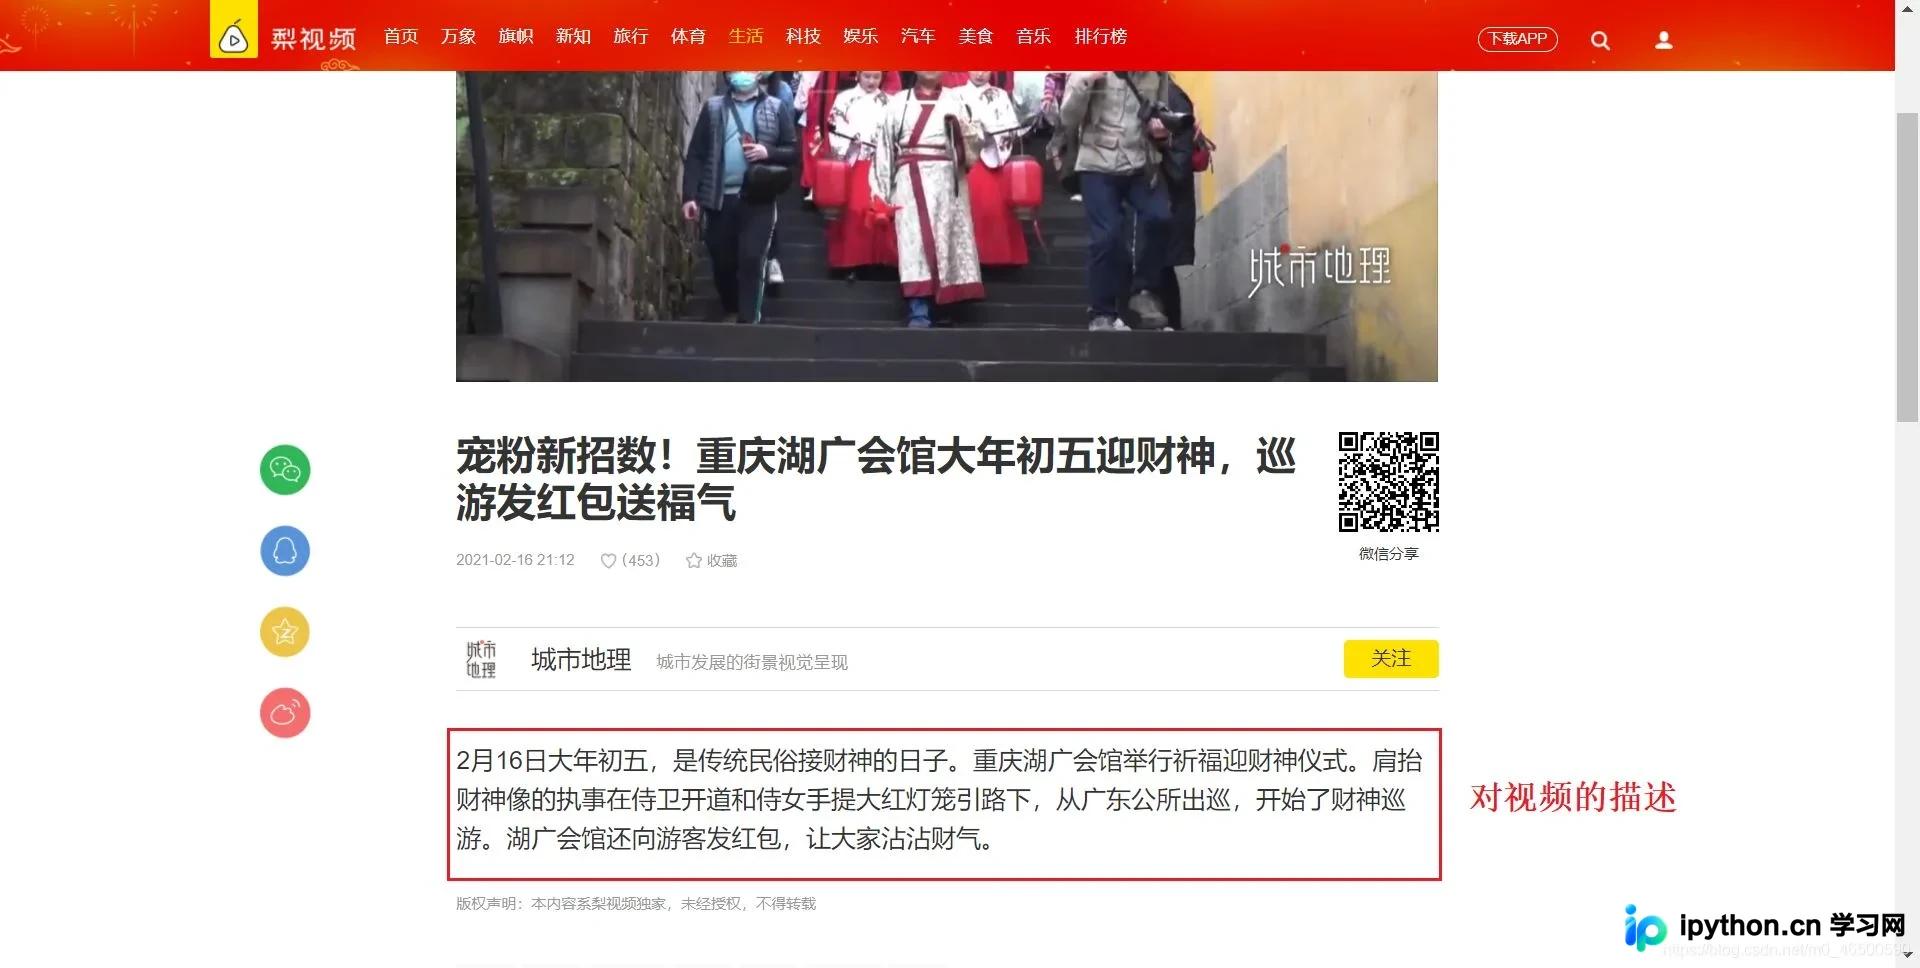
分析:由于目标数据分散在不同页面,视频描述需点击进入视频详情页(新URL)方可获取,因此无法在单一解析方法中同时处理所有数据。
1. 爬虫文件编写
- 可参照爬虫文件中的默认parse方法,创建一个新的解析方法(如content_parse),用于接收并处理跳转后新URL的响应对象。
- 若需在不同parse方法间共享同一个Item对象,可利用Request请求的meta参数字典,将Item对象作为参数传递给callback指定的回调函数。
- 在初始parse方法中,需yield Request请求以发起网络访问;而在新的解析方法中,则yield Item对象,以便将其传递给后续的parse方法或管道文件进行处理。
import scrapy

# 从items.py文件中导入BossprojectItem类
from bossProject.items import BossprojectItem

class BossSpider(scrapy.Spider):
 name = 'boss'
 # allowed_domains = ['www.xxx.com']
 start_urls = ['https://www.pearvideo.com/category_5']

 # 回调函数接受响应对象,并且接受传递过来的meata参数
 def content_parse(self,response):
 # meta参数包含在response响应对象中,调用meta,然后根据键值取出对应的值:item
 item = response.meta['item']

 # 解析视频链接中的对视频的描述
 des = response.xpath('//div[@class="summary"]/text()').extract()
 des = "".join(des)
 item['des'] = des

 yield item

 # 解析首页视频的标题以及视频的链接
 def parse(self, response):
 li_list = response.xpath('//div[@id="listvideoList"]/ul/li')
 for li in li_list:
  href = li.xpath('./div/a/@href').extract()
  href = "https://www.pearvideo.com/" + "".join(href)

  title = li.xpath('./div[1]/a/div[2]/text()').extract()
  title = "".join(title)

  item = BossprojectItem()
  item["title"] = title

  #手动发送请求,并将响应对象传给回调函数
  #请求传参:meta={},可以将meta字典传递给请求对应的回调函数
  yield scrapy.Request(href,callback=self.content_parse,meta={'item':item})
2. items.py配置
必须在爬虫文件中导入BossprojectItem类,才能实例化并使用该Item对象来存储抓取的数据。
import scrapy
class BossprojectItem(scrapy.Item):
 # define the fields for your item here like:
 # name = scrapy.Field()
 # 定义了item属性
 title = scrapy.Field()
 des = scrapy.Field()
3. pipelines.py管道配置
需重写open_spider(self, spider)和close_spider(self, spider)这两个父类方法,它们仅在爬虫启动和结束时各执行一次。在process_item方法中,务必保留return item语句,因为若配置了多个管道类,该语句会自动将Item对象传递给优先级低于当前管道的下一个管道类。
from itemadapter import ItemAdapter
class BossprojectPipeline:

 def __init__(self):
 self.fp = None

 # 重写父类方法,只调用一次
 def open_spider(self,spider):
 print("爬虫开始")
 self.fp = open('./lishipin.txt','w')

 # 接受爬虫文件中yield传递来的item对象,将item中的内容持久化存储
 def process_item(self, item, spider):
 self.fp.write(item['title'] + '\n\t' + item['des'] + '\n')

 # 如果有多个管道类,会将item传递给下一个管道类
 # 管道类的优先级取决于settings.py中的ITEM_PIPELINES属性中对应的值
  ## ITEM_PIPELINES = {'bossProject.pipelines.BossprojectPipeline': 300,} 键值中的值越小优先级越高
 return item

 # 重写父类方法,只调用一次
 def close_spider(self,spider):
 self.fp.close()
 print("爬虫结束")
4. 执行持久化存储
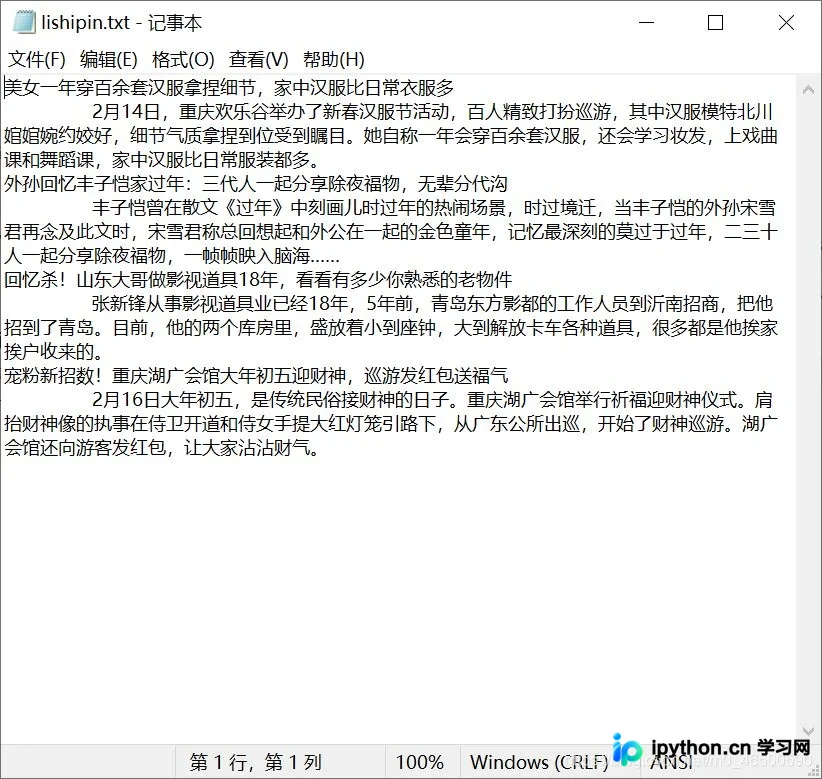
至此,关于Python Scrapy框架抓取梨视频数据的案例解析已完成。如需了解更多Python爬虫与Scrapy框架相关内容,请查阅本站过往文章或继续浏览后续教程,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















