


Python学习路线规划:从入门到进阶的阶段建议

学习 Python 的有效路径并非试图记住全部语法细节,而是按能力层次逐步推进:从核心语法与基本控制流切入,建立工程基础与代码规范,再过渡到面向对象与标准库底层机制,最后根据应用场景选定进阶方向。本文按顺序拆解各个学习阶段的具体目标、可执行任务与避坑建议。
阶段一:语法基础与思维过渡(第 1~3 周)
初学阶段的核心目标是掌握 Python 的基本语法表达,并理解代码的顺序、分支和循环结构。这一时期的重点不在于写出多么复杂的算法,而在于能够将现实中的简单逻辑翻译成语法正确的代码。
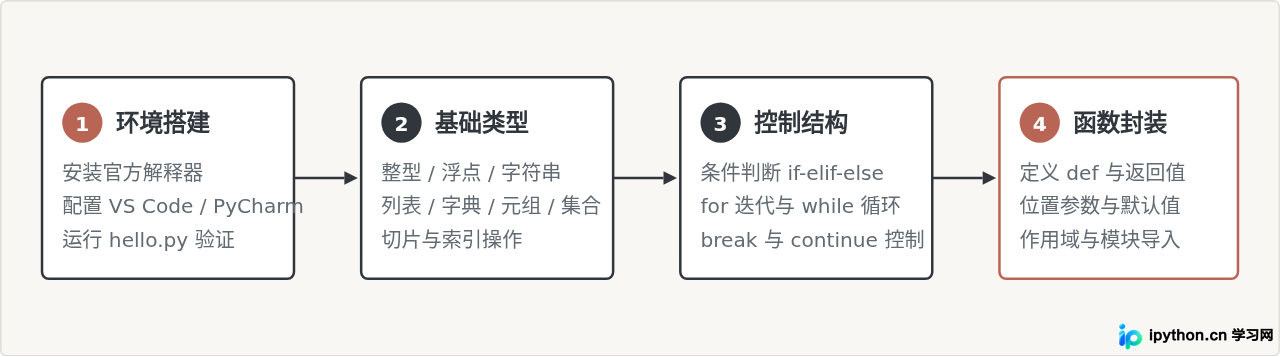
必须掌握的基础内容
- 数据类型与容器:熟悉数值、布尔值、字符串的常见操作;理解列表(List)、元组(Tuple)、字典(Dictionary)和集合(Set)在元素修改权限、查找效率上的本质差异。
- 控制流:熟练使用
for遍历序列,理解range()的左右边界特性,掌握while循环的终止条件设定。 - 基础输入输出与文件操作:会用
input()和print()进行交互,使用with open(...)语句安全读写文本文件,避免文件句柄泄漏。
入门阶段的代码练习应当小而明确。例如,通过解析简单的文本日志来计算出现频次:
# 统计字符串中每个单词出现的次数
text = "python python script code logic logic python"
word_counts = {}

for word in text.split():
    if word in word_counts:
        word_counts[word] += 1
    else:
        word_counts[word] = 1

print(word_counts)很多初学者在刚接触列表时,容易误用 for item in list_a: list_a.remove(item) 在遍历的同时原地删除元素。在 Python 中,遍历过程中改变列表长度会导致索引偏移,进而漏掉部分元素。正确的做法是生成新列表或使用列表推导式过滤。
阶段二:工程规范与模块化组织(第 4~6 周)
能够写出单文件脚本后,学习者面临的下一个门槛是如何管理多文件项目。这个阶段的重点是从“随手写代码”转向“按工程规范写代码”,学会使用隔离环境和第三方包。
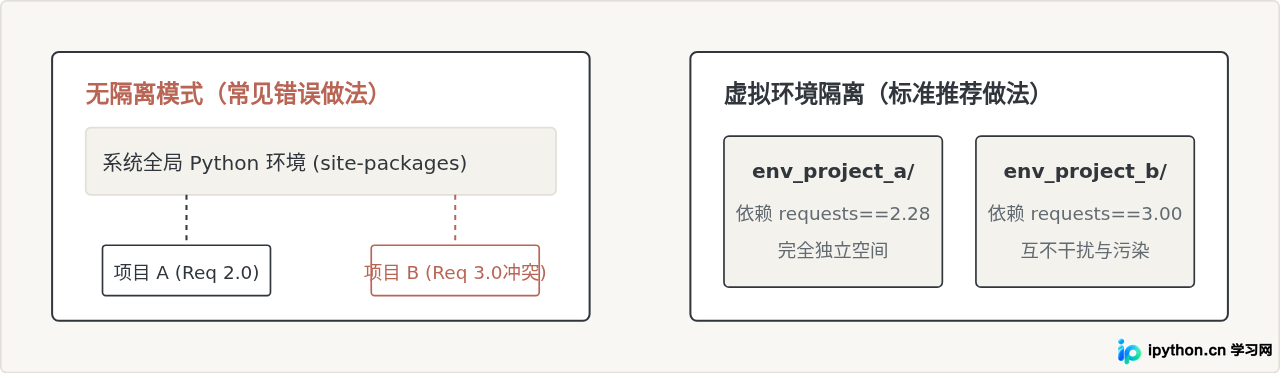
规范开发必备的操作流
每个独立项目都应该拥有专属的虚拟环境。在终端中执行以下命令创建并激活虚拟环境:
# 创建名为 .venv 的虚拟环境目录
python -m venv .venv

# 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate

# 激活虚拟环境 (Windows PowerShell)
.venv\Scripts\Activate.ps1

# 在隔离环境中安装第三方库并固化版本
pip install requests
pip freeze > requirements.txt
除了虚拟环境,这一阶段还需要建立标准的代码组织意识:拆分模块、使用 __name__ == "__main__" 控制执行入口、遵循 PEP 8 命名规范(如函数与变量用下划线命名、类名用大驼峰)。
阶段三:核心机制与进阶特性(第 7~10 周)
掌握基本工程管理后,需要深入理解 Python 语言的运行机制。进阶阶段的学习不再是“怎么调用”,而是“底层如何生效”,重点涵盖面向对象编程(OOP)、闭包与装饰器、生成器以及异常传播机制。
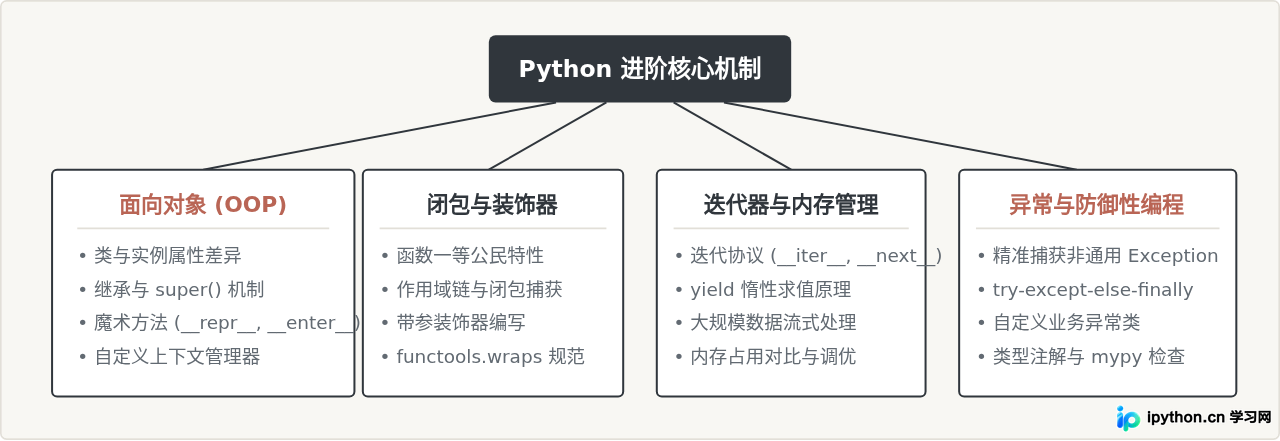
理解关键特性:生成器与内存节约
处理海量数据时,如果一次性将整个列表载入内存,极易导致内存耗尽。生成器通过 yield 实现了按需计算的惰性求值:
# 传统列表:一次性在内存中分配 1,000,000 个整数
def get_large_list():
    return [i for i in range(1000000)]

# 生成器:每次循环仅产生一个元素,空间复杂度保持在 O(1)
def generate_large_stream():
    for i in range(1000000):
        yield i

stream = generate_large_stream()
first_value = next(stream)  # 输出 0
通过生成器,我们可以用极小的内存开销,连续读取数 GB 大小的日志文件或数据库分批拉取的结果。
阶段四:方向分化与业务进阶(第 11 周及以后)
在熟练掌握核心语法与机制之后,通用学习阶段便告一段落。Python 在不同技术领域拥有截然不同的技术栈和底层需求,需要根据实际工作目标选择合适的分支进行针对性深入。
| 应用方向 | 核心工具与框架 | 重点掌握的底层技能 | 常见落地项目 |
|---|---|---|---|
| Web 后端开发 | FastAPI, Django, SQLAlchemy, Celery | HTTP 协议、关系型数据库设计、异步 I/O (asyncio)、缓存机制 | RESTful API 服务、后台管理系统、多任务队列 |
| 数据分析与科学计算 | Pandas, NumPy, Matplotlib, Seaborn | 矩阵运算基础、向量化计算、数据清洗与聚合、统计分析 | 销售报表自动生成、业务指标看板、探索性数据分析 |
| 自动化与运维脚本 | Requests, Playwright, Paramiko, Click | 命令行工具开发、跨平台系统调用、并发请求控制、定时调度 | 服务器巡检、多系统数据对账同步、Web 流程自动化 |
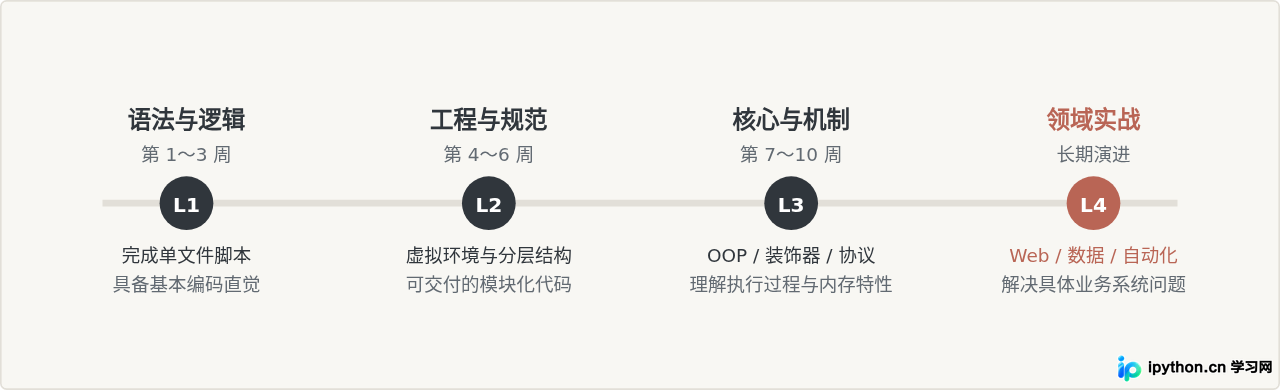
贯穿全程的两个学习原则
- 先有需求再选轮子:避免把时间耗费在死记硬背各个第三方库的全部 API 上。标准流程是先确定任务目标(例如提取网页表格),再去查阅对应工具(如 BeautifulSoup 或 Pandas)的具体方法,通过实操沉淀经验。
- 重视官方文档与源码:第三方教程容易因版本迭代而失效。遇到不符合预期的行为时,优先查阅 Python 官方文档(docs.python.org),并学会使用编辑器的跳转定义功能阅读依赖库源码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















