


零基础Python学习路线图:从环境搭建到进阶应用的阶段规划
针对零基础学习者的Python全阶段学习路线规划,涵盖从解释器安装、虚拟环境配置、核心语法掌握、工程化进阶到专项应用选型的完整路径与避坑指南。
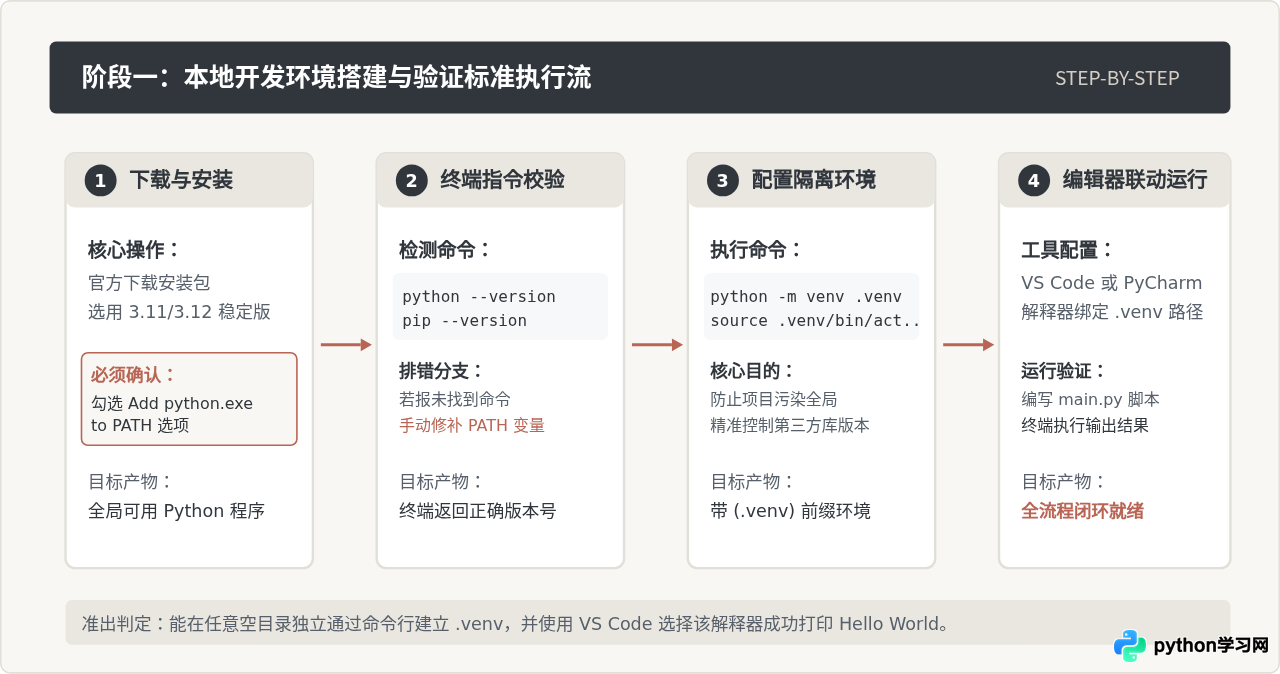
阶段一:开发环境搭建与工具链验证
学习任何编程语言的第一步,都是建立一个干净、稳定且符合现代工程规范的本地开发环境。许多初学者在此阶段遇到问题,往往是因为操作系统权限不足、多版本解释器共存混乱,或是未能正确配置系统环境变量。
1. Python 解释器的获取与安装配置
前往 Python 官方网站(python.org)下载最新的稳定版本(如 3.11 或 3.12 系列)。在 Windows 操作系统中安装时,必须在安装引导界面的首页勾选 Add python.exe to PATH 复选框。若漏选该项,终端将无法直接识别 python 命令。在 macOS 与 Linux 环境下,系统可能自带过时的 Python 2 或被系统组件依赖的 Python 3,建议通过官方包或包管理器独立安装最新版本,并通过命令明确区分。
2. 命令行环境验证
安装完成后,打开操作系统的命令行终端(Windows 上的 PowerShell 或 Terminal,macOS 上的 Terminal),输入以下命令检查环境:
# 检查 Python 解释器版本
python --version
# 或在部分 Unix 系统中使用:
python3 --version

# 检查配套包管理器 pip
pip --version
预期输出示例:
Python 3.12.2
pip 24.0 from .../site-packages/pip (python 3.12)
若终端提示“'python' 不是内部或外部命令”,说明环境变量 PATH 缺失,需要手动将 Python 安装路径及 Scripts 目录添加到系统的用户环境变量中。
3. 虚拟环境(venv)与依赖隔离
许多初学者习惯直接使用全局 pip install package 安装第三方库,这会在后续多项目开发时造成依赖冲突。现代 Python 开发的强制规范是在项目根目录创建独立的虚拟环境:
# 创建项目目录并进入
mkdir my_project
cd my_project

# 创建名为 .venv 的虚拟环境
python -m venv .venv

# 激活虚拟环境 (Windows PowerShell)
.venv\Scripts\Activate.ps1

# 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate
激活后,终端提示符前会出现 (.venv) 标识,此时所有通过 pip 安装的依赖均被严格隔离在当前项目目录内。
阶段二:核心语法与编程逻辑建立
环境就绪后,学习重心转移到基础语法。初学者需要建立的核心能力不是死记硬背关键字,而是理解“数据在内存中如何被存储与引用”以及“程序如何根据条件控制执行逻辑”。
1. 变量与内存模型
在 Python 中,变量本质上是绑定到内存对象的“标签”,而非存储数据的盒子。这一特性决定了 Python 的对象分为“可变类型”(Mutable)与“不可变类型”(Immutable)。
- 不可变类型:
int、float、str、tuple。对其进行修改会创建新的对象并重新绑定引用。 - 可变类型:
list、dict、set。可在原内存地址上进行增删改查。
理解可变性是避免逻辑 Bug 的基础。例如将可变列表作为函数默认参数时,若不了解引用共享机制,会导致多次调用共享同一状态的隐蔽问题。
2. 复合数据结构的选择与应用场景
| 数据结构 | 语法表示 | 是否有序 | 是否允许重复 | 典型应用场景 |
|---|---|---|---|---|
| 列表 (list) | [1, 2, 3] |
有序 | 允许 | 顺序数据流、需要按索引访问或切片的数据 |
| 字典 (dict) | {"key": "value"} |
键有序 (3.7+) | 键唯一,值允许重复 | 快速键值查找(O(1)复杂度)、结构化实体表示 |
| 集合 (set) | {1, 2, 3} |
无序 | 不允许 | 元素去重、数学集合运算(交集、并集、差集) |
| 元组 (tuple) | (1, 2) |
有序 | 允许 | 固定记录(如经纬度坐标)、函数多返回值封装 |
3. 控制流、函数与异常处理机制
编写实际可用的代码依赖三个关键控制结构:
- 条件与循环: 熟练使用
if/elif/else分支,以及基于可迭代对象的for ... in循环。尽量避免在循环体中直接修改正在被迭代的列表。 - 纯函数设计: 明确函数的输入(参数)与输出(返回值),遵循单一职责原则,保持局部作用域干净,避免对全局变量的随意修改。
- 健壮的异常防御: 不要使用宽泛的裸
except:吞掉所有错误,应当捕获具体异常类型,例如针对文件操作使用FileNotFoundError,针对类型转换使用ValueError。
# 规范的文件读取与数据处理范式
def read_and_parse_numbers(file_path: str) -> list[int]:
    """读取指定文本文件中的整数行,忽略空行和无效行"""
    valid_numbers = []
    try:
        with open(file_path, "r", encoding="utf-8") as file:
            for line_no, raw_line in enumerate(file, start=1):
                cleaned = raw_line.strip()
                if not cleaned:
                    continue
                try:
                    valid_numbers.append(int(cleaned))
                except ValueError:
                    print(f"警告:第 {line_no} 行内容 '{cleaned}' 无法转换为整数,已跳过")
    except FileNotFoundError:
        print(f"错误:目标文件 '{file_path}' 不存在")
        return []
    return valid_numbers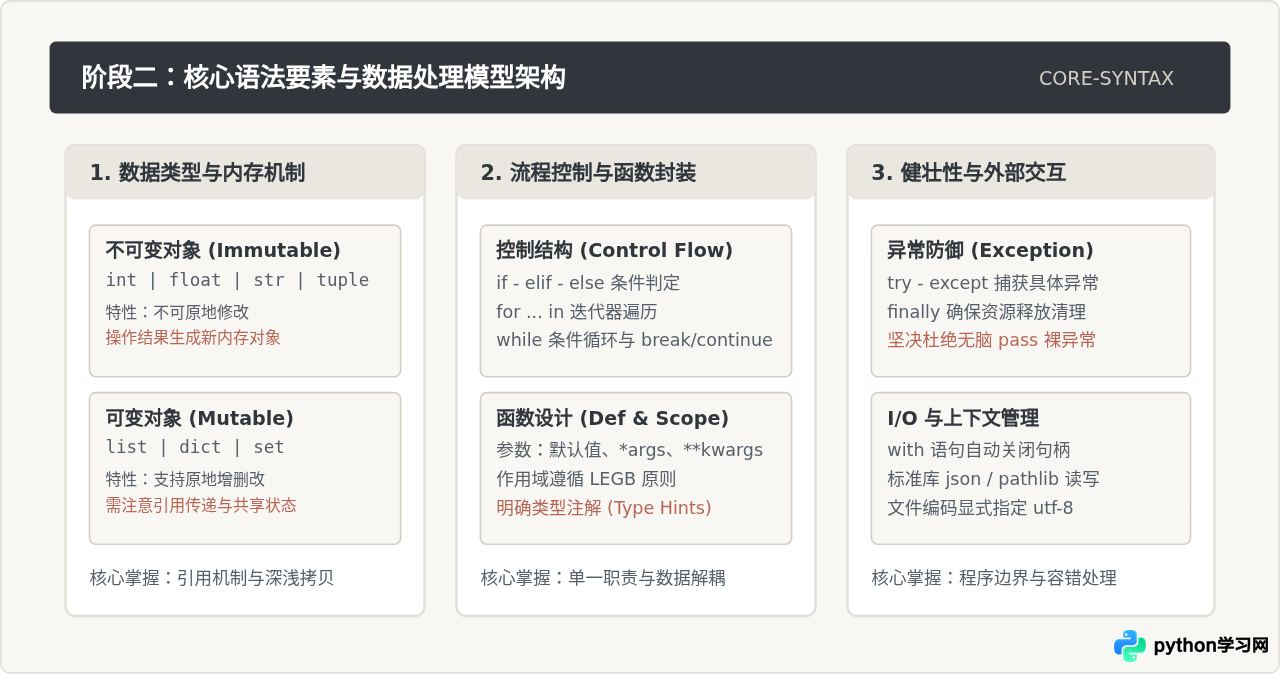
阶段三:面向对象与工程化进阶
当能熟练编写百行以内的独立脚本后,许多初学者会遭遇“代码难以复用、修改一处导致多处故障”的困境。阶段三的重点是从“单文件线性思维”跃迁到“模块化与工程化思维”。
1. 面向对象编程(OOP)的适度应用
面向对象的核心价值在于将状态(属性)与行为(方法)内聚在同一实体中。初学者应当掌握类的定义、初始化方法 __init__、实例方法以及基本的封装,但切忌过度设计:在 Python 中,若一组操作没有持久化的内部状态,简单的纯函数往往优于空洞的单方法类。
class DataRecorder:
    """封装包含统计状态的数据记录器"""
    def __init__(self, name: str) -> None:
        self.name = name
        self._records: list[float] = []

    def add_entry(self, value: float) -> None:
        if value < 0:
            raise ValueError(f"记录值不可为负数: {value}")
        self._records.append(value)

    @property
    def average(self) -> float:
        if not self._records:
            return 0.0
        return sum(self._records) / len(self._records)
2. 规范的工程目录结构
摆脱“所有逻辑堆放在 test.py 中”的习惯,构建清晰的模块层级。典型的生产级项目结构如下:
my_project/
├── .venv/                  # 独立虚拟环境
├── src/                    # 业务源码目录
│   └── my_project/
│       ├── __init__.py     # 标识为 Python 包
│       ├── core.py         # 核心业务算法
│       └── utils.py        # 辅助通用工具函数
├── tests/                  # 单元测试目录
│   ├── __init__.py
│   └── test_core.py        # 针对 core.py 的测试用例
├── .gitignore              # Git 忽略文件(过滤 .venv、__pycache__ 等)
├── README.md               # 项目使用说明
└── requirements.txt        # 依赖清单(或 pyproject.toml)
3. 单元测试与基础调试
验证代码正确性的手段应从“手工改代码并 print 观察”转向自动化测试。Python 自带 unittest 框架,但在工业界更推荐使用轻量灵活的 pytest:
# tests/test_core.py
import pytest
from my_project.core import calculate_tax

def test_calculate_tax_normal():
    # 测试常规税率计算
    result = calculate_tax(amount=100.0, rate=0.1)
    assert result == 10.0

def test_calculate_tax_negative_amount():
    # 测试异常输入防护
    with pytest.raises(ValueError):
        calculate_tax(amount=-50.0, rate=0.1)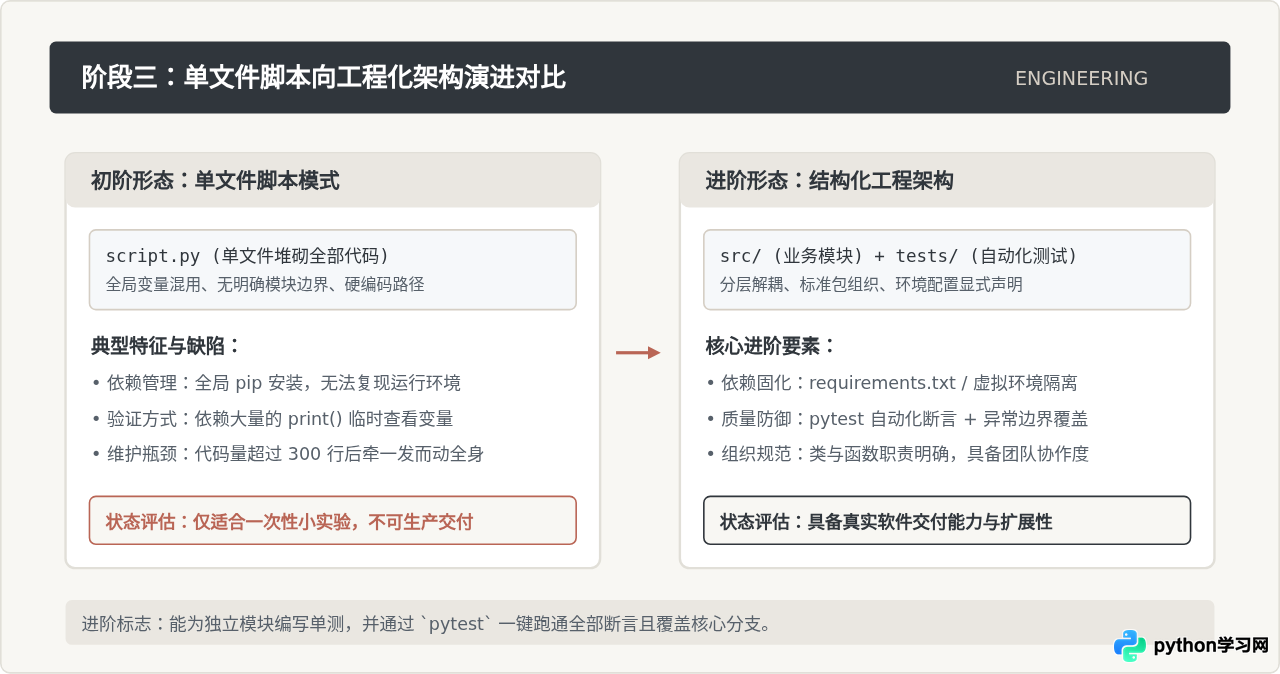
阶段四:专项进阶方向选型与实战落地
具备工程基础后,切忌继续无休止地泛读通用语法书,而应根据自身的实际需求或职业规划,选择一个明确的垂直领域进行深度实战。不同应用方向对底层技术的要求存在显著差异。
1. 三大主流进阶方向对比
-
方向 A:数据分析与科学计算
适合需要处理批量业务数据、报表自动化或科研计算的读者。核心技术栈为Pandas(数据清洗与重构)、NumPy(矩阵计算与底层数值操作)以及Matplotlib / Seaborn(数据可视化)。该方向的重心在于数据处理效率与统计洞察。 -
方向 B:Web 后端与 API 服务开发
适合有产品开发诉求、需要构建云端服务或后台系统的读者。现代 Python 推荐优先掌握轻量高性能的FastAPI(基于类型注解与异步 ASGI),或功能全面的成熟框架Django。核心补充知识包括 HTTP 协议、关系型数据库(PostgreSQL/MySQL)与 ORM 映射机制。 -
方向 C:自动化运维与脚本工具链
适合系统管理员或希望提升日常办公效率的开发者。重点在于操作系统的深度交互(pathlib、subprocess)、网络请求与轻量爬虫(requests、httpx、playwright)以及计划任务集成。
2. 实战阶段的避坑准则
初学者在进阶阶段最常见的弯路是“照抄完整项目代码却不会独立搭建”。克服该问题的有效方式是“逆向渐进重构”:
- 先完整运行一个开源最小示例,理清从请求/输入到响应/输出的数据全链路;
- 关闭教程,尝试脱稿实现核心功能模块;
- 引入新需求(例如为数据分析脚本增加日志记录,或为 API 增加请求字段校验),在修改与排错中掌握工具边界。
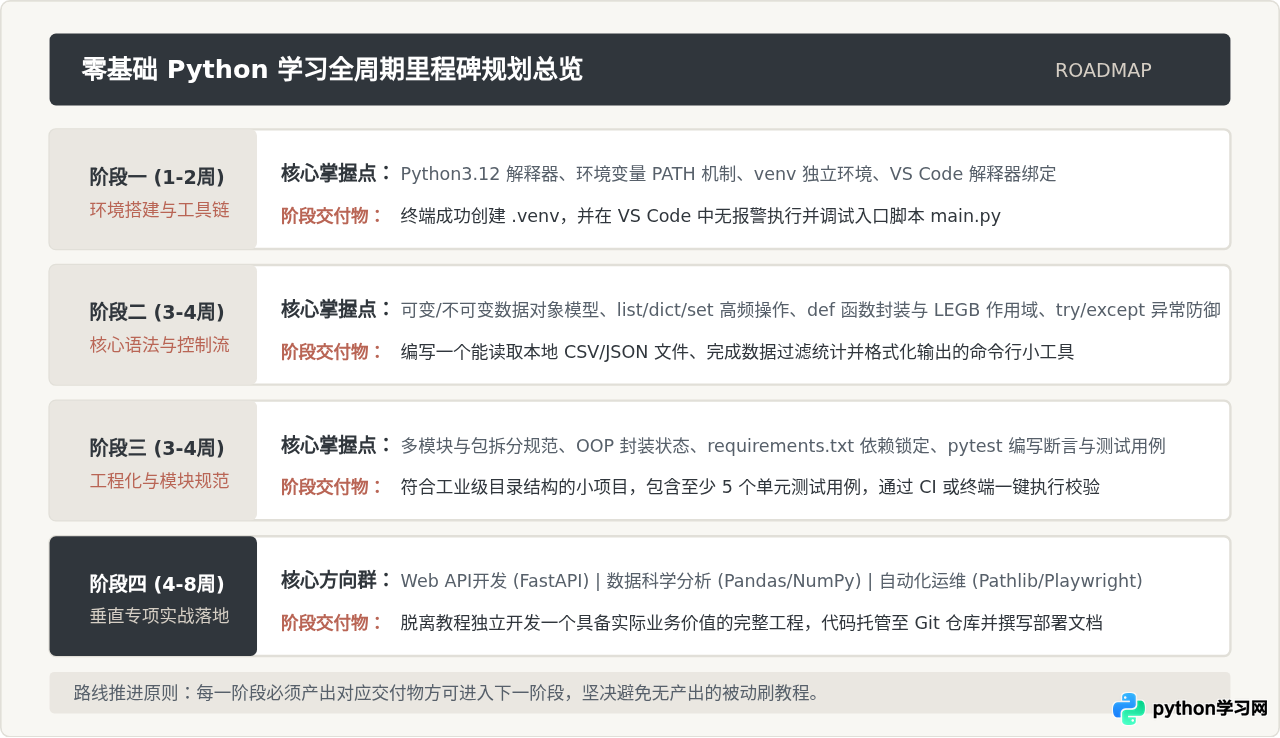
总结与日常学习心法
Python 学习的过程本质上是认知模型的迁移。将上述规划转化为个人技能的关键,在于坚持“小步快跑、交付驱动”:
- 拒绝被动接受: 看完一个语法小节,立刻在终端中主动抛出并捕获异常,验证报错信息,远比被动浏览有效;
- 保持环境干净: 牢记“一个新项目对应一个独立的虚拟环境”,这将在未来节省大量排查库版本冲突的时间;
- 重视报错日志: 遇到 Traceback 报错时,优先阅读最底部的一行异常类型与描述,再自底向上查找自己编写的文件路径与行号。调试报错本身就是最核心的编程实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















