


Python正则表达式实战:提取含特定字符串的文本行及清洗处理

发布时间:2026-10-14 |
4人浏览过
本文通过Python代码示例,演示如何利用正则表达式提取包含特定关键词(如pass)的文本行,并进一步展示如何清洗数据,去除行号、特定前缀及文件扩展名。同时补充了\d、\w、\s等常用正则元字符的匹配规则,适用于日志分析与文本清洗场景。
Python提取特定字符串文本的方法
近期在进行文本数据处理时,深刻体会到Python在数据处理领域的强大优势。下面直接通过具体案例进行分享。
首先查看原始数据,结构如下图所示。
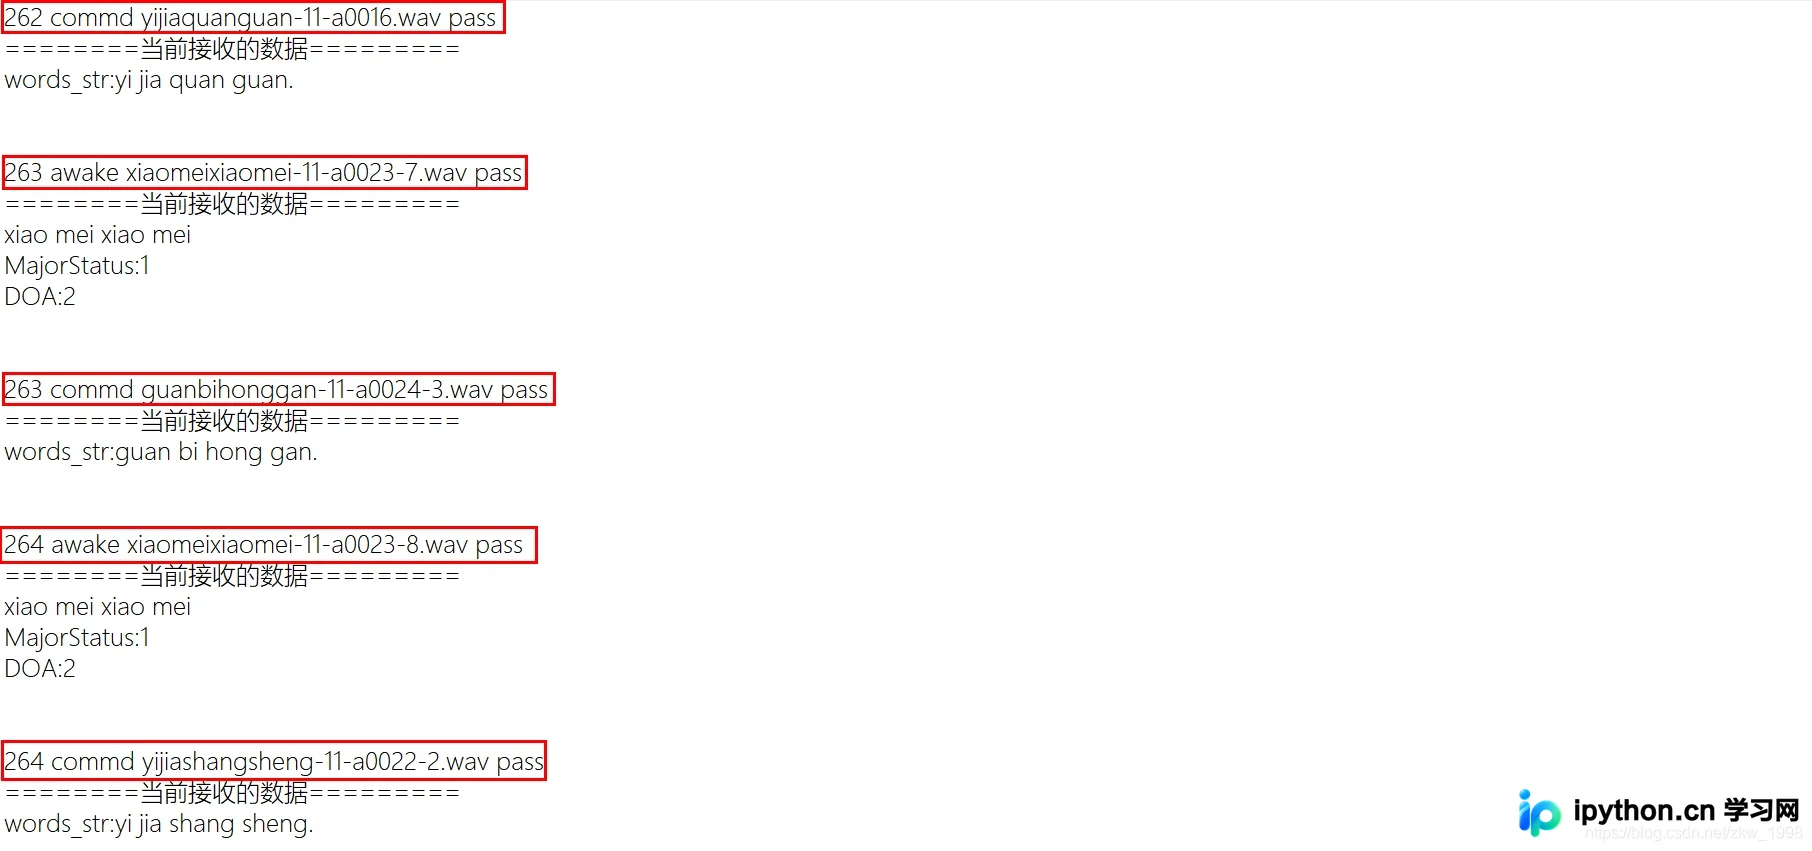
若需提取每行中包含“pass”关键字的字符串,可参考以下代码实现。
import re

filepath = "E:/untitled1/analyze_log/test.log"
txt = open(filepath, "r").read()

result=""
test_text = re.findall("..............+pass", txt)#取出每行含有pass的文本
result = result +'\n'.join(test_text)#换行输出
print(result)
运行上述代码后,即可获取所有包含“pass”的文本行,结果如图所示。
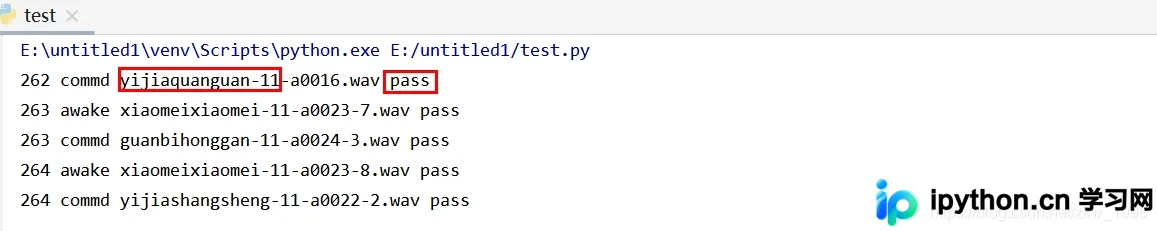
实际上,目标是从上述结果中提取红色框标注的具体内容,具体实现代码如下。
import re

filepath = "E:/untitled1/analyze_log/test.log"
txt = open(filepath, "r").read()

result=""
test_text = re.findall("..............+pass", txt)#取出每行含有pass的文本
result = result +'\n'.join(test_text)#换行输出
del_num = re.sub("\d+ ", "", result)#去掉每行行首的数字
del_awake = del_num.replace("awake", "")#去掉awake
del_commd = del_awake.replace("commd", "")#去掉commd
del_string1 = re.sub("-a+\d\d\d\d-\d.wav", "", del_commd)#去掉-a0023-1.wav类型的字符串
del_string2 = re.sub("-a+\d\d\d\d.wav", "", del_string1)#去掉-a0016.wav类型的字符串
print(del_string2)
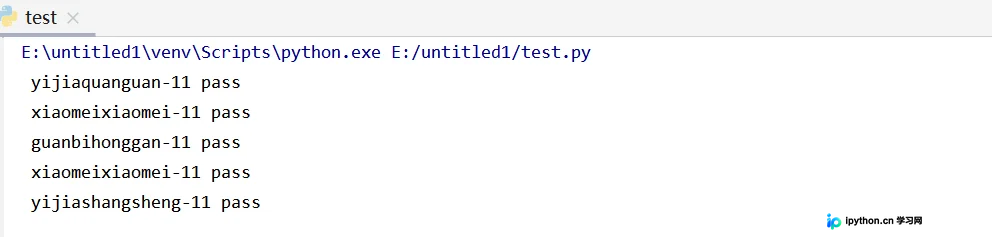
执行该代码后,即可得到最终所需的清洗后文本,效果如图所示。
正则表达式常用元字符详解
此外,还可以对正则表达式进行拓展学习。
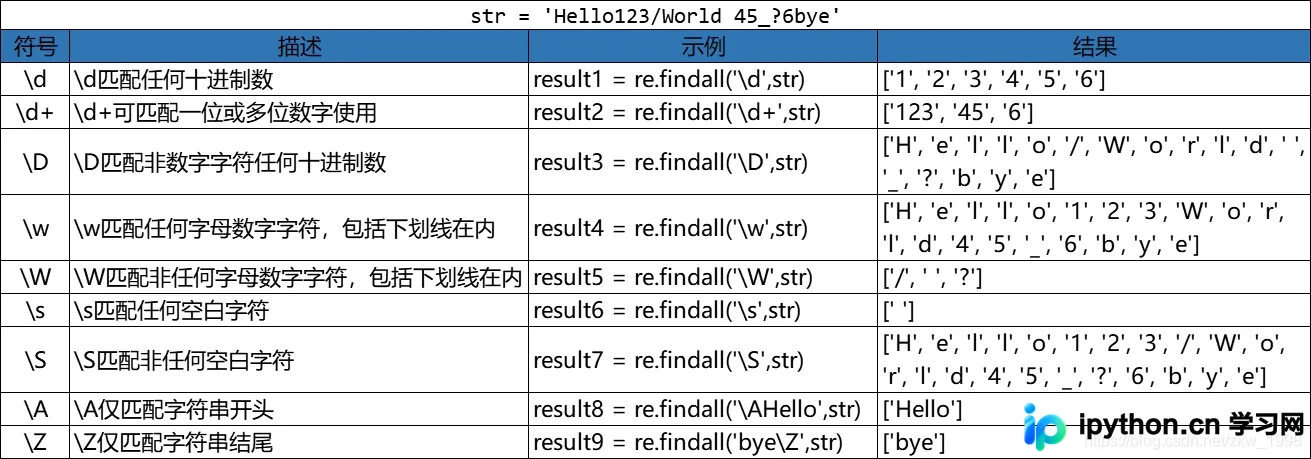
以下是相关的示例代码片段。
import re

str = 'Hello123/World 45_?6bye'
result1 = re.findall('\d',str)#\d匹配任何十进制数
result2 = re.findall('\d+',str)#\d+可匹配一位或多位数字使用
result3 = re.findall('\D',str)#\d匹配非数字字符任何十进制数
result4 = re.findall('\w',str)#\w匹配任何字母数字字符,包括下划线在内
result5 = re.findall('\W',str)#\W匹配非任何字母数字字符,包括下划线在内
result6 = re.findall('\s',str)#\s匹配任何空白字符
result7 = re.findall('\S',str)#\S匹配非任何空白字符
result8 = re.findall('\AHello',str)#\A仅匹配字符串开头
result9 = re.findall('bye\Z',str)#\Z仅匹配字符串结尾
print(result1)
print(result2)
print(result3)
print(result4)
print(result5)
print(result6)
print(result7)
print(result8)
print(result9)
后续将继续分享更多关于文本处理的博客文章,坚持边学边记,共同进步。
以上就是关于使用Python提取文本中特定字符串的完整介绍,更多相关Python字符串处理技巧可查阅本站往期文章或继续浏览后续内容,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















