


Python多线程调用百度API实现高效图片文字识别

发布时间:2026-10-14 |
4人浏览过
本文介绍如何使用Python结合百度AI开放平台OCR接口,通过多线程技术实现图片文字的高效批量识别。示例代码包含图片压缩预处理、队列管理及并发线程控制,实测在识别1500张高清小尺寸验证码图片时仅需30秒,虽存在少量错误率,但整体速度快且无乱码,适合对时效性要求较高的场景。
Python多线程调用百度API实现高效图片文字识别
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Created on Tue Jun 12 09:37:38 2018
利用百度api实现图片文本识别
@author: XnCSD
"""

import glob
from os import path
import os
from aip import AipOcr
from PIL import Image
from queue import Queue
import threading
import datetime

def convertimg(picfile, outdir):
  '''调整图片大小,对于过大的图片进行压缩
  picfile:  图片路径
  outdir:  图片输出路径
  '''
  img = Image.open(picfile)
  width, height = img.size
  while (width * height > 4000000): # 该数值压缩后的图片大约 两百多k
    width = width // 2
    height = height // 2
  new_img = img.resize((width, height), Image.BILINEAR)
  new_img.save(path.join(outdir, os.path.basename(picfile)))


def baiduOCR(ts_queue):
  """利用百度api识别文本,并保存提取的文字
  picfile:  图片文件名
  outfile:  输出文件
  """
  while not ts_queue.empty():
    picfile = ts_queue.get()
    filename = path.basename(picfile)
    outfile = 'D:\Study\pythonProject\scrapy\IpProxy\port_zidian.txt'
    APP_ID = '' # 刚才获取的 ID,下同
    API_KEY = ''
    SECRECT_KEY = ''
    client = AipOcr(APP_ID, API_KEY, SECRECT_KEY)

    i = open(picfile, 'rb')
    img = i.read()
    print("正在识别图片:\t" + filename)
    message = client.basicGeneral(img) # 通用文字识别,每天 50 000 次免费
    # message = client.basicAccurate(img)  # 通用文字高精度识别,每天 800 次免费
    #print("识别成功!")
    i.close()
    try:
      filename1 = filename.split('.')[0]
      filename1 = ''.join(filename1)
      with open(outfile, 'a+') as fo:
        for text in message.get('words_result'):
          fo.writelines('\'' + filename1 + '\'' + ':' + text.get('words') + ',')
          fo.writelines('\n')
        # fo.writelines("+" * 60 + '\n')
        # fo.writelines("识别图片:\t" + filename + "\n" * 2)
        # fo.writelines("文本内容:\n")
        # # 输出文本内容
        # for text in message.get('words_result'):
        #   fo.writelines(text.get('words') + '\n')
        # fo.writelines('\n' * 2)
      os.remove(filename)
      print("识别成功!")
    except:
      print('识别失败')


    print("文本导出成功!")
    print()
def duqu_tupian(dir):
  ts_queue = Queue(10000)

  outdir = dir
  # if path.exists(outfile):
  #   os.remove(outfile)
  if not path.exists(outdir):
    os.mkdir(outdir)
  print("压缩过大的图片...")
  # 首先对过大的图片进行压缩,以提高识别速度,将压缩的图片保存与临时文件夹中
  try:
    for picfile in glob.glob(r"D:\Study\pythonProject\scrapy\IpProxy\端口\*"):
      convertimg(picfile, outdir)
    print("图片识别...")
    for picfile in glob.glob("tmp/*"):
      ts_queue.put(picfile)
      #baiduOCR(picfile, outfile)
      #os.remove(picfile)
    print('图片文本提取结束!文本输出结果位于文件中。' )
    #os.removedirs(outdir)
    return ts_queue
  except:
    print('失败')

if __name__ == "__main__":

  start = datetime.datetime.now().replace(microsecond=0)
  t = 'tmp'
  s = duqu_tupian(t)
  threads = []
  for i in range(100):
    t = threading.Thread(target=baiduOCR, name='th-' + str(i), kwargs={'ts_queue': s})
    threads.append(t)
  for t in threads:
    t.start()
  for t in threads:
    t.join()
  end = datetime.datetime.now().replace(microsecond=0)
  print('删除耗时:' + str(end - start))
该方案执行速度较快,识别准确率可达99%。在100次尝试中,预计会出现一次识别错误。
实际测试表明,处理1500张高清小尺寸(类似验证码大小)的图片耗时约30秒。若处理量减少至150张,错误数量约为14张。尽管存在少量误差,但整体运行速度快,且不会生成乱码内容。
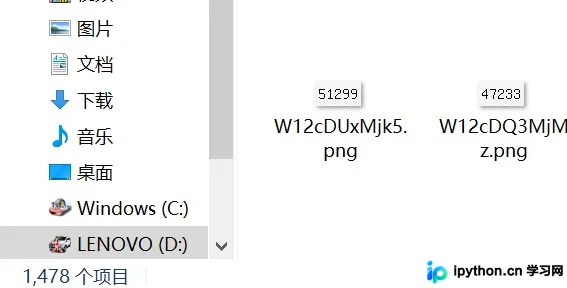
以上为Python利用百度API进行多线程图片文字识别的完整流程,如需了解更多Python图片文字识别相关内容,建议关注本站其他技术文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















