


JavaScript能做什么?从网页交互到Node.js全栈应用介绍

JavaScript 最初被设计为运行在浏览器内部的脚本语言,主要用于验证表单并响应用户的点击操作;而随着 V8 引擎与 Node.js 运行时环境的出现,它彻底打破了浏览器的沙箱边界,演进为一种覆盖浏览器页面控制、服务端接口构建、文件系统操作以及全栈工程协同的通用开发语言。本文将从前端运行时和后端运行时的双重视角,具体梳理 JavaScript 能够解决的实际业务场景、核心代码模型以及全栈工程的落地方式。
一、运行环境决定了 JavaScript 能做什么
在讨论 JavaScript 的功能范围时,如果脱离“运行环境”这个前提,往往会得出含混甚至相互矛盾的结论。比如初学者常问:“JavaScript 到底能不能读取本地文件?”答案是:在浏览器环境里不能任意读取,但在 Node.js 环境里这是最基础的能力之一。
JavaScript 语法本身(ECMAScript 规范)只定义了变量、控制流、函数、对象、闭包等逻辑规则。它能够调用的具体系统能力,完全取决于承载它的运行时(Runtime)提供了哪些底层 API。浏览器环境提供了对页面视图和网络通信的抽象,而 Node.js 环境则提供了操作系统级别的系统调用接入能力。
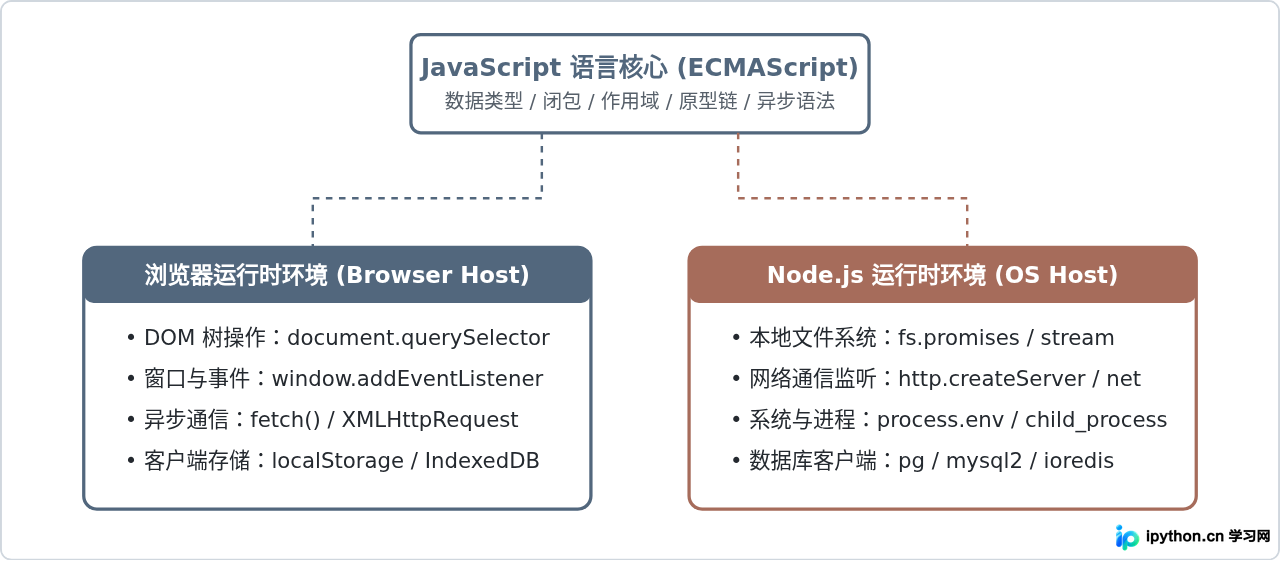
二、浏览器中:控制页面、捕获交互与无刷新通信
在 Web 前端开发中,HTML 负责承载内容骨架,CSS 负责呈现视觉样式,而 JavaScript 则赋予整个页面逻辑与动态行为。脱离 JavaScript 的网页几乎是静态的信息文档,而引入它之后,网页便能够对读者的输入做出即时反馈。
1. 响应用户事件与操作 DOM 节点
当用户在页面上点击按钮、滚动滚动条或输入字符时,浏览器引擎会将这些物理动作封装为事件对象。JavaScript 通过监听这些事件,实时读取用户输入并增删改查页面的 DOM 节点,使页面可以在无需重新加载的情况下呈现不同状态。
// 获取界面中的交互元素
const submitBtn = document.querySelector('#submit-btn');
const inputField = document.querySelector('#username-input');
const resultContainer = document.querySelector('#status-area');

// 绑定事件并修改 DOM 状态
submitBtn.addEventListener('click', () => {
  const username = inputField.value.trim();
  if (!username) {
    resultContainer.textContent = '用户名不能为空!';
    resultContainer.style.color = '#A66C5B';
    return;
  }

  resultContainer.textContent = `欢迎回来,${username}`;
  resultContainer.style.color = '#52677D';
});
2. 使用 Fetch 进行异步局部刷新
传统的 Web 交互在提交表单时必须刷新整个页面并重新下载整个 HTML。JavaScript 引入了网络请求接口(早期是 XMLHttpRequest,现代标准为 fetch),允许页面在后台静默发起 HTTP 请求,拿到结构化数据(如 JSON)后直接更新局部视图。
async function fetchUserProfile(userId) {
  try {
    const response = await fetch(`https://api.example.com/users/${userId}`);
    if (!response.ok) {
      throw new Error(`网络响应异常: 状态码 ${response.status}`);
    }
    const userData = await response.json();
    document.querySelector('#profile-name').textContent = userData.name;
    document.querySelector('#profile-role').textContent = userData.role;
  } catch (error) {
    console.error('拉取用户资料失败:', error.message);
  }
}fetch 时,如果目标接口域名、协议或端口与当前页面不一致,会受到浏览器“同源策略”(CORS)的安全约束,需要服务端正确配置允许跨域头信息方可顺利取数。
三、Node.js 环境:开发服务端接口与操作系统底层交互
2009 年发布的 Node.js 将 Chrome 的 V8 JavaScript 引擎搬到了操作系统层级,并为其注入了 C++ 编写的底层扩展。自此,JavaScript 不再受制于浏览器的安全沙盒,获得了操作文件读写、创建 TCP/HTTP 监听以及操纵系统进程的权限。
1. 构建无依赖的轻量 HTTP API 服务
开发者仅需使用 Node.js 内置的核心模块 node:http,就能在短时间内拉起一个具备路由处理和 JSON 数据分发能力的轻量级接口服务:
// 文件名:server.js
// 执行环境:Node.js (Node 18+)
import http from 'node:http';

const server = http.createServer((req, res) => {
  // 设置响应头与跨域配置
  res.setHeader('Content-Type', 'application/json; charset=utf-8');

  // 解析请求路由
  if (req.method === 'GET' && req.url === '/api/health') {
    res.writeHead(200);
    res.end(JSON.stringify({ status: 'ok', timestamp: Date.now() }));
    return;
  }

  // 默认兜底 404
  res.writeHead(404);
  res.end(JSON.stringify({ error: 'NotFound', message: '请求的路径不存在' }));
});

// 监听本地 3000 端口
const PORT = 3000;
server.listen(PORT, () => {
  console.log(`服务端已启动,监听地址: http://127.0.0.1:${PORT}`);
});
在终端内直接执行该脚本,并使用 curl 进行访问验证:
node server.js
# 在另一个终端窗口执行测试验证:
curl -i http://127.0.0.1:3000/api/healthHTTP/1.1 200 OK
Content-Type: application/json; charset=utf-8
Date: Wed, 16 Sep 2026 06:22:18 GMT
Connection: keep-alive
{"status":"ok","timestamp":1789549338000}
2. 本地文件与自动化脚本处理
Node.js 的另一个重要落地点是工程脚本与自动化运维。例如读取本地日志文件、清理临时目录、统计大文件字节流等,这在以前通常需要 Bash 或 Python 完成,现在完全可以使用 JavaScript 统一书写:
// 文件名:log-analyzer.js
import fs from 'node:fs/promises';
import path from 'node:path';

async function countAccessLogs(filePath) {
  try {
    const absolutePath = path.resolve(filePath);
    const content = await fs.readFile(absolutePath, 'utf-8');
    const lines = content.split('\n').filter(line => line.trim().length > 0);

    console.log(`文件读取成功: ${absolutePath}`);
    console.log(`有效日志行数: ${lines.length}`);
  } catch (err) {
    if (err.code === 'ENOENT') {
      console.error('目标文件不存在,请核查路径。');
    } else {
      console.error('读取文件过程中发生未预期异常:', err.message);
    }
  }
}

countAccessLogs('./access.log');
四、理解全栈数据闭环:从用户触发到数据持久化
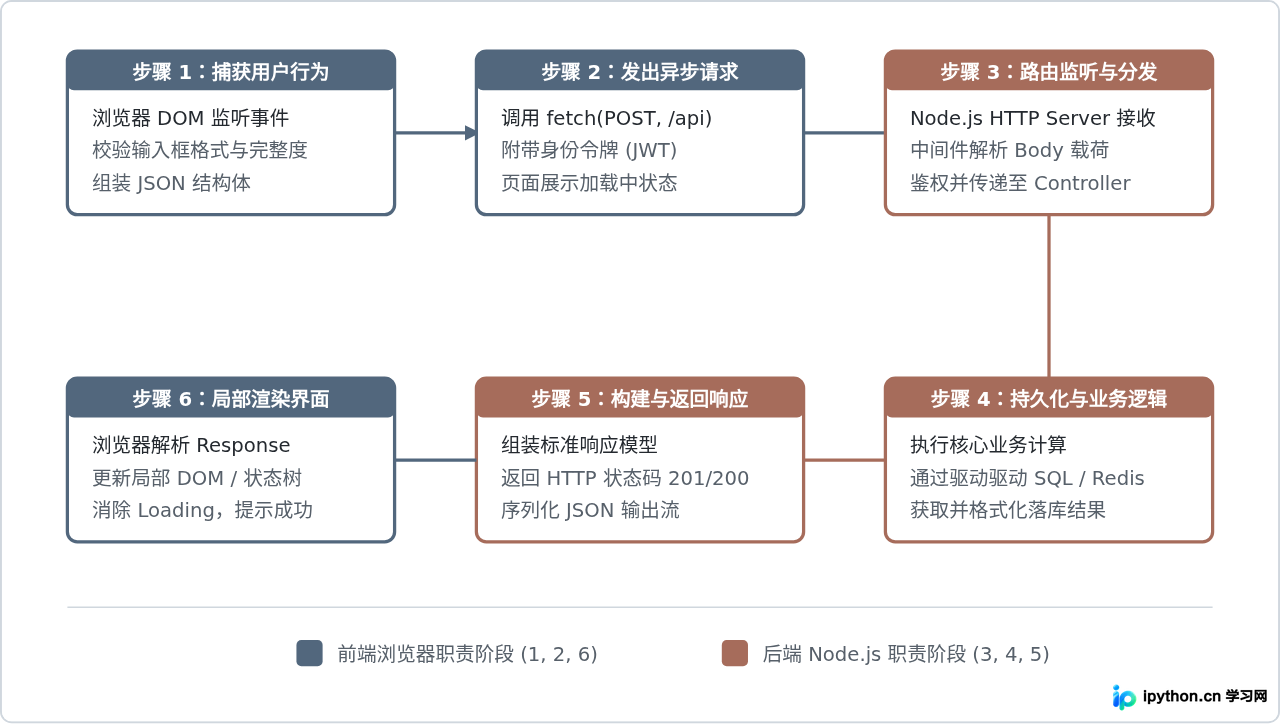
所谓“全栈”,并不只是指同时能写网页和后台,更核心的是指打通全链路的数据闭环。在纯 JavaScript 技术栈下,前端客户端与后端服务端可以共享数据结构定义(如 TypeScript 类型文件)、校验规则以及通用工具函数。
下面这幅流程图完整展示了一个现代 Web 系统处理业务请求的六步操作过程:
五、运行机制对比:事件循环与异步非阻塞 I/O
无论是浏览器还是 Node.js,JavaScript 主线程的核心模型都是单线程事件循环(Event Loop)。理解这套机制,是掌握 JavaScript 能做什么以及“不适合做什么”的分水岭。
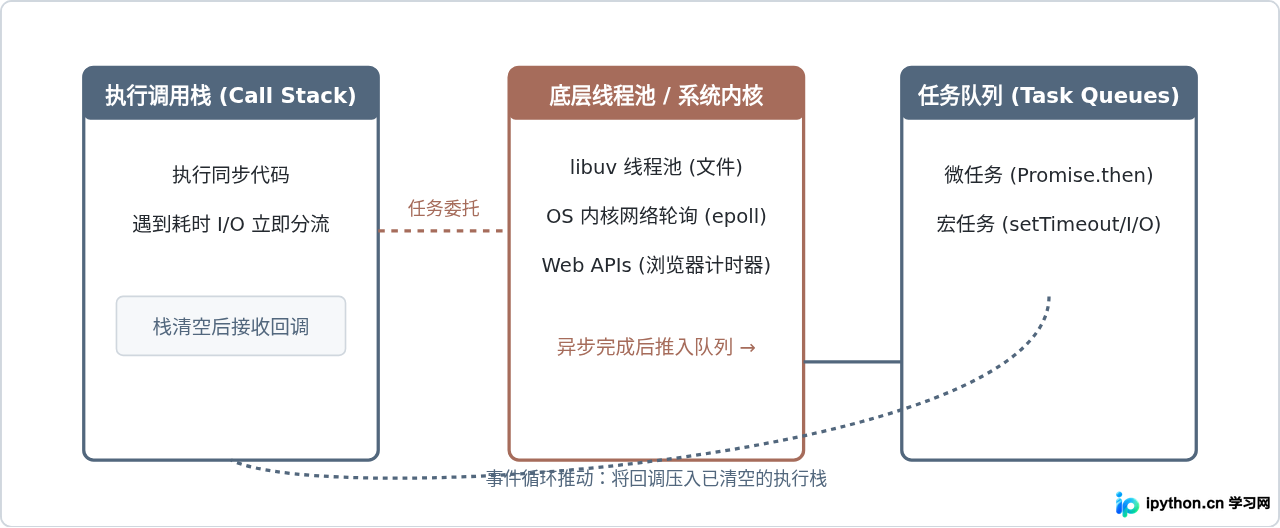
传统的单线程模型在读取大文件或发起网络调用时会卡住主线程;而 JavaScript 处理这类任务时,只是把 I/O 操作委托给操作系统的多路复用接口或 libuv 线程池,自己继续执行后续代码。当底层 I/O 就绪后,系统会通过任务队列将回调放回主线程执行。
这种机制让 JavaScript 极其擅长处理高并发、高 I/O 密集型的业务(如聊天服务、轻量网关、API 数据聚合),但在面对重度 CPU 密集型任务(如大规模音视频转码、重型三维网格计算)时,单线程主循环极易被长任务阻塞,导致所有后续请求超时排队。
六、边界与选型依据:什么时候用,什么时候不用
没有任何一种技术是全能的。根据上述底层特性,我们可以明确区分 JavaScript 全栈方案在实际生产环境中的适用边界与替代选择:
| 业务场景类型 | 是否适合使用 JavaScript / Node.js | 实际运行表现与技术原因 |
|---|---|---|
| Web 客户端界面与富交互 | 必须使用(事实标准) | 拥有浏览器原生 API 支持,生态完全成熟,无其他主流替代方案。 |
| 高并发 API 网关 / 数据聚合层 (BFF) | 非常适合 | 非阻塞 I/O 能在低内存开销下承载大量并发连接;与前端数据格式天然统一。 |
| 文件自动化工具 / 构建脚本 | 非常适合 | npm 生态极为庞大,现成脚手架工具链丰富,上手成本低。 |
| 复杂 3D 渲染 / 机器视觉 / 视频转码 | 不推荐作为核心引擎 | CPU 密集计算会锁死事件循环主线程;底层推荐使用 C++、Rust 或 GPU 驱动。 |
| 底层操作系统驱动 / 嵌入式硬实时 | 不适合 | V8 垃圾回收(GC)机制会引入不可预测的短暂挂起,无法满足硬实时要求。 |
七、总结:JavaScript 能做什么的能力全景
回顾开头提出的问题,“JavaScript 能做什么”的边界其实一直在随着运行时宿主的升级而扩展。从早期的浏览器“网页玩具”,到如今的“跨端全栈工程语言”,其技术版图可以系统总结为以下五个核心支撑维度:
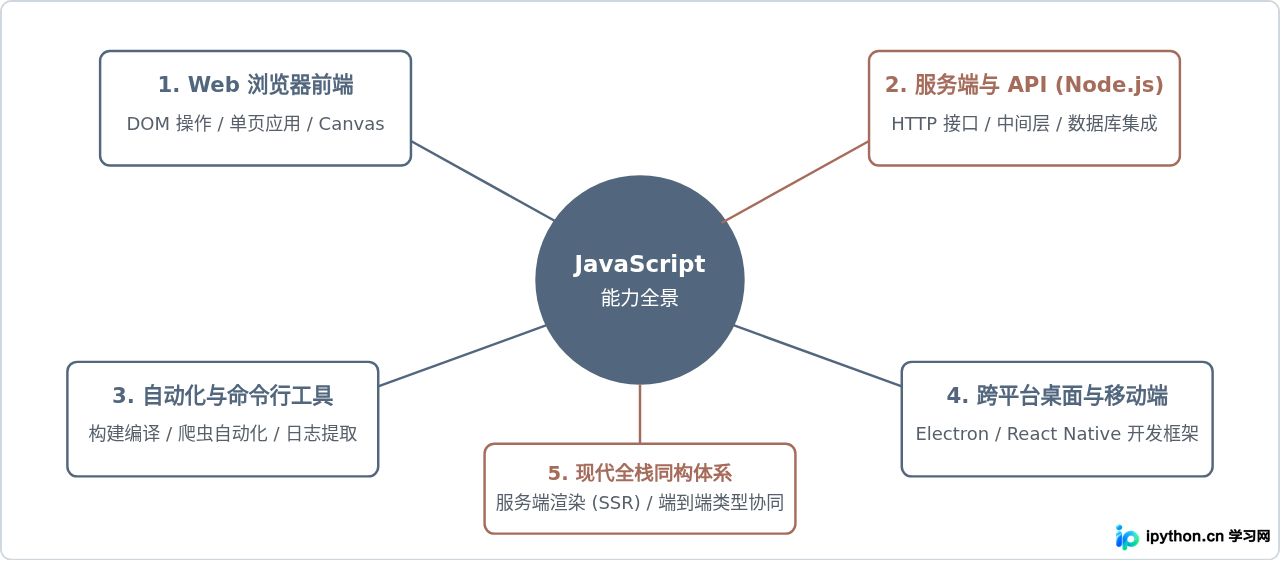
学习与使用 JavaScript 的正确路径,是首先明确目标代码的执行载体:如果是在浏览器内执行,重点掌握 DOM、事件、网络请求与页面性能;如果是在 Node.js 环境下执行,重点掌握模块管理、文件与网络 I/O、异步生命周期以及服务稳定性。当两者通过统一的语言习惯无缝衔接时,就构成了现代软件工程中极为高效的全栈开发闭环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















