


怎么将Python爬取的所有网页保存为本地可离线浏览的HTML结构

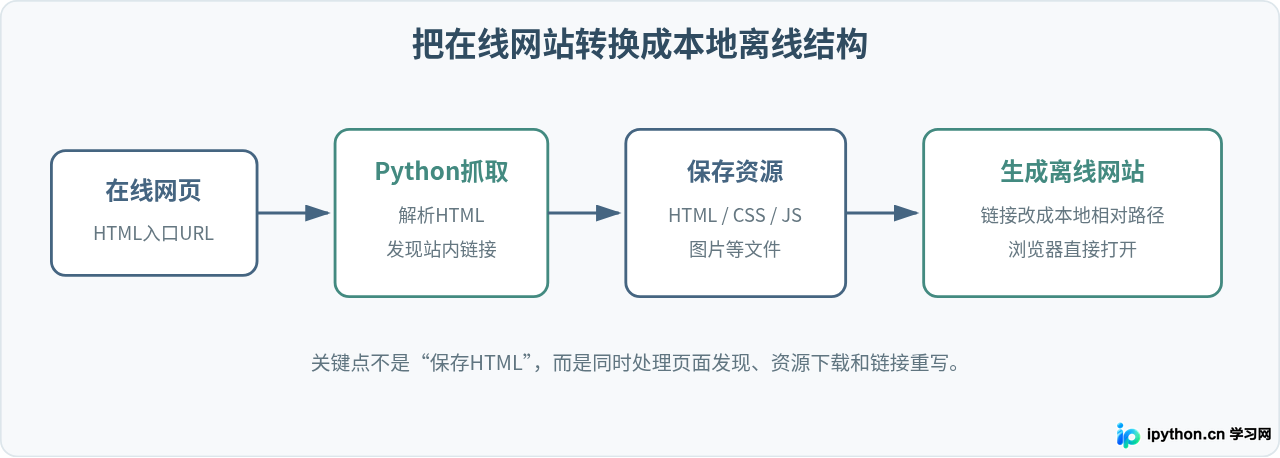
要把Python爬取的网站真正保存成可以离线浏览的HTML结构,不能只把服务器返回的HTML文本写入文件。比较完整的做法是:遍历站内页面,把每个URL映射成本地HTML文件,同时下载CSS、JavaScript、图片等静态资源,再把HTML中的页面链接和资源地址改成本地相对路径。
处理完成后,本地目录会像一个静态网站。例如打开offline_site/index.html,点击页面中的栏目、文章和分页链接时,不再访问原网站,而是继续打开本地保存的HTML文件。
一、为什么直接保存requests获取的HTML还不够
最简单的网页保存代码通常是下面这样:
import requests

url = "https://example.com/"
html = requests.get(url).text

with open("index.html", "w", encoding="utf-8") as f:
    f.write(html)
这种方法确实能够生成一个HTML文件,但打开后经常会出现几个问题:
- 点击文章链接后仍然跳转到原网站。
- CSS、JavaScript和图片仍然从原网站加载。
- 断开网络后,页面样式或者图片消失。
- 只保存了入口页,没有自动保存栏目页、文章页和分页。
- 不同URL不知道应该映射成本地哪个文件。
因此,要得到真正可以离线浏览的HTML目录,需要建立URL与本地文件之间的映射关系。
二、先确定本地HTML目录应该怎么保存
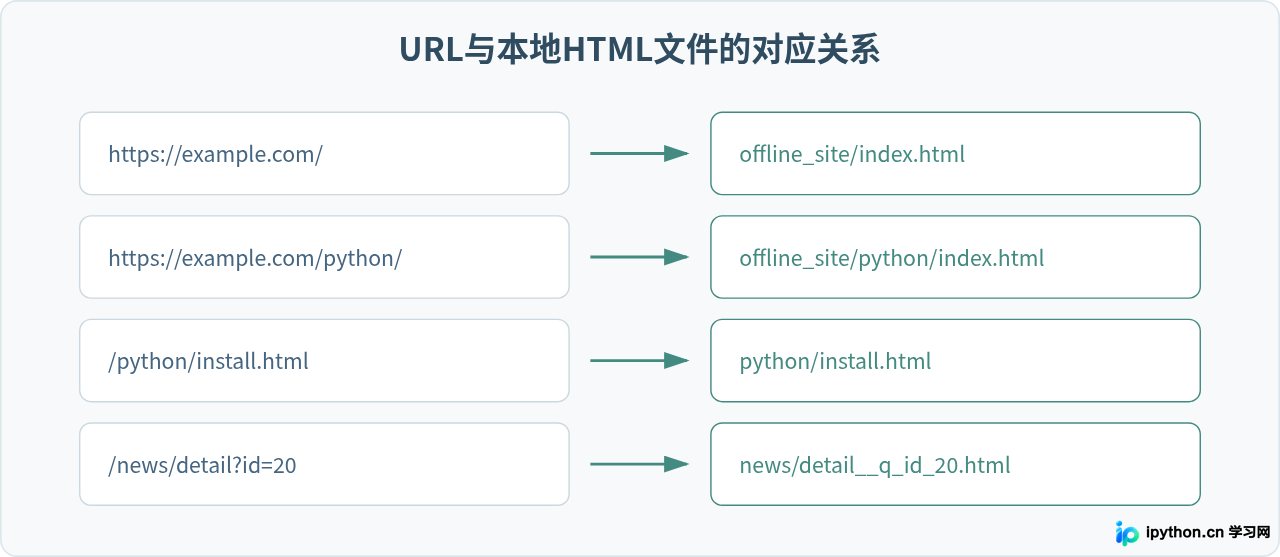
假设原网站存在下面几个地址:
https://example.com/
https://example.com/python/
https://example.com/python/install.html
https://example.com/news/detail?id=20
可以将它们转换成本地结构:
offline_site/
├── index.html
├── python/
│   ├── index.html
│   └── install.html
├── news/
│   └── detail__q_id_20.html
└── assets/
    ├── css/
    ├── js/
    └── images/
这里有两个比较重要的处理规则。
第一,URL路径以/结尾时,保存为对应目录下的index.html。例如:
https://example.com/python/
↓
offline_site/python/index.html
第二,带查询参数的URL要避免文件名冲突。例如:
/news/detail?id=20
/news/detail?id=30它们虽然路径都是/news/detail,但实际上是两个页面。如果全部保存为detail.html,后保存的页面会覆盖前面的页面。因此可以把查询参数编码到文件名中,或者使用哈希值生成唯一文件名。
三、准备Python环境
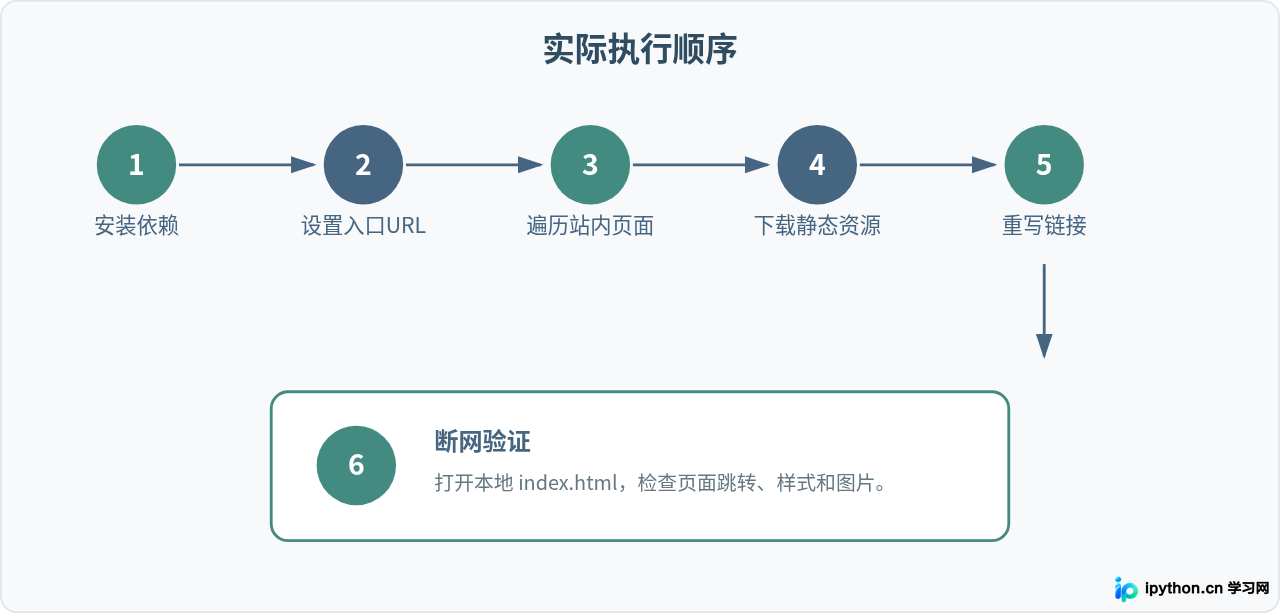
下面的示例使用requests负责下载页面和资源,使用BeautifulSoup解析并修改HTML。
在终端执行:
python -m pip install requests beautifulsoup4创建一个目录,例如:
offline_crawler/
└── crawler.py后面的完整代码保存到crawler.py中运行。
四、完整实现:遍历站内网页并保存成本地HTML
下面给出一个可以直接修改使用的基础版本。它完成几件核心工作:
- 从指定入口URL开始抓取页面。
- 只继续遍历同一域名中的HTML页面。
- 把页面映射为本地HTML文件。
- 下载HTML中常见的CSS、JavaScript和图片资源。
- 把
a标签的站内链接改成本地HTML路径。 - 把资源地址改成本地相对路径。
- 使用队列继续抓取发现的其他网页。
from pathlib import Path
from collections import deque
from urllib.parse import urljoin, urlparse, urldefrag, parse_qsl
import hashlib
import mimetypes
import os
import re

import requests
from bs4 import BeautifulSoup


START_URL = "https://example.com/"
OUTPUT_DIR = Path("offline_site")

TIMEOUT = 15

session = requests.Session()
session.headers.update({
    "User-Agent": (
        "Mozilla/5.0 (compatible; OfflineSiteSaver/1.0)"
    )
})

start_parts = urlparse(START_URL)
BASE_HOST = start_parts.netloc.lower()


def clean_filename(value):
    """把不适合作为文件名的字符替换掉。"""
    value = re.sub(r'[\\/:*?"<>|]', "_", value)
    value = value.strip(" ._")
    return value or "index"


def normalize_url(url, base_url):
    """转换成绝对URL,并去掉#fragment。"""
    absolute = urljoin(base_url, url)
    absolute, _fragment = urldefrag(absolute)
    return absolute


def is_same_site(url):
    """只允许继续抓取同一域名。"""
    parts = urlparse(url)
    return parts.scheme in ("http", "https") and parts.netloc.lower() == BASE_HOST


def page_url_to_path(url):
    """
    将网页URL映射成本地HTML路径。
    """
    parts = urlparse(url)
    path = parts.path

    if not path or path == "/":
        local = OUTPUT_DIR / "index.html"

    elif path.endswith("/"):
        local = OUTPUT_DIR / path.lstrip("/") / "index.html"

    else:
        url_path = Path(path.lstrip("/"))

        if url_path.suffix.lower() in (".html", ".htm"):
            local = OUTPUT_DIR / url_path
        else:
            local = OUTPUT_DIR / url_path.parent / (
                clean_filename(url_path.name) + ".html"
            )

    if parts.query:
        query_items = parse_qsl(parts.query, keep_blank_values=True)
        query_text = "_".join(
            clean_filename(f"{key}_{value}")
            for key, value in query_items
        )

        if len(query_text) > 70:
            query_text = hashlib.md5(
                parts.query.encode("utf-8")
            ).hexdigest()[:12]

        local = local.with_name(
            local.stem + "__q_" + query_text + local.suffix
        )

    return local


def resource_url_to_path(url, content_type=""):
    """
    把CSS、JS、图片等资源保存到assets目录。
    """
    parts = urlparse(url)
    path = parts.path
    source_name = Path(path).name

    if source_name:
        filename = clean_filename(source_name)
    else:
        filename = "resource"

    suffix = Path(filename).suffix

    if not suffix and content_type:
        mime = content_type.split(";")[0].strip()
        guessed = mimetypes.guess_extension(mime)
        if guessed:
            filename += guessed

    if parts.query:
        digest = hashlib.md5(
            parts.query.encode("utf-8")
        ).hexdigest()[:10]

        p = Path(filename)

        if p.suffix:
            filename = p.stem + "_" + digest + p.suffix
        else:
            filename += "_" + digest

    path_hash = hashlib.md5(
        parts.path.encode("utf-8")
    ).hexdigest()[:8]

    return OUTPUT_DIR / "assets" / path_hash / filename


def relative_path(from_file, to_file):
    """计算两个本地文件之间的相对地址。"""
    return Path(
        os.path.relpath(to_file, start=from_file.parent)
    ).as_posix()


resource_cache = {}


def download_resource(resource_url, page_file):
    """
    下载静态资源,并返回该资源相对于当前HTML的本地路径。
    """
    if resource_url in resource_cache:
        return relative_path(
            page_file,
            resource_cache[resource_url]
        )

    try:
        response = session.get(
            resource_url,
            timeout=TIMEOUT
        )
        response.raise_for_status()

        content_type = response.headers.get(
            "Content-Type",
            ""
        )

        local_file = resource_url_to_path(
            resource_url,
            content_type
        )

        local_file.parent.mkdir(
            parents=True,
            exist_ok=True
        )

        local_file.write_bytes(response.content)

        resource_cache[resource_url] = local_file

        return relative_path(page_file, local_file)

    except requests.RequestException as exc:
        print(
            "[资源下载失败]",
            resource_url,
            exc
        )
        return None


def rewrite_resources(soup, page_url, page_file):
    """
    下载并改写HTML里的常见静态资源。
    """

    resource_rules = [
        ("img", "src"),
        ("script", "src"),
        ("link", "href"),
        ("source", "src"),
        ("video", "poster")
    ]

    for tag_name, attr_name in resource_rules:

        for tag in soup.find_all(tag_name):

            raw = tag.get(attr_name)

            if not raw:
                continue

            if raw.startswith((
                "data:",
                "javascript:",
                "mailto:",
                "tel:"
            )):
                continue

            resource_url = normalize_url(
                raw,
                page_url
            )

            local_path = download_resource(
                resource_url,
                page_file
            )

            if local_path:
                tag[attr_name] = local_path


def rewrite_links(soup, page_url, page_file, queue, visited):
    """
    找出站内页面链接,并改成本地HTML地址。
    """
    for tag in soup.find_all("a", href=True):

        raw = tag.get("href")

        if not raw:
            continue

        if raw.startswith((
            "#",
            "javascript:",
            "mailto:",
            "tel:"
        )):
            continue

        target_url = normalize_url(
            raw,
            page_url
        )

        if not is_same_site(target_url):
            continue

        target_file = page_url_to_path(
            target_url
        )

        tag["href"] = relative_path(
            page_file,
            target_file
        )

        if (
            target_url not in visited
            and target_url not in queue
        ):
            queue.append(target_url)


def save_page(url, queue, visited):

    print("[抓取页面]", url)

    try:
        response = session.get(
            url,
            timeout=TIMEOUT
        )
        response.raise_for_status()

    except requests.RequestException as exc:
        print("[页面失败]", url, exc)
        return

    content_type = response.headers.get(
        "Content-Type",
        ""
    ).lower()

    if "text/html" not in content_type:
        print("[跳过非HTML]", url)
        return

    response.encoding = (
        response.apparent_encoding
        or response.encoding
        or "utf-8"
    )

    page_file = page_url_to_path(url)

    soup = BeautifulSoup(
        response.text,
        "html.parser"
    )

    rewrite_links(
        soup,
        url,
        page_file,
        queue,
        visited
    )

    rewrite_resources(
        soup,
        url,
        page_file
    )

    page_file.parent.mkdir(
        parents=True,
        exist_ok=True
    )

    page_file.write_text(
        str(soup),
        encoding="utf-8"
    )

    print("[已保存]", page_file)


def main():

    OUTPUT_DIR.mkdir(
        parents=True,
        exist_ok=True
    )

    queue = deque([START_URL])
    visited = set()

    while queue:

        url = queue.popleft()

        if url in visited:
            continue

        visited.add(url)

        save_page(
            url,
            queue,
            visited
        )

    print()
    print("抓取完成")
    print("页面数量:", len(visited))
    print("保存目录:", OUTPUT_DIR.resolve())


if __name__ == "__main__":
    main()
五、修改入口地址并开始抓取
真正使用时,最主要的是把代码顶部的:
START_URL = "https://example.com/"修改为目标网站入口,例如:
START_URL = "https://www.example.com/"然后在crawler.py所在目录执行:
python crawler.py运行过程中会看到类似下面的输出。
示例输出:
[抓取页面] https://www.example.com/
[已保存] offline_site/index.html

[抓取页面] https://www.example.com/python/
[已保存] offline_site/python/index.html

[抓取页面] https://www.example.com/python/install.html
[已保存] offline_site/python/install.html

抓取完成
页面数量: 3
保存目录: /your/path/offline_site
实际页面数量和文件路径取决于目标网站,这里只是说明程序运行时应该看到什么。
六、代码中的几个关键部分需要理解
1. 使用队列不断发现新的网页
程序不是提前知道网站有多少页面,而是从首页开始,把页面中发现的站内链接不断加入队列:
queue = deque([START_URL])
visited = set()每处理一个页面,就从它的<a href="...">标签中寻找新的URL。
visited则负责记录已经访问过的页面,避免首页链接栏目、栏目又链接首页时出现无限循环。
2. 只遍历同一网站
页面中经常会出现外部链接,例如友情链接、广告、GitHub或者其他网站。如果不限制域名,爬虫可能沿着链接不断进入其他网站。
代码通过:
parts.netloc.lower() == BASE_HOST确保只有与入口URL域名相同的地址才作为网页继续抓取。
外部链接本身没有必要删除,它可以保留原来的在线地址,只是不进入本地网页抓取队列。
3. 把网页链接改成本地相对路径
假设当前保存的文件是:
offline_site/python/index.html它原来链接:
https://example.com/python/install.html保存完成后,应当改成类似:
install.html如果当前页面和目标页面不在同一目录,也可能变成:
../news/index.html使用相对路径比写死本地绝对路径更合适。这样即使把整个offline_site目录复制到另一台电脑,内部链接仍然能够使用。
七、图片、CSS和JavaScript为什么也要下载
一个网页的HTML往往只负责页面结构。例如下面的代码:
<link rel="stylesheet" href="/css/main.css">
<script src="/js/app.js"></script>
<img src="/images/logo.png" alt="Logo">
如果只是保存HTML,这些资源地址仍然指向服务器。
离线保存后,应当改成类似:
<link rel="stylesheet" href="../assets/a1234567/main.css">
<script src="../assets/b7654321/app.js"></script>
<img src="../assets/c3456789/logo.png" alt="Logo">
浏览器就会直接从本地磁盘读取资源。
url(...) 再引用背景图片、字体等文件。如果目标是高度完整的网站镜像,还需要继续解析CSS中的URL并下载这些二级资源。
八、CSS里面的背景图和字体如何继续处理
例如CSS中可能存在:
.header {
    background-image: url("../images/header.jpg");
}

@font-face {
    font-family: "SiteFont";
    src: url("../fonts/site.woff2");
}即使已经把main.css下载到本地,如果没有同步下载header.jpg和site.woff2,断网后仍然会缺失资源。
因此,更完整的实现通常要在下载CSS后执行第二次解析:
- 判断响应类型是不是
text/css。 - 搜索CSS中的
url(...)。 - 使用CSS文件原始URL作为基准计算绝对地址。
- 继续下载图片、字体等资源。
- 把CSS中的原地址修改成本地相对路径。
这一步是否需要实现,取决于你对“离线完整度”的要求。只保存文章文字和主要图片时可以简化;如果希望页面布局与在线版本尽量一致,就应该继续处理CSS资源。
九、srcset和懒加载图片也可能需要单独处理
现在很多网页不会简单使用:
<img src="/images/a.jpg">还可能出现:
<img
    src="/images/a-small.jpg"
    srcset="/images/a-small.jpg 480w,
            /images/a-large.jpg 1200w"
>
或者:
<img data-src="/images/article.jpg">前面的基础代码只处理常见src属性,所以如果目标网站大量使用响应式图片或自定义懒加载属性,还要根据目标HTML结构增加规则。
例如可以加入:
resource_rules = [
    ("img", "src"),
    ("img", "data-src"),
    ("script", "src"),
    ("link", "href"),
    ("source", "src")
]但srcset不能简单作为一个URL下载,因为一个属性中可能同时包含多个候选地址,需要拆开处理。
十、怎样判断是否真的已经可以离线浏览
不要只看到本地生成了大量HTML文件就认为任务完成。最直接的验证办法是断开网络后重新打开入口文件。
例如:
offline_site/index.html然后依次检查:
- 首页能否正常显示。
- CSS样式是否存在。
- 图片是否可以显示。
- 点击栏目链接是否进入本地HTML。
- 点击文章链接是否进入本地HTML。
- 上一页、下一页等分页是否仍然有效。
- 浏览器开发者工具中是否仍然出现大量访问原域名的网络请求。
如果断网后文字正常但样式丢失,通常是CSS没有保存完整;如果图片大量消失,需要检查src、srcset或懒加载属性;如果点击链接访问原网站,则说明对应的HTML链接没有完成重写。
十一、为什么有些网站直接双击HTML仍然不能正常运行
浏览器直接打开文件时,地址是类似这样的:
file:///Users/name/offline_site/index.html大多数普通静态HTML可以这样浏览,但某些网页中的JavaScript会使用fetch、模块脚本或者Ajax请求。这些功能在file://环境下可能受到浏览器安全策略限制。
遇到这种情况,可以在offline_site目录启动一个本地HTTP服务器:
cd offline_site
python -m http.server 8000
然后在浏览器访问:
http://127.0.0.1:8000/这样浏览方式仍然完全使用本地文件,但网页运行环境变成正常的HTTP地址,兼容性通常比直接打开file://文件更好。
十二、动态网站不能只靠保存HTML解决
如果页面主要依赖接口动态加载,例如HTML中只有:
<div id="app"></div>
<script src="/app.js"></script>
实际文章内容由JavaScript请求API后再插入页面,那么requests保存的原始HTML中可能根本不存在正文。
这种网站需要区分两种目标。
| 目标 | 处理方式 |
|---|---|
| 只希望保存最终看到的文章内容 | 使用能够执行JavaScript的浏览器加载页面,取得渲染后的DOM,再保存为HTML。 |
| 希望原网站的动态功能也能完全离线运行 | 除HTML外,还可能需要保存API数据,并修改JavaScript的数据请求逻辑,复杂度明显更高。 |
例如搜索、登录、评论提交、支付、后台查询等依赖服务器的功能,并不会因为保存了HTML就自动变成离线功能。
十三、不要把所有URL都当作普通网页抓取
实际网站经常存在一些不应该无限遍历的地址,例如:
/login
/logout
/cart
/search?q=python
/search?q=java
/calendar?date=2026-01
/calendar?date=2026-02
搜索结果、筛选条件和日历页面可能组合出大量不同URL。如果不限制,抓取数量可能迅速增加。
实际项目中最好增加URL过滤规则,例如:
SKIP_PATHS = (
    "/login",
    "/logout",
    "/register",
    "/cart"
)

def should_skip(url):
    path = urlparse(url).path

    return any(
        path.startswith(item)
        for item in SKIP_PATHS
    )
在加入队列之前判断:
if not should_skip(target_url):
    queue.append(target_url)
对于大型网站,还可以设置最大页面数量和最大抓取深度,防止因为URL规则异常而无限运行。
十四、如果只需要文章正文,可以把方案简化很多
有时所谓“离线浏览”只是希望长期保存文章,而不是完整复制整个网站界面。这种情况下没有必要下载所有JavaScript。
可以只保存:
- 文章HTML。
- 文章中的图片。
- 必要的CSS。
- 文章之间的本地链接。
甚至可以自行生成统一的本地HTML模板,把抓取到的标题、正文、发布时间等内容填入模板。这样生成的离线网站结构更简单,也不会受到原网站复杂前端代码的影响。
如果目的只是资料归档,这种方式通常比完整镜像原网站更加容易维护。
十五、抓取时还要注意请求频率和网站权限
批量保存整个网站会产生连续请求。程序能够访问某个URL,并不等于适合无限制、高频率抓取。
实际运行时应根据目标网站情况增加请求间隔,例如:
import time

time.sleep(0.5)
可以把它放在页面请求之间,减少连续请求速度。
同时应确认你有权保存相应内容,并遵守目标网站公开的访问规则、robots设置以及相关使用条款。需要登录或者受权限保护的数据,不应该通过绕过访问控制的方式批量获取。
十六、常见问题
打开本地HTML后还是跳到线上网站
说明部分链接没有被重写。检查HTML中是否还有类似:
href="https://example.com/..."也要注意JavaScript可能通过点击事件自行生成跳转地址,这种链接不是简单修改href就能解决。
本地HTML有文字,但没有样式
检查页面中的<link rel="stylesheet">地址。如果CSS已经下载,还要确认本地相对路径是否正确。
若CSS本身正常但背景图或者字体缺失,则需要继续处理CSS内部的url(...)。
有些图片仍然无法显示
除了普通src,还要检查:
srcset
data-src
data-original
picture / source
具体属性取决于目标网站的HTML写法。
程序不断产生大量HTML文件
通常是URL参数过多。例如:
?page=1
?page=2
?sort=new
?sort=hot
?keyword=python
需要明确哪些参数代表真正不同的内容,哪些参数可以忽略,然后在URL规范化阶段过滤。
网页已经保存,但搜索功能不能使用
如果原搜索功能需要向服务器发送请求,本地HTML无法自动复制这个后端功能。离线搜索需要重新实现,例如提前建立本地文章索引,再用JavaScript进行客户端检索。
十七、整个方案应该如何理解
把Python爬取的网页保存为本地可离线浏览的网站,本质上不是简单执行一次open().write(),而是在本地重新建立一个由HTML文件和静态资源组成的网站。
核心关系可以归纳为:
在线URL
    ↓
抓取HTML
    ↓
发现内部链接
    ↓
URL映射成本地文件
    ↓
下载CSS / JS / 图片
    ↓
修改HTML中的链接
    ↓
保存本地目录
    ↓
继续遍历其他网页
    ↓
断网验证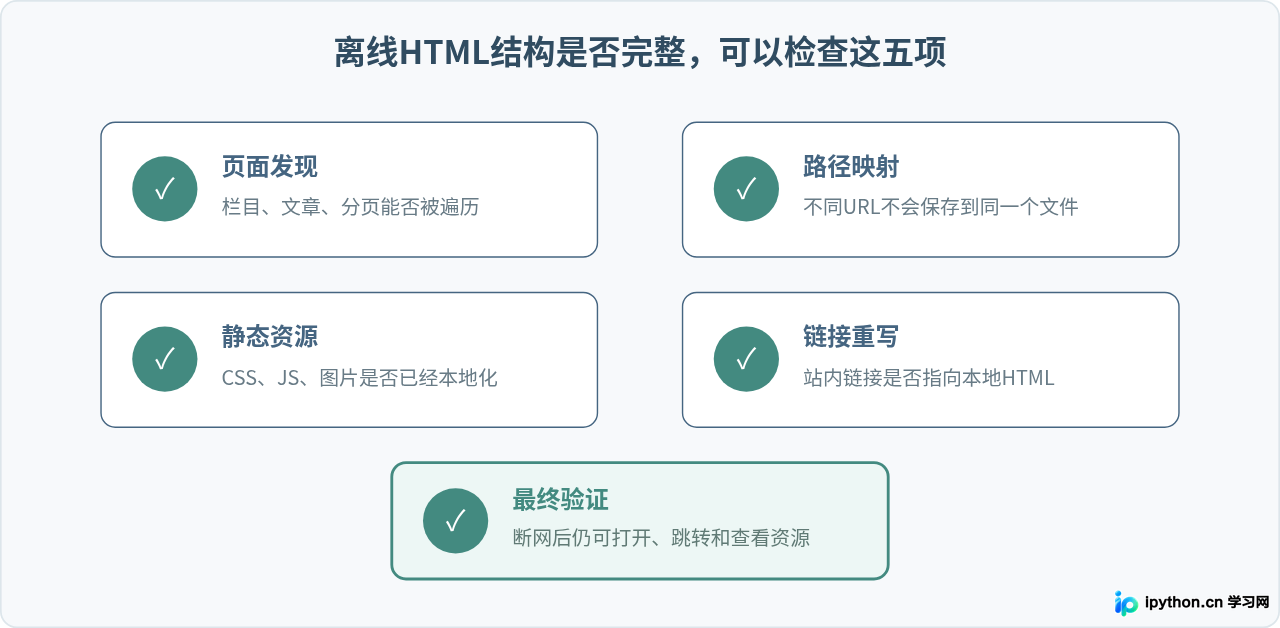
对于普通的服务端渲染网站,本文的requests加BeautifulSoup方案已经能够完成基础的站点离线保存。如果目标站点大量使用JavaScript渲染、接口请求、懒加载或者复杂前端路由,则应该在这个结构上继续增加浏览器渲染、CSS资源解析、srcset处理以及URL过滤规则,而不是单纯增加抓取页面数量。
实际开发时最值得先保证的是两点:一是每个在线URL都能稳定映射到唯一的本地HTML文件;二是保存后的页面只通过相对路径引用本地页面和本地资源。把这两个基础处理正确,再逐步补充图片、字体、CSS二级资源和动态页面,最终就能形成一套可以迁移、备份和离线浏览的HTML目录。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















