


Python时间序列分析与预测:从分解到移动平均实战

本文深入解析Python中的时间序列预测技术。从基础概念入手,详解如何可视化AirPassengers数据,识别趋势、季节性与周期性要素。重点对比经典分解、X11与STL分解算法,并演示简单移动平均(SMA)、加权移动平均(WMA)及指数平滑(EMA/Holt)等预测模型的Python实现与代码应用。
预测是一项极具挑战性的任务,在此领域表现卓越的企业往往能在同行业中脱颖而出。时间序列预测的应用场景广泛,既涵盖长期的年度规划,也涉及短期的分钟级业务监控。若你正准备开展时间序列预测工作,本文将引导你快速掌握其中不可或缺的核心概念与技能。
什么是时间序列?
顾名思义,时间序列是指按固定时间间隔记录的数据集合。换言之,以时间为索引的一组数据即构成时间序列。这里的关键在于“固定时间间隔”,如每小时、每天、每周、每月或每季度,时间单位必须保持一致且不可随意更改。请注意,这不同于序列中可能存在的缺失值,后者有专门的填充方法处理。
在利用时间序列数据预测未来值之前,明确预测的“界限”至关重要,即你需要提前多久进行预测(例如一天、一周、六个月甚至十年)。同时,还需确定预测的频率。在深入执行预测工作前,与最终使用预测结果的相关人员进行沟通,有助于确保预测目标与实际需求相符。
如何在Python中绘制时间序列数据?
可视化时间序列是数据科学家理解数据模式、时变性、异常值及离群值,并观察变量间关系的首要步骤。通过绘图获得的分析与见解,不仅有助于构建更精准的预测模型,还能指引我们选择最合适的建模方法。本文将首先介绍使用折线图进行可视化,这是时间序列数据展示中最通用的工具。
本文示例使用的是AirPassengers数据集,该数据集记录了1949年至1960年间每月的航空旅客数量。以下展示部分示例数据,帮助你建立对数据结构的直观认识。
#Reading Time Series Data
Airpassenger = pd.read_csv("AirPassengers.csv")
Airpassenger.head(3)
接下来,我们使用折线图绘制这些数据。在示例代码中,首先通过set_index()将date列转换为索引,从而自动在x轴上显示时间维度。随后,利用rcParams设置图形大小,最后调用plot()函数完成图表绘制。
Airpassenger = Airpassenger.set_index('date')
pyplot.rcParams["figure.figsize"] = (12,6)
Airpassenger.plot()
pyplot.show()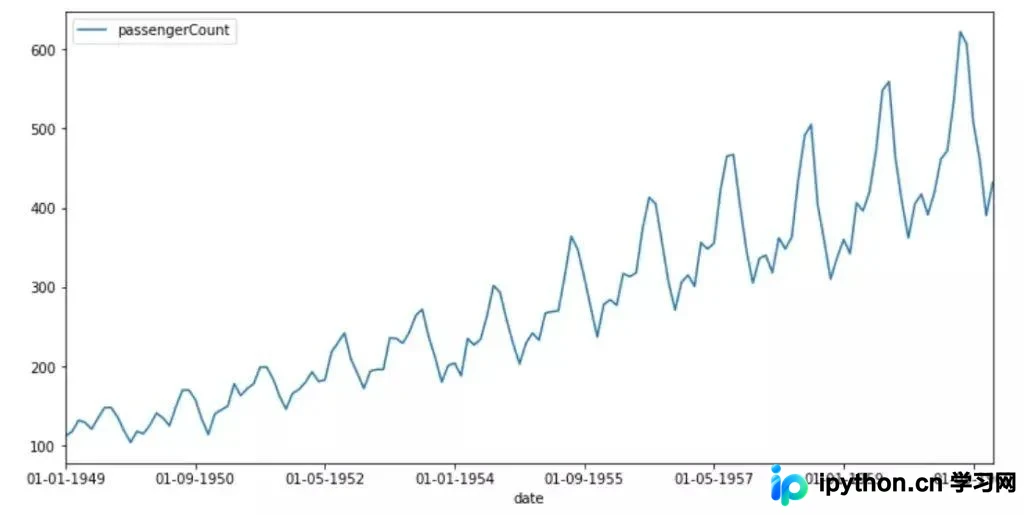
从1949年至1960年的数据可以看出,航空旅客数量呈现稳定的增长趋势。规律性间隔出现的峰值表明,这种增长似乎以固定的时间周期重复出现。
为了更深入地理解数据,我们进一步分析每个季度的趋势。从不同维度观察信息有助于全面把握数据特征。为此,我们需要利用Python中的datetime包,从date变量中提取季度和年份信息。在绘图前,我们将年份与季度信息拼接,以观察旅客数量在季节维度上的变化规律。
from datetime import datetime
# Airpassenger["date"] = Airpassenger["date"].apply(lambda x: datetime.strptime(x, "%d-%m-%Y"))
Airpassenger["year"] = Airpassenger["date"].apply(lambda x: x.year)
Airpassenger["qtr"] = Airpassenger["date"].apply(lambda x: x.quarter)
Airpassenger["yearQtr"]=Airpassenger['year'].astype(str)+'_'+Airpassenger['qtr'].astype(str)
airPassengerByQtr=Airpassenger[["passengerCount", "yearQtr"]].groupby(["yearQtr"]).sum()
数据准备就绪后,我们绘制折线图,并确保所有时间标签均显示在x轴上。由于x轴标签数量众多,我们将标签设置为垂直旋转显示,以提高可读性。
pyplot.rcParams["figure.figsize"] = (14,6)
pyplot.plot(airPassengerByQtr)
pyplot.xticks(airPassengerByQtr.index, rotation='vertical')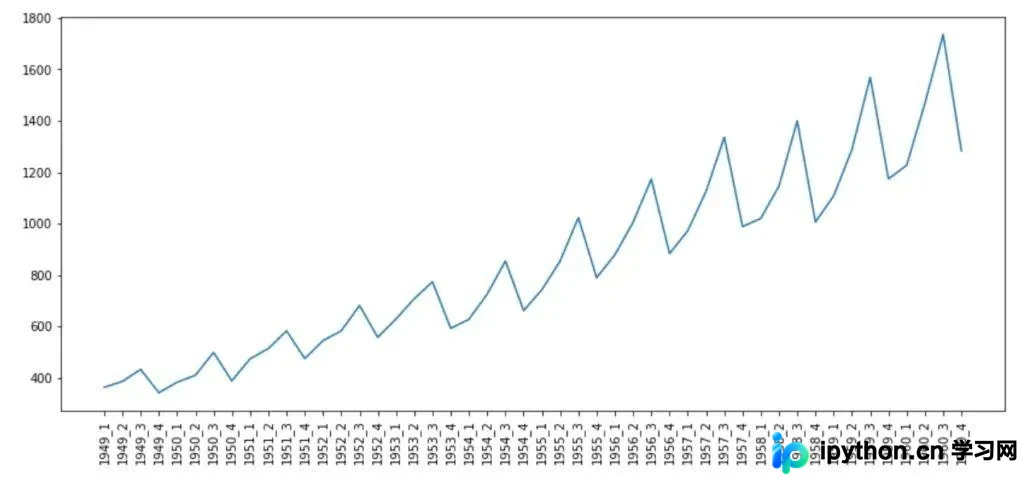
该图表揭示了重要信息:在1949年至1960年的所有年份中,航空旅客数量在每个季度均呈现显著增长。
时间序列的要素是什么?
时间序列数据主要包含四个核心要素: 1.趋势性:指数据随时间推移呈现的总体上升或下降趋势。例如,1949年至1960年间航空旅客数量整体呈上升趋势。 2.季节性:类似于四季更替,数据在固定间隔后重复出现的模式称为季节性。这些模式可能在日、周、月或年等特定时间间隔后重复。有时季节性直观可见,有时则需借助统计方法检验。 3.周期性:与季节性类似,但周期性不遵循固定周期,因此较难识别。例如,地震发生时间不可预测,即属于此类。 4.随机噪声:指不属于上述三类的突然变化,难以解释,表现为随机波动。
如何分解时间序列?
获取时间序列要素主要有两种技术。在深入研究Python相关函数之前,需明确以下两点前提:
- 时间序列不一定包含所有要素。
- 需判断该时间序列属于可加模型还是可乘模型。
什么是可加和可乘时间序列模型?
可加性模型:在此类模型中,各要素之间为累加关系。公式为:y(t) = 季节 + 趋势 + 周期 + 噪音。
可乘性模型:在此类模型中,各要素之间为相乘关系。公式为:y(t) = 季节 * 趋势 * 周期 * 噪音。
为何要分解时间序列?主要目的之一是估计季节性影响并提供经过季节性调整的值。去除季节性后,趋势便清晰可见。例如,美国夏季因农业需求增加,失业率通常下降。从经济学角度看,6月失业率低于5月并非完全反映真实经济状况,而是受季节性因素影响。因此,必须对这一事实进行调整,以获取更准确的分析结果。
现实世界中的挑战在于,时间序列往往是可加性和可乘性的混合体。这意味着我们可能无法将时间序列完全分解为纯粹的可加或可乘形式。
了解了不同模型后,接下来我们将研究Python中提取时间序列要素的常用方法。
经典分解法
该方法起源于1920年,是众多分解方法的鼻祖。经典分解法分为加法和乘法两种形式。Python的statsmodels库提供了season_decompose()函数来实现经典分解。使用时,需指定时间序列是可加还是可乘。更多细节可参考官方文档关于加法和乘法分解的说明。
在下方代码中,只需设置model='additive'即可获得时间序列的分解结果。
import numpy as np
from pandas import read_csv
import matplotlib.pyplot as plt
from statsmodels.tsa.seasonal import seasonal_decompose
from pylab import rcParams

elecequip = read_csv(r"C:/Users/datas/python/data/elecequip.csv")
result = seasonal_decompose(np.array(elecequip), model='multiplicative', freq=4)

rcParams['figure.figsize'] = 10, 5
result.plot()
pyplot.figure(figsize=(40,10))
pyplot.show()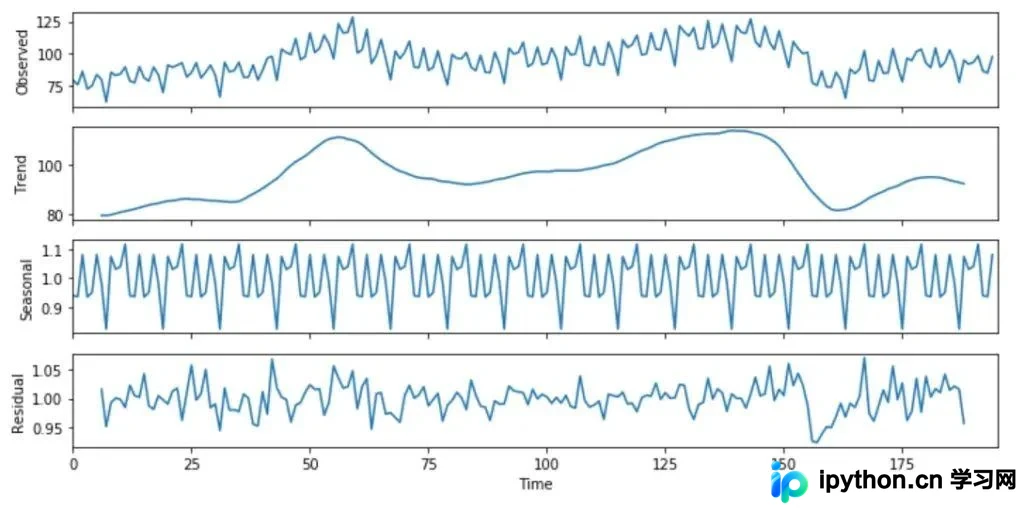
上图第一行展示实际数据,底部三行分别显示分解后的三个要素。将这三个要素累加即可还原原始数据。第二个样本集代表趋势性,第三个样本集代表季节性。观察完整时间范围可见,趋势存在波动变化;而季节性则在固定间隔后清晰呈现峰值。
如何获得季节性调整值?
对于可加性模型,可通过y(t) - s(t)计算季节性调整后的值;对于乘法模型,则使用y(t) / s(t)进行调整。
若你疑惑为何需要季节性调整数据,可回顾前文美国失业率的例子。如果季节性本身不是主要关注点,季节性调整后的数据将更具参考价值。尽管经典方法应用广泛,但因其存在以下局限性,通常不建议直接使用:
- 该方法对异常值敏感,可靠性较低。
- 它倾向于过度平滑时间序列中的突然上升或下降。
- 假设季节性因素每年仅重复一次,缺乏灵活性。
- 对于序列的前几次和最后几次观察,该方法无法生成有效的趋势周期估计。
相比之下,X11分解、SEAT分解或STL分解是更优的选择。下文将展示如何在Python中实现这些方法。
与经典法、X11和SEAT分解相比,STL分解具有诸多优势。接下来,我们将深入探讨STL分解法。
STL分解法
STL代表使用局部加权回归(Loess)进行季节性和趋势性分解。该方法对异常值具有鲁棒性,并能处理任意类型的季节性,因此成为一种通用的分解方法。使用STL时,你可以控制以下参数:
- 趋势周期的平滑度。
- 季节性变化的速率。
- 对异常值的鲁棒性控制。通过调整该参数,可以限制离群值对季节性和趋势性的影响。
如同其他方法,STL也有局限性。例如,它不能自动处理日历变动,且仅提供对可加性模型的分解。若需处理乘法分解,可先对数据取对数,再通过反向传播要素获取结果,但这超出了本文讨论范围。
Import pandas as pd
Import seaborn as sns
Import matplotlib.pyplot as plt
From statsmodels.tsa.seasonal import STL

elecequip =read_csv(r"C:/Users/datas/python/data/elecequip.csv")
stl = STL(elecequip, period=12, robust=True)
res_robust = stl.fit()
fig = res_robust.plot()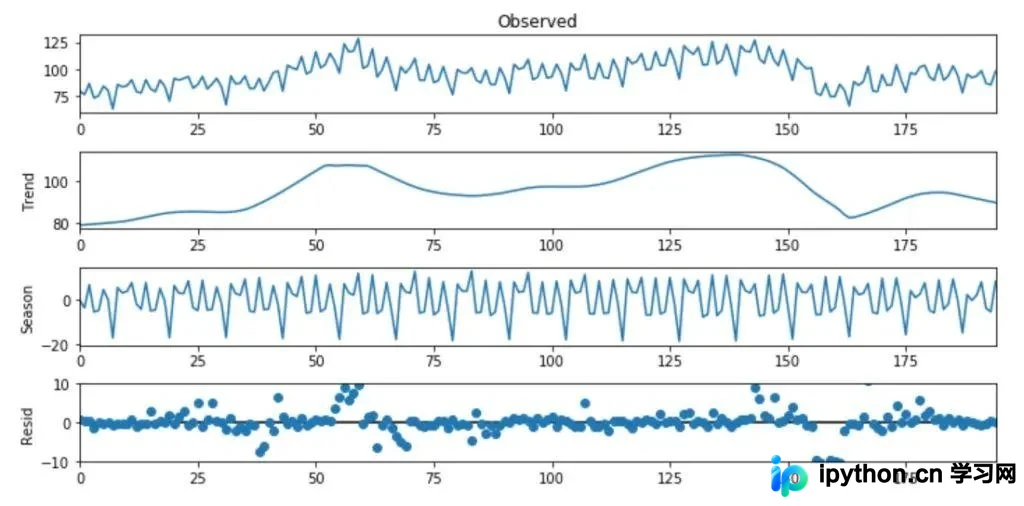
时间序列预测的基本方法
尽管存在多种统计预测技术,本文仅介绍最直接、简单的几种有效预测方法。这些基础方法也将作为其他复杂模型的基础。
PYTHON中的简单移动平均(SMA)
简单移动平均是预测技术中最基础的一种。通过计算最近N个值的平均值来得出移动平均值,并将其作为下一期的预测值。
为什么使用简单移动平均?
移动平均有助于快速识别数据趋势,判断数据是遵循上升还是下降方向。它能有效消除波峰波谷等不规则波动,这种计算方法称为尾随移动平均。在下方示例中,我们使用rolling()函数获取电气设备销售数据的移动平均线。
Import pandas as pd
from matplotlib import pyplot

elecequip = pd.read_csv(r"C:/Users/datas/python/data/elecequip.csv")

# Taking moving average of last 6 obs
rolling = elecequip.rolling(window=6)
rolling_mean = rolling.mean()

# plot the two series
pyplot.plot(elecequip)
pyplot.plot(rolling_mean, color='red')
pyplot.show()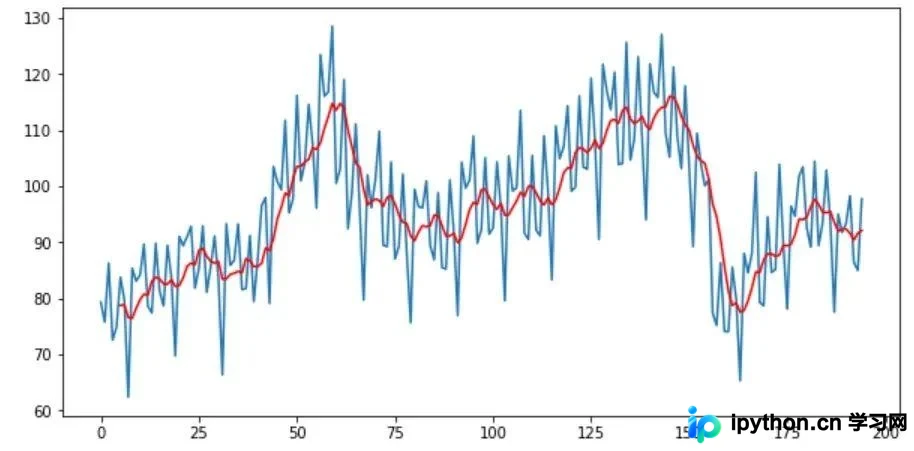
另一种方法是“中心移动平均”。在此方法中,任意给定时间(t)的值被计算为当前、之前和之后时间的平均值。设置center=True即可启用中心移动平均计算。
elecequip["x"].rolling(window=3, center=True).mean()PYTHON中的加权移动平均(WMA)
简单移动平均较为朴素,因为它对过去所有值赋予同等权重。然而,若假设最新数据与实际值关联更紧密,赋予最新值更高权重可能更为合理。
计算WMA的方法是将过去每个观察值乘以特定权重。例如,在6周滚动窗口中,可赋予最近值权重6,最后一个值权重1。
import random
rand = [random.randint(1, i) for i in range(100,110)]
data = {}
data["Sales"] = rand

df = pd.DataFrame(data)
weights = np.array([0.5, 0.25, 0.10])

sum_weights = np.sum(weights)
df['WMA']=(df['Sales']
.rolling(window=3, center=True)
.apply(lambda x: np.sum(weights*x)/sum_weights, raw=False)

)
print(df['WMA'])
PYTHON中的指数移动平均(EMA)
在“指数移动平均”中,随着观察值增加,权重按指数递减。该方法通常是一种优秀的平滑技术,能消除大量噪声,从而获得更精准的预测结果。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.api import ExponentialSmoothing

EMA_fit = ExponentialSmoothing(elecequip, seasonal_periods=12, trend='add', seasonal='add').fit(use_boxcox=True)
fcast3 = EMA_fit.forecast(12)


ax = elecequip.plot(figsize=(10,6), marker='o', color='black', title="Forecasts from Exponential Smoothing" )
ax.set_ylabel("Electrical Equipment")
ax.set_xlabel("Index")

# For plotting fitted values
# EMA_fit.fittedvalues.plot(ax=ax, style='--', color='red')

EMA_fit.forecast(12).rename('EMS Forecast').plot(ax=ax, style='--',
 marker='o', color='blue', legend=True)
该方法包含两种变体: 1.简单指数平滑:适用于具有恒定方差且无季节性的可加性模型,可用于短期预测。 2.Holt指数平滑法:适用于具有趋势(增加或减少)且无季节性的可加性模型,同样用于短期预测。
以下代码展示了如何从Python的statsmodels包导入这两个模型。你可以在练习中运行上述模型进行验证。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.api import SimpleExpSmoothing, Holt
在本长篇教程中,我们讲解了:
- 什么是时间序列数据?
- 如何可视化并更深入地识别数据模式(若存在)?
- 介绍了可加性和可乘性时间序列模型。
- 研究了Python中分解时间序列的不同方法。
最后,我们学习了如何在Python中运行一些基本预测方法,包括移动平均(MA)、加权移动平均(WMA)、指数平滑模型(ESM)及其变体,如SESM和Holt模型。
以上就是如何用Python进行时间序列分解和预测的详细内容,更多关于python 时间序列分解和预测的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















