


Python使用jieba进行中文分词与词频统计及词云生成

发布时间:2026-10-14 |
3人浏览过
本文介绍如何利用Python的jieba库对中文文本进行精确分词,并通过Counter模块统计高频词汇。同时结合matplotlib和wordcloud库,将统计结果可视化生成词云图。文章包含完整的代码示例、运行结果分析及注意事项,适用于需要处理中文文档并提取关键信息的场景。
Python jieba分词与词频统计基础
以下是具体的代码实现过程,请仔细阅读后续内容。
#! python3
# -*- coding: utf-8 -*-
import os, codecs
import jieba
from collections import Counter

def get_words(txt):
 seg_list = jieba.cut(txt)
 c = Counter()
 for x in seg_list:
  if len(x)>1 and x != '\r\n':
   c[x] += 1
 print('常用词频度统计结果')
 for (k,v) in c.most_common(100):
  print('%s%s %s %d' % (' '*(5-len(k)), k, '*'*int(v/3), v))

if __name__ == '__main__':
 with codecs.open('19d.txt', 'r', 'utf8') as f:
  txt = f.read()
 get_words(txt)
测试样本采用十九大报告全文内容。
常用词频度统计结果
  发展 ********************************************************************** 212
  中国 ******************************************************** 168
  人民 **************************************************** 157
  建设 ************************************************* 148
 社会主义 ************************************************ 146
  坚持 ******************************************* 130
  国家 ****************************** 90
  全面 ***************************** 88
  制度 *************************** 83
  实现 *************************** 83
  推进 *************************** 81
  政治 ************************** 80
  社会 ************************** 80
  特色 ************************** 79
  加强 *********************** 71
  体系 ********************** 68
  文化 ********************** 66
  我们 ********************* 64
  时代 ********************* 63
  必须 ******************** 61
  经济 ******************* 59
  伟大 ******************* 58
  完善 ***************** 51
  我国 **************** 50
  推动 *************** 47
 现代化 *************** 47
  安全 *************** 46
  更加 ************** 44
  民主 ************** 44
补充说明:本示例演示如何使用jieba读取TXT文档,执行分词操作,统计词频,并最终输出词云图像。
具体代码实现如下。
中文文本分词与词云生成实现
# 库的引用
import jieba
import matplotlib as mpl
import matplotlib.pyplot as plt
from wordcloud import WordCloud
#定义一个空字符串
final = ""
#文件夹位置
filename = r"D:\python\pra\推荐系统1-500.txt"

#打开文件夹,读取内容,并进行分词
with open(filename,'r',encoding = 'utf-8') as f:
  for line in f.readlines():
    word = jieba.cut(line)
    for i in word:
      final = final + i +" "
程序运行后的输出结果展示。
# 图云打印
word_pic = WordCloud(font_path = r'C:\Windows\Fonts\simkai.ttf',width = 2000,height = 1000).generate(final)
plt.imshow(word_pic)
#去掉坐标轴
plt.axis('off')
#保存图片到相应文件夹
plt.savefig(r'D:\python\pra\6.png')
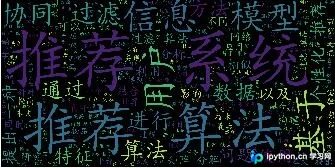
生成的词云图像效果展示。
以上为个人经验分享,旨在提供参考。如有疏漏或错误,欢迎指正。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















