


怎么使用Python进行文本数据分析?分词与词频统计实战

一、为什么中文文本分析必须先过“分词”关?
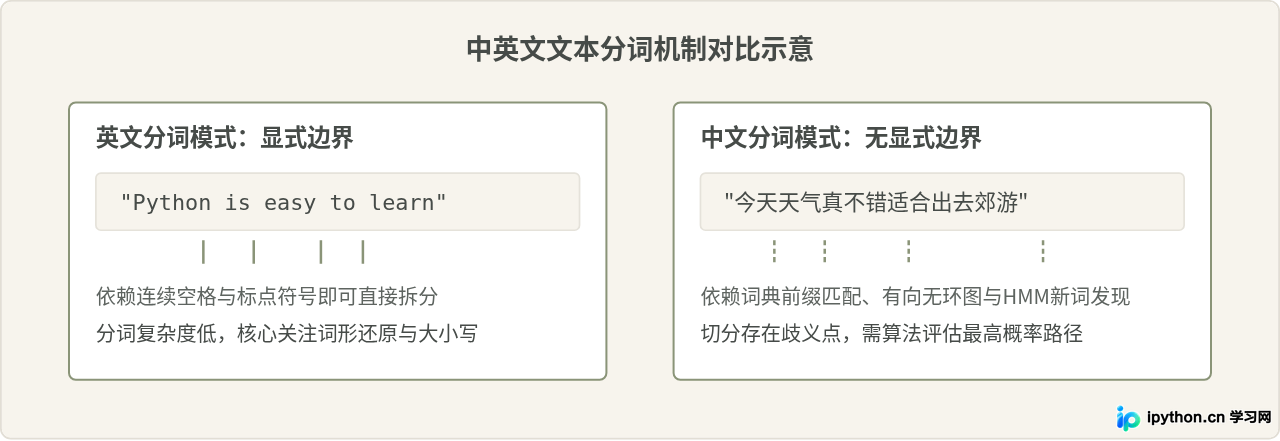
英文文本天然具有词间空格(如 "Natural language processing"),词元切分通常只需依赖空格或标点拆分。但中文书写采用连续汉字排版,词与词之间缺乏自然分隔符。如果直接按字或者简单切分,会完全丢失词汇级的语义信息。
例如句子 "南京市长江大桥",既可以切分为 ["南京市", "长江大桥"],也可以被歧义性地切分成 ["南京", "市长", "江大桥"]。如何结合统计语言模型、词典匹配与有向无环图(DAG),在多种可能切分路径中找出最符合语境的切分,是中文分词工具解决的核心问题。
二、文本分析标准处理全流程
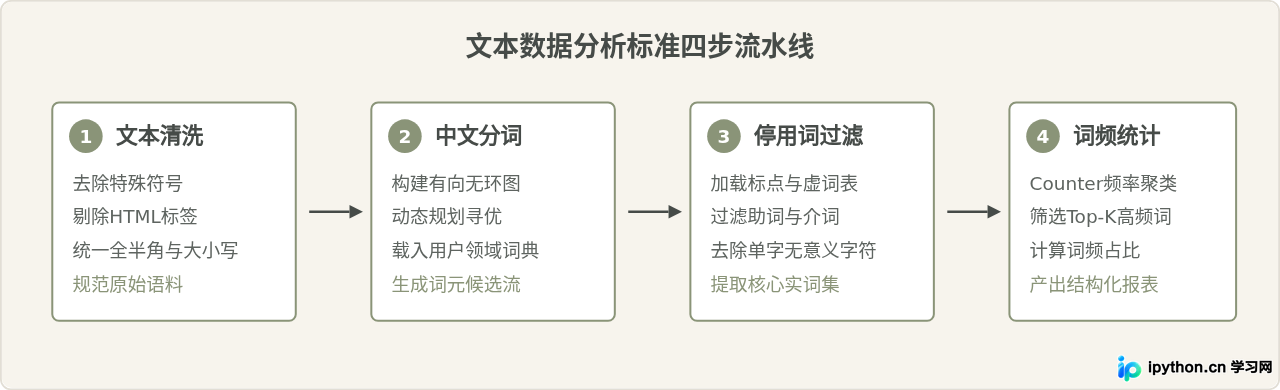
一次规范的文本词频分析并非简单调用切词函数,而是包含四个标准化处理步骤:原始文本预处理、词元切分、噪音与停用词过滤、词频聚合与特征抽取。
三、准备工作与环境依赖
完成本文任务需要 Python 3.8+ 环境。在中文文本处理领域,jieba 是广泛使用且无需复杂二进制依赖的纯 Python 中文分词库。词频聚合则直接利用 Python 内置标准库 collections.Counter,具备极高的统计性能。
# 终端执行安装命令
pip install jiebaimport jieba 并切词时,jieba 会在本地构建基于前缀词典的有向无环图缓存(生成形如 jieba.cache 的文件)。这是正常初始化机制,后续调用将大幅加速。
四、实战演练:从原始文本到分词切分
jieba 提供了三种基本切词模式,分别适用于不同的业务场景:
- 精确模式(默认,
cut_all=False):力求切出最符合语义的单组切分,不产生重复词语,最适合文本分类、情感分析与词频统计。 - 全模式(
cut_all=True):把句子中所有成词的可能都扫描出来,速度快但存在大量重复与歧义,适合建立全文倒排索引。 - 搜索引擎模式(
cut_for_search):在精确模式的基础上,对较长的长词再切分子词,提高搜索引擎召回率。
import jieba

text = "Python数据分析在自然语言处理与人工智能工程中发挥着巨大作用。"

# 1. 精确模式
words_exact = list(jieba.cut(text, cut_all=False))
print("精确模式结果:", words_exact)

# 2. 全模式
words_all = list(jieba.cut(text, cut_all=True))
print("全模式结果:", words_all)

# 3. 搜索引擎模式
words_search = list(jieba.cut_for_search(text))
print("搜索模式结果:", words_search)
控制台示例输出:
精确模式结果: ['Python', '数据分析', '在', '自然语言', '处理', '与', '人工智能', '工程', '中', '发挥', '着', '巨大', '作用', '。']
全模式结果: ['Python', '数据', '数据分析', '分析', '在', '自然', '自然语言', '语言', '处理', '与', '人工', '人工智能', '智能', '工程', '中', '发挥', '着', '巨大', '大作', '作用', '。']
搜索模式结果: ['Python', '数据', '分析', '数据分析', '在', '自然', '语言', '自然语言', '处理', '与', '人工', '智能', '人工智能', '工程', '中', '发挥', '着', '巨大', '作用', '。']
如何解决专业领域专有名词被错切的问题?
在垂直领域(例如医疗、金融或编程开发),通用词典可能把专有名词切散。例如“数据分析师”如果被切分成“数据”、“分析”、“师”,词频统计就会失真。此时可以通过 jieba.add_word("自定义词") 或加载外部自定义词典文件 jieba.load_userdict("dict.txt") 显式指定实体边界。
五、关键清洗环节:停用词(Stopwords)过滤机制
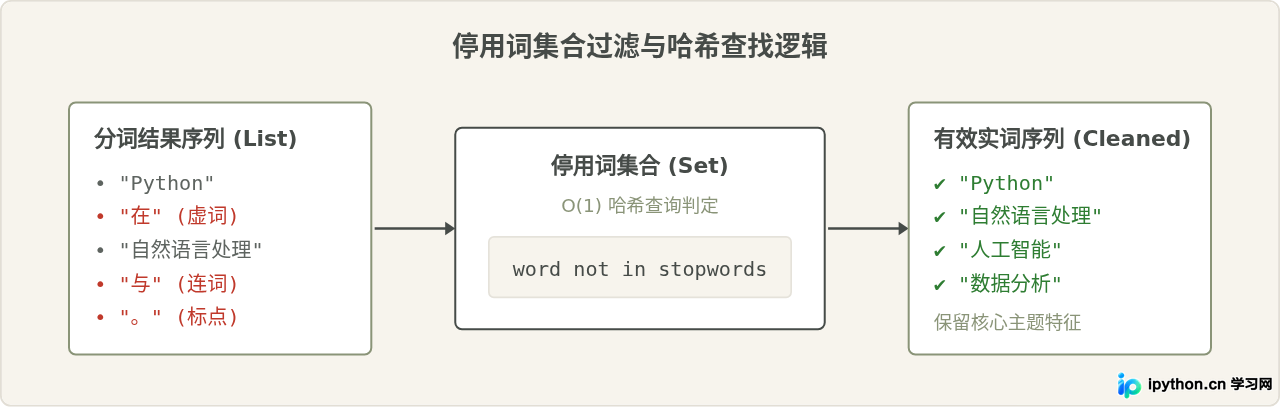
常见认知误区是:“分词完毕后就可以直接拿去算词频了”。如果直接计算,排在最前面的几乎必然是“的”、“了”、“在”、“是”、“以及”等虚词和标点符号。这些词虽然高频,但不具备实际主题特征,必须在统计前剔除。
停用词通常包含三类字符:
- 标点符号与空白字符:如
,。!?、“”\t\n等。 - 语法功能词:如助词(的、地、得)、连词(虽然、但是)、介词(关于、对于)。
- 单字干扰符:在大部分场景下,长度小于等于1的无意义单字也可视具体需求过滤。
六、端到端完整实战:分词与词频统计
以下代码提供完整的实战程序。我们将一段涉及技术与数据分析的多段落长文本作为输入样本,演示从停用词过滤到生成 Top-10 高频词排名的全过程。
import re
from collections import Counter
import jieba

# 1. 待分析的目标语料样例
corpus = """
Python是一种面向对象的解释型计算机程序设计语言。
Python具有丰富和强大的库,常被称为胶水语言,能够把用其他语言制作的各种模块很轻松地联结在一起。
在数据分析与机器学习领域,Python已成为主流工具。利用Python进行数据分析,不仅代码简洁,
而且生态极其繁荣。无论是自然语言处理、文本分析、图像识别还是爬虫抓取,Python都发挥着关键作用。
掌握Python文本分析技术,有助于挖掘海量非结构化文本中的潜在商业价值与核心观点。
"""

# 2. 定义停用词集合(实际开发中可直接读取哈工大或百度停用词表文件)
stopwords = {
    "的", "了", "在", "是", "我", "有", "和", "就", "不", "人", "都", "一",
    "一个", "上", "也", "很", "到", "说", "要", "去", "你", "会", "着", "没有",
    "看", "好", "自己", "这", "与", "中", "把", "用", "能够", "而且", "不仅", "成为"
}

def analyze_text(raw_text, top_k=8):
    # A. 基础正则预处理:去除换行与无效符号
    cleaned_text = re.sub(r"[\s\n\r]+", "", raw_text)

    # B. 精确模式分词
    raw_words = jieba.lcut(cleaned_text)

    # C. 过滤停用词与单字标点
    filtered_words = [
        word for word in raw_words
        if len(word.strip()) > 1 and word not in stopwords
    ]

    # D. 核心统计:利用 Counter 进行频次聚合
    word_counter = Counter(filtered_words)
    top_words = word_counter.most_common(top_k)

    return top_words, len(filtered_words)

# 执行分析
top_results, total_valid_words = analyze_text(corpus, top_k=6)

print(f"清洗后有效词元总数: {total_valid_words}")
print("高频词频次排行:")
for rank, (word, count) in enumerate(top_results, start=1):
    percent = (count / total_valid_words) * 100
    print(f"No.{rank}: 词汇='{word}', 出现频次={count}, 占比={percent:.2f}%")
运行结果示例:
清洗后有效词元总数: 32
高频词频次排行:
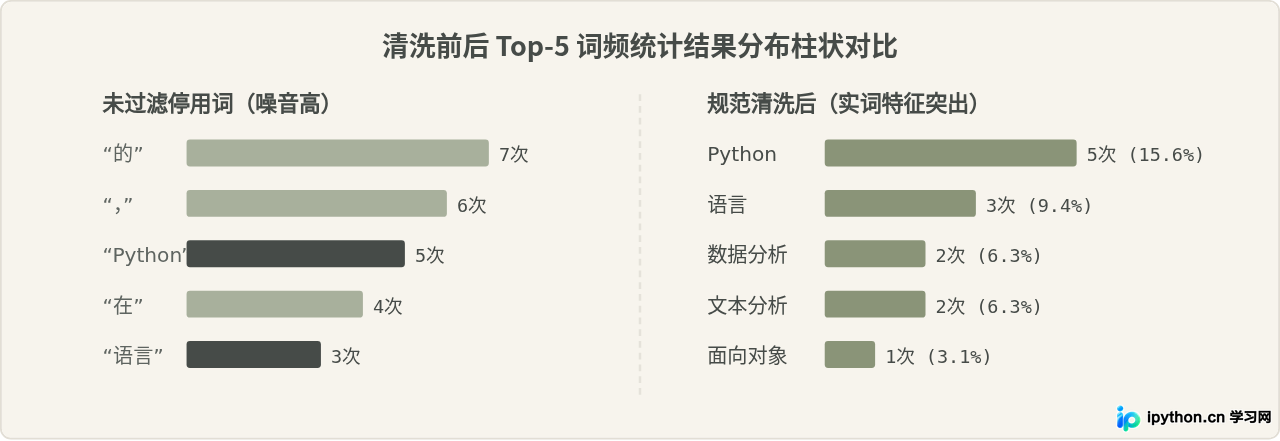
No.1: 词汇='Python', 出现频次=5, 占比=15.62%
No.2: 词汇='语言', 出现频次=3, 占比=9.38%
No.3: 词汇='数据分析', 出现频次=2, 占比=6.25%
No.4: 词汇='文本分析', 出现频次=2, 占比=6.25%
No.5: 词汇='面向对象', 出现频次=1, 占比=3.12%
No.6: 词汇='程序设计', 出现频次=1, 占比=3.12%
七、词频分析结果对比与结构总结
为了让读者直观理解“未做停用词清洗”与“完成停用词清洗”的结果差异,下表列出了常见处理失误带来的统计对比:
| 统计维度 | 未清洗(直接分词计数) | 规范清洗(剔除虚词与符号) | 对数据分析的影响 |
|---|---|---|---|
| Top-1 高频词 | “的”(出现7次以上) | “Python”(核心实体) | 未清洗会导致无意义语法词淹没业务主题 |
| Top-2 高频词 | “,”(标点符号) | “语言” | 标点占满前几位,严重扭曲向量空间分布 |
| 词汇长度分布 | 大量长度为1的杂音汉字 | 多为长度大于等于2的复合概念实词 | 规范清洗后更适合词云绘制或TF-IDF特征提取 |
八、常见陷阱与优化建议
- 陷阱一:停用词表使用
list而非set
如果停用词表包含上千个词,使用列表检索word in stopwords_list的单次时间复杂度为 \(O(n)\),遍历整个语料库会导致耗时剧烈增加;转换为set(stopwords)则享受 \(O(1)\) 的哈希检索性能。 - 陷阱二:词频高并不等同于信息权重高
纯词频(Term Frequency)仅反映出现绝对次数。如果要在更大规模的多篇语料库中提取主题关键词,推荐后续引入 TF-IDF(词频-逆文档频率) 算法,降低在所有文章中普遍出现的高频词权重。 - 陷阱三:英文字母大小写未统一
原始文本中的"python"与"Python"会被计数器当成两个完全独立的键分别统计。分词前应统一执行text.lower()归一化。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















