


Python 实现链式调用的核心原理与惰性查询模拟

本文解析 Python 中链式调用的实现机制,指出关键在于方法返回实例自身(self)。通过修改 filter 方法返回 self,可消除 None 报错。进一步结合 **kwargs 缓存查询条件,模拟 Django 的惰性查询模式,仅在最终获取结果时执行数据库操作,提升效率。
Python 链式调用基础与错误分析
在使用 Django 的 models 查询数据库时,常观察到如下代码风格:
form app.models import XXX
query = XXX.objects.all()
query = query.filter(name=123, age=456).filter(salary=999)
在此写法中,query 对象具备 filter 方法,其返回的数据可继续调用 filter 方法,从而支持无限制的链式调用。
这种链式调用的实现原理是什么?
若直接定义一个类的方法,尝试进行类似调用:
class Query:
    def filter(self):
        pass

query = Query()
query.filter().filter()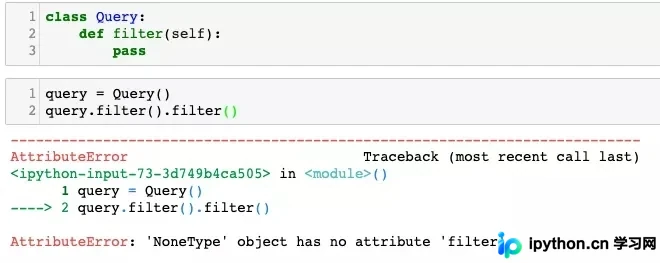
直接对 query.filter() 返回的结果再次调用 filter,将引发错误。原因在于未显式编写 return 语句时,方法默认返回 None,而 None 对象并不具备 filter 方法。
那么,何种对象拥有 filter 方法?显然 query 对象具备该方法。如何让该方法返回其自身对象?
此时需回顾定义类方法时常见的第一个参数 self。几乎每个类方法都包含它。通常知晓在类内调用类方法可用 self.xxx(),调用类属性可用 self.yy,但是否思考过该参数单独使用时的行为?
通过返回 self 实现链式调用
实际上,self 指代类实例化为对象后的该对象自身。既然该对象拥有 filter 方法,只需修改 filter 方法,使其返回 self:
class Query:
    def filter(self):
        return self

query = Query()
query.filter().filter()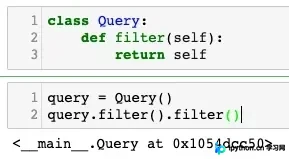
从运行结果可见,错误已消除。回到初始问题,Django 内部链式调用传入查询参数的实现机制为何?
模拟 Django 惰性查询与参数缓存
这涉及一个 惰性查询 的概念。
当持续调用 .filter() 方法时,Django 会将所有查询条件暂存,仅在获取结果或统计满足条件的数据条数时,才真正连接数据库执行查询。
因此,我们需要模拟此环境,将查询条件进行缓存。
为获取调用方法时传入的参数名,需使用 **kwargs 参数。该参数可接收所有 key=value 形式的参数:
class Query():
    def __init__(self):
        self.query_condition = {}

    def filter(self, **kwargs):
        self.query_condition.update(kwargs)
        return self

query = Query()
a = query.filter(name='kingname').filter(age__gt=15, address='yyyyyy').filter(salary=99999)
print(query.query_condition)
运行效果如下图所示:
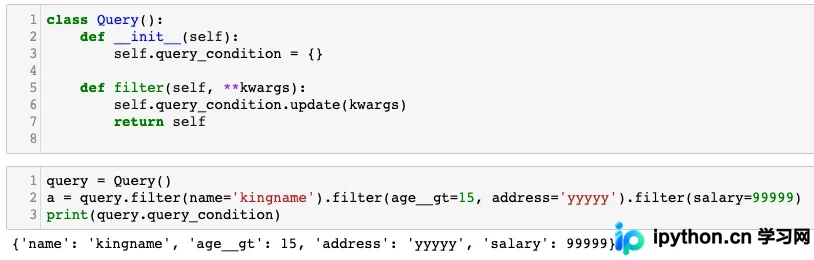
在真正需要输出结果时,利用缓存的条件查询数据库即可。
以上为 Python 实现链式调用的详细解析,更多相关技术内容请关注本站其他文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















