


Python学习路线规划:从基础语法到Web与数据方向选择
针对零基础与进阶开发者的系统化Python学习路线规划,涵盖基础语法、面向对象、工程规范以及Web开发与数据分析双方向的选型依据、实战要点与决策评估模型。
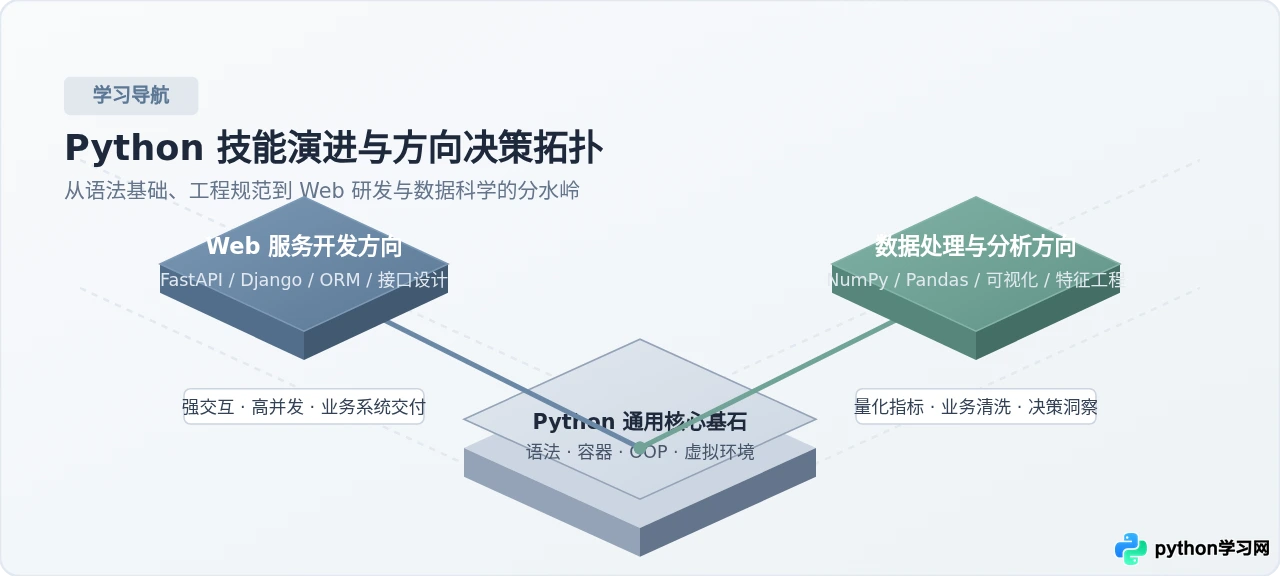
一、整体路线设计:四阶段推导与能力交付
很多初学者陷入“学了几个月语法,依然不知道能做什么”的困境,根本原因在于把时间浪费在不常用的偏门语法细节上,同时缺乏清晰的阶段性交付物。合理的学习规划必须给每个阶段设定明确的输入知识与输出标准。
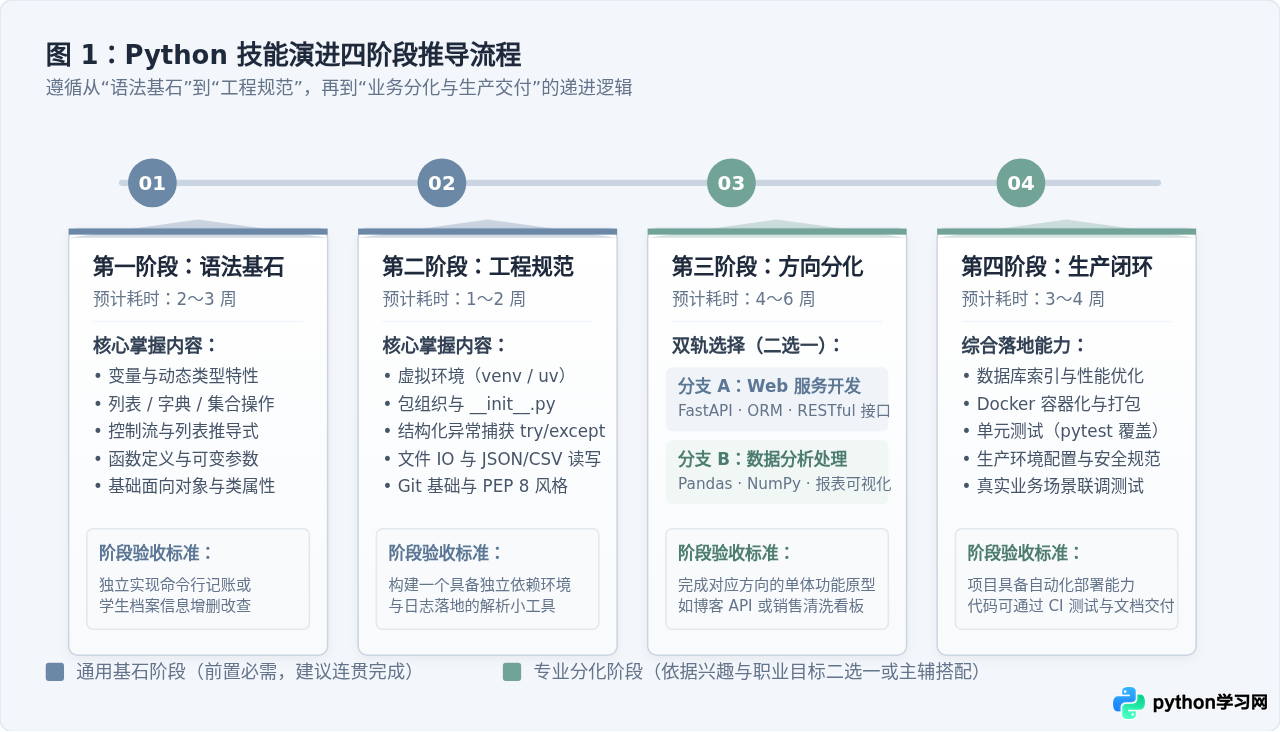
整个成长路径划分为四个阶段,每个阶段都有严谨的因果承接关系:
- 第一阶段(语法基石):掌握数据类型、基本容器、控制流、函数抽象与基础面向对象。验收标准是能独立写出控制台增删改查逻辑(例如简易账本)。
- 第二阶段(工程规范):学会使用虚拟环境隔离依赖,理解包导入机制,掌握规范的文件读写与结构化异常处理。验收标准是独立发布一个结构规范的脚本工具。
- 第三阶段(方向分化):在 Web 开发与数据分析之间二选一,集中攻坚方向专属工具链。Web 方向主攻请求路由、数据验证与数据库 ORM;数据方向主攻多维数据清洗、聚合透视与业务图表输出。
- 第四阶段(生产闭环):补齐测试、Docker 容器化、SQL 进阶与部署运维能力,完成可在线运行或产出业务决策报告的完整作品集。
二、第一阶段:通用基础语法与必须掌握的核心概念
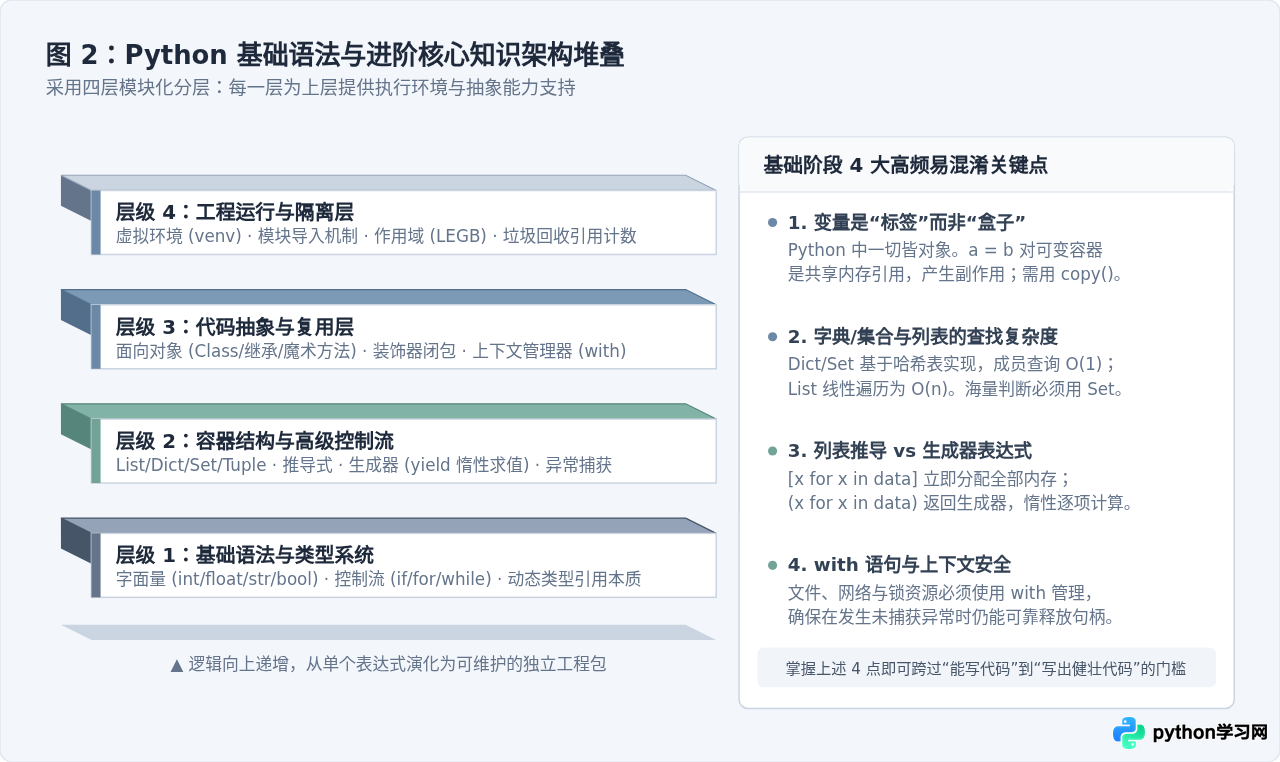
在开始的第一阶段,首要任务是建立正确的内存模型与数据操作习惯。Python 是一门动态强类型语言,理解“变量是对象的引用标签而非存储盒子”是规避绝大多数初级 Bug 的关键。
1. 核心容器与时间复杂度认知
Python 提供了四种内建容器:列表(list)、元组(tuple)、字典(dict)与集合(set)。初学者最容易犯的错误是不分场合地使用列表进行频繁的成员判断:
list是连续内存动态数组,按索引访问耗时为O(1),但使用if item in my_list进行成员查找时是线性遍历,复杂度为O(n);dict和set底层基于哈希表(Hash Table)实现,成员查找、键索引与插入的平均复杂度为O(1)。当数据规模达到万级以上时,二者的检索性能相差数千倍。
# -*- coding: utf-8 -*-
# 1. 列表推导式与字典推导式的高效数据转换
raw_users = [
    {"id": 101, "name": "alice", "role": "admin", "active": True},
    {"id": 102, "name": "bob", "role": "editor", "active": False},
    {"id": 103, "name": "charlie", "role": "viewer", "active": True},
]

# 提取活跃用户的 ID 集合(哈希表存储,保障 O(1) 检索)
active_user_ids = {user["id"] for user in raw_users if user["active"]}

# 构建以 ID 为键的用户速查字典
user_map = {user["id"]: user["name"].capitalize() for user in raw_users}

# 2. 避免可变默认参数陷阱(反例与正例对照)
# 错误写法:def append_task(task, task_list=[]):  # 函数定义时仅初始化一次空列表!
def append_task(task: str, task_list: list[str] | None = None) -> list[str]:
    """安全的可变参数传递写法"""
    if task_list is None:
        task_list = []
    task_list.append(task)
    return task_list

print("活跃用户集合:", active_user_ids)
print("用户映射字典:", user_map)
print("任务列表执行:", append_task("编写数据脚本"))活跃用户集合: {101, 103}
用户映射字典: {101: 'Alice', 102: 'Bob', 103: 'Charlie'}
任务列表执行: ['编写数据脚本']
2. 函数式抽象与面向对象(OOP)的使用边界
在 Python 中,不需要像 Java 那样把所有逻辑都封装到类(Class)中。何时写函数,何时建类,有明确的界定标准:
- 优先使用纯函数:如果一段代码只负责“输入特定参数,返回计算结果”,不依赖也不修改外部持久状态,直接写成函数即可,具备极高的可测性与复用性;
- 何时需要使用类:当多个函数需要频繁共享、操作一组有生命周期的可变状态,或者需要利用多态特性统一调用接口时,封装为 Class 才有真正价值。初学者切忌为了“显得高级”而给简单脚本强加复杂的类继承体系。
三、第二阶段:工程环境治理与开发规范
脱离了单纯的语法练习后,读者必须立刻建立现代 Python 工程习惯。许多学习者由于在全局系统环境中随意使用 pip install,最终导致不同库版本冲突、环境彻底崩溃。
1. 虚拟环境(venv)的标准操作流程
每个项目都应该拥有完全独立的虚拟运行环境。以下是在终端中的标准初始化与依赖锁定步骤:
# 1. 进入工作项目根目录
cd ~/projects/my_first_service

# 2. 创建名为 .venv 的独立虚拟运行环境
python3 -m venv .venv

# 3. 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate
# 注意:若在 Windows PowerShell 中执行,命令为: .\.venv\Scripts\Activate.ps1

# 4. 验证当前 Python 解释器路径是否已切换为局部虚拟环境
which python
# 示例输出: /Users/username/projects/my_first_service/.venv/bin/python

# 5. 安装核心项目依赖并导出环境锁文件
pip install ruff pytest
pip freeze > requirements.txt.venv/ 目录加入项目的 .gitignore 文件中,绝不应将虚拟环境本身的二进制文件提交到版本库,仅提交 requirements.txt 或 pyproject.toml 声明文件。
2. 上下文管理器与结构化异常安全
在处理文件读写、数据库连接以及网络请求时,必须通过 with 语句(上下文协议 __enter__ 和 __exit__)保障资源即使在发生未捕获异常时也能被操作系统可靠回收:
import json
from pathlib import Path

def load_app_config(config_path: Path) -> dict:
    """安全读取本地 JSON 配置文件并提供容错"""
    if not config_path.is_file():
        raise FileNotFoundError(f"配置文件不存在: {config_path}")

    try:
        # 使用 with 语句确保文件句柄自动关闭
        with config_path.open("r", encoding="utf-8") as f:
            data = json.load(f)
            return data
    except json.JSONDecodeError as err:
        # 捕获明确的异常类型,切忌使用裸露的 except:
        raise ValueError(f"配置文件 JSON 格式解析失败: {err}") from err
四、第三阶段分支 A:Python Web 开发方向进阶路径
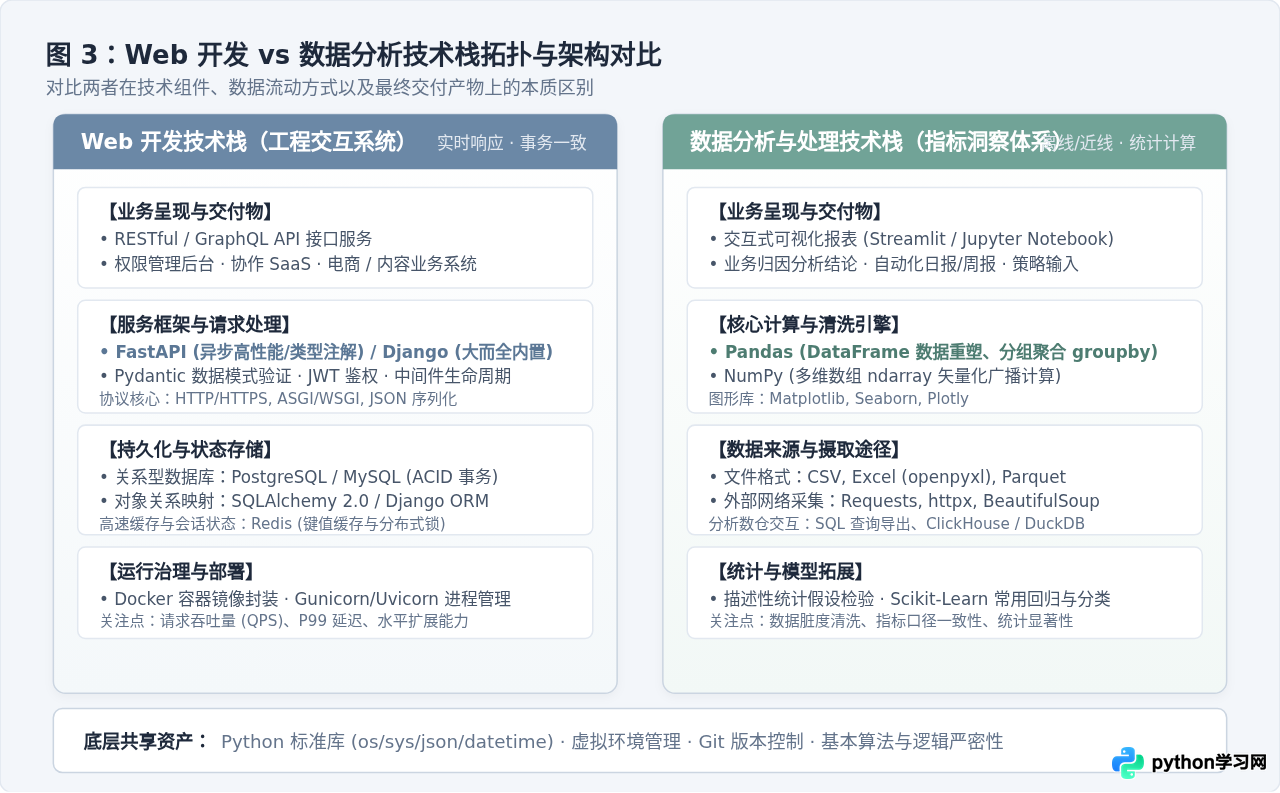
如果你选择 Web 服务开发作为主攻方向,核心工作是编写能够承接网络请求、进行身份鉴权、操作持久化数据库并返回结构化数据的服务端系统。
1. 主流 Web 框架选型标准
| 框架名称 | 核心特性与适用场景 | 学习曲线 | 推荐选择建议 |
|---|---|---|---|
| FastAPI | 基于 ASGI 原生异步架构,完全依靠 Python Type Hints 进行自动化参数校验与 OpenAPI 交互文档生成。 | 平缓且现代 | 强烈推荐。现代微服务、前后端分离 API 接口研发的首选。 |
| Django | “开箱即用”的全栈巨石框架,内置成熟的 ORM、Admin 管理后台、用户会话与权限体系。 | 较陡峭 | 适合需要快速交付完整后台管理系统或企业级复杂业务的团队。 |
| Flask | 极简微框架,核心仅包含路由和模板渲染,其余功能完全由三方插件拼装。 | 极低 | 适合极小型脚本接口或微工具,缺乏大型项目工程约束规范。 |
2. FastAPI 完整接口实现与数据验证示例
现代 Web 开发的核心是类型安全与数据边界防卫。FastAPI 结合 Pydantic 可以通过极简的代码完成强类型输入检验与状态码管理:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="用户任务调度服务", version="1.0.0")

# 1. 定义入参数据验证模型
class TaskCreateRequest(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")
    tags: list[str] = Field(default_factory=list, description="标签列表")

class TaskResponse(BaseModel):
    task_id: int
    title: str
    priority: int
    status: str

# 内存模拟数据源
_task_db: dict[int, dict] = {}
_counter = 1

@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskCreateRequest):
    """创建新任务,若标题重复则拒绝写入"""
    global _counter
    for task in _task_db.values():
        if task["title"] == payload.title:
            raise HTTPException(
                status_code=status.HTTP_400_BAD_REQUEST,
                detail=f"任务标题 '{payload.title}' 已存在,不可重复创建"
            )

    new_id = _counter
    record = {
        "task_id": new_id,
        "title": payload.title,
        "priority": payload.priority,
        "status": "pending"
    }
    _task_db[new_id] = record
    _counter += 1
return record# 发送合法创建请求:
$ curl -X POST "http://127.0.0.1:8000/api/v1/tasks" -H "Content-Type: application/json" -d '{"title": "定期备份数据库", "priority": 5}'
HTTP/1.1 201 Created
{"task_id": 1, "title": "定期备份数据库", "priority": 5, "status": "pending"}
# 发送非法参数(priority 超标):
$ curl -X POST "http://127.0.0.1:8000/api/v1/tasks" -H "Content-Type: application/json" -d '{"title": "测试", "priority": 99}'
HTTP/1.1 422 Unprocessable Entity
{"detail": [{"loc": ["body", "priority"], "msg": "Input should be less than or equal to 5", "type": "less_than_equal"}]}
五、第三阶段分支 B:Python 数据分析与处理方向进阶路径
如果你选择数据分析作为主攻方向,核心任务是从繁杂、缺失或非结构化的原始数据源中,提取定量指标、重塑数据形态,并用统计图表为业务决策提供客观依据。
1. 数据科学基础工具链分工
- NumPy(数值计算基石):提供连续内存的多维数组(
ndarray),所有计算在 C 语言层进行矢量化广播,速度比原生 Python 循环快两个数量级; - Pandas(数据清洗与重塑中心):提供带有行列索引的
DataFrame,是处理表格型数据、执行时间序列分析、缺失值填充与多表关联(Merge/Join)的行业通用工具; - Matplotlib / Seaborn(可视化呈现):负责将清洗后的统计结果绘制为折线趋势图、分布直方图、热力图或箱线图。
import pandas as pd
import numpy as np

# 1. 模拟原始脏数据(包含缺失值、字符串格式金额)
raw_records = [
    {"order_id": "A001", "channel": "Online", "amount_str": "¥120.50", "units": 2},
    {"order_id": "A002", "channel": "Store", "amount_str": "¥88.00", "units": np.nan},
    {"order_id": "A003", "channel": "Online", "amount_str": "¥230.00", "units": 5},
    {"order_id": "A004", "channel": "Store", "amount_str": None, "units": 1},
    {"order_id": "A005", "channel": "Online", "amount_str": "¥45.00", "units": 1},
]

df = pd.DataFrame(raw_records)

# 2. 清洗管线:格式解析与空值处理
# 清除货币符号并转为浮点型
df["amount"] = (
    df["amount_str"]
    .str.replace("¥", "", regex=False)
    .astype(float)
    .fillna(0.0)
)

# 数量缺失值按中位数填补
df["units"] = df["units"].fillna(df["units"].median())

# 3. 业务统计:按销售渠道分组聚合总营业额、总销量与客单价
channel_summary = (
    df.groupby("channel")
    .agg(
        total_sales=("amount", "sum"),
        total_units=("units", "sum"),
        order_count=("order_id", "count")
    )
    .assign(avg_order_value=lambda x: (x["total_sales"] / x["order_count"]).round(2))
    .reset_index()
)

print("渠道汇总数据看板:")
print(channel_summary.to_string(index=False))渠道汇总数据看板: channel total_sales total_units order_count avg_order_value Online 395.5 8.0 3 131.83 Store 88.0 3.0 2 44.00
六、第四阶段:方向选择决策模型与多维评估
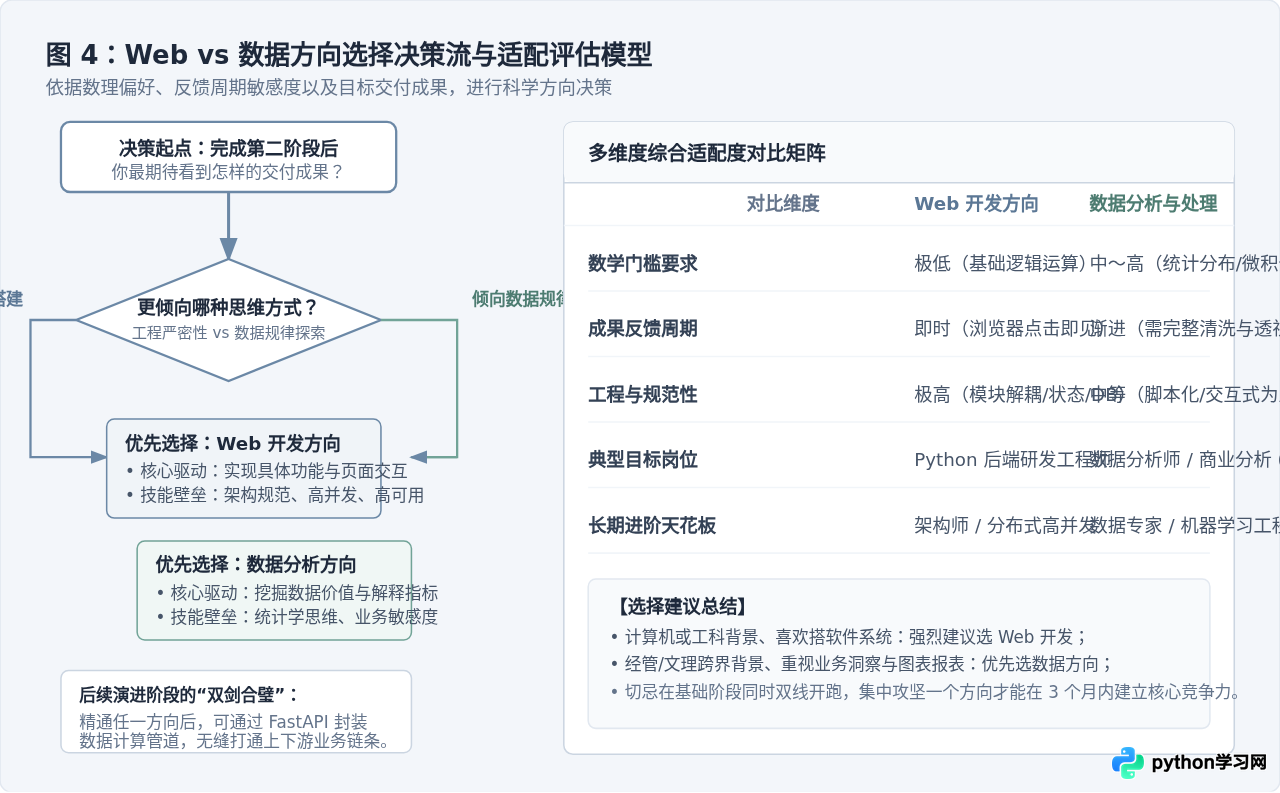
面对 Web 开发与数据分析两个前景广阔的分支,读者最常问的问题是:“我到底该选哪一个?”选择的依据绝不应该是“哪个方向听起来更时髦”,而应基于以下三个客观条件进行匹配:
1. 个人数理基础与思维偏好
Web 开发更重“软件工程严密性”:核心是逻辑解耦、状态维护、数据一致性与高并发吞吐。只要逻辑清晰、细致耐烦,即使高中数学基础薄弱,也完全可以成为优秀的 Web 工程师。
数据分析更重“统计直觉与业务洞察”:虽然初级数据清洗只需要调用 Pandas API,但如果要深入到假设检验、相关性分析、A/B 测试效果评估以及后续的机器学习,概率论、数理统计与线性代数是绕不开的核心底座。
2. 反馈周期与成就感来源
- 如果你喜欢“在浏览器里点击一个按钮,看到页面立即响应、数据落库”,倾向于建造实实在在可操作的软件系统,Web 开发能给你带来高频的正向反馈;
- 如果你喜欢“从数万行看似混乱的数据中抽丝剥茧,用直方图或透视表发现隐藏的业务规律,进而指导业务决策”,数据分析会让你更有成就感。
七、必须警惕的 3 个学习误区
许多初学者看完了三套不同的 Python 入门视频,依然不会写哪怕 50 行的独立程序。破局的关键是:在学完基础语法第二周,就强迫自己脱离参考答案,独立写一个小工具。遇到报错学会看 Traceback(回溯信息)定位错误行,在试错中建立排错能力。
试图一边学 Django 搭建网站,一边学 PyTorch 跑神经网络模型,结果往往是被复杂的配置和概念淹没,两边皆流于表面。正确的策略是:集中攻坚单一点位,完成一个完整的闭环项目后,再考虑技能横向扩展。
现实工作绝不是单文件脚本。从学习的第一天起,就应在本地初始化 Git 仓库(git init),理解分支、提交信息规范与合并操作。这不仅是求职时的硬性门槛,也是保护自己实验代码不丢失的最佳防线。
八、总结与行动指南
Python 作为一门语法凝练、生态庞大的通用编程语言,其学习路线的核心规律可以总结为十二个字:“打牢基石、选准赛道、以练促学、闭环交付”。
无论你最终选择投身于构建高吞吐 Web 系统的后端研发,还是投身于驱动数据洞察与智能决策的数据领域,扎实的语法内功、规范的工程习惯以及持续排查解决 Bug 的耐心,都将是你技术生涯中最可靠的护城河。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















