


Python实现Web邮箱扫描与收集

发布时间:2026-10-14 |
4人浏览过
本文介绍使用Python进行Web站点邮箱扫描的完整流程。通过解析URL、利用requests获取网页内容,并结合正则表达式提取邮箱地址。脚本支持递归遍历超链接,实现批量收集目标站点的邮箱信息,为后续的安全测试或钓鱼攻击提供数据基础。
信息收集是渗透测试中的关键环节,掌握详尽的目标信息对攻击者至关重要。例如,若获知服务器版本,可利用对应框架的已知漏洞进行测试;若掌握管理员邮箱,则可发起钓鱼攻击。因此,对Web站点进行邮箱扫描是实施此类攻击的前置条件。
下文将展示如何使用Python脚本实现对Web站点的邮箱扫描与爬取,旨在通过实际操作加深对Python编程的理解。
文章末尾附有完整可运行代码。
基本思路
- 接收用户输入的目标站点后,首先需对输入格式进行基础检查与分析。由于传入的地址样式多样(如 http://www.xxxx.com/ 或 http://www.xxxx.com/123/456/789.html),需对其进行拆分处理,以便后续准确解析链接。
- 利用requests库获取目标地址的页面内容,并通过正则表达式在文本中匹配符合格式的邮箱地址。
- 识别页面中的超链接,通过遍历这些链接进入子页面,继续查找目标邮箱地址。
- 具体实现步骤如下:
脚本依赖的Python库
from bs4 import BeautifulSoup #BeautifulSoup最主要的功能是从网页抓取数据,Beautiful Soup自动将输入文档转换为Unicode编码
import requests #requests是python实现的最简单易用的HTTP库
import requests.exceptions
import urllib.parse
from collections import deque #deque 是一个双端队列, 如果要经常从两端append 的数据, 选择这个数据结构就比较好了, 如果要实现随机访问,不建议用这个,请用列表.
import re #是一个正则表达式的库
获取扫描目标URL
user_url=str(input('[+] Enter Target URL to Scan:'))
urls =deque([user_url]) #把目标地址放入deque对象列表

scraped_urls= set()#set() 函数创建一个无序不重复元素集,可进行关系测试,删除重复数据,还可以计算交集、差集、并集等。
emails = set()
执行邮箱地址爬取(限制100条)
首先分析目标地址,拆分协议、域名及路径。随后使用requests的get方法访问网页,利用正则表达式 '[a-z0-0.-+]+@[a-z0-9.-+]+.[a-z]+' 过滤出符合邮箱格式的内容并收录。
count=0
try:
  while len(urls):  #如果urls有长度的话进行循环
    count += 1		#添加计数器来记录爬取链接的条数
    if count ==101:
      break
    url = urls.popleft() #popleft()会删除urls里左边第一条数据并传给url
    scraped_urls.add(url)

    parts = urllib.parse.urlsplit(url) # 打印 parts会显示:SplitResult(scheme='http', netloc='www.baidu.com', path='', query='', fragment='')
    base_url = '{0.scheme}://{0.netloc}'.format(parts)#scheme:协议;netloc:域名

    path = url[:url.rfind('/')+1] if '/' in parts.path else url#提取路径
    print('[%d] Processing %s' % (count,url))

    try:
      head = {'User-Agent':"Opera/9.80 (Macintosh; Intel Mac OS X 10.6.8; U; en) Presto/2.8.131 Version/11.11"}
      response = requests.get(url,headers = head)
    except(requests.exceptions.MissingSchema,requests.exceptions.ConnectionError):
      continue
    new_emails = set(re.findall(r'[a-z0-0\.\-+_]+@[a-z0-9\.\-+_]+\.[a-z]+', response.text ,re.I))#通过正则表达式从获取的网页中提取邮箱,re.I表示忽略大小写
    emails.update(new_emails)#将获取的邮箱地址存在emalis中。
通过解析锚点标签进入下一级网页,继续执行搜索逻辑。
    soup = BeautifulSoup(response.text, features='lxml')

    for anchor in soup.find_all('a'):  #寻找锚点。在html中,<a>标签代表一个超链接,herf属性就是链接地址
      link = anchor.attrs['href'] if 'href' in anchor.attrs else '' #如果,我们找到一个超链接标签,并且该标签有herf属性,那么herf后面的地址就是我们需要锚点链接。
      if link.startswith('/'):#如果该链接以/开头,那它只是一个路径,我们就需要加上协议和域名,base_url就是刚才分离出来的协议+域名
        link = base_url + link
      elif not link.startswith('http'):#如果不是以/和http开头的话,就要加上路径。
        link =path + link
      if not link in urls and not link in scraped_urls:#如果该链接在之前没还有被收录的话,就把该链接进行收录。
        urls.append(link)
except KeyboardInterrupt:
  print('[+] Closing')

for mail in emails:
  print(mail)
完整代码示例
from bs4 import BeautifulSoup
import requests
import requests.exceptions
import urllib.parse
from collections import deque
import re

user_url=str(input('[+] Enter Target URL to Scan:'))
urls =deque([user_url])

scraped_urls= set()
emails = set()


count=0
try:
  while len(urls):
    count += 1
    if count ==100:
      break
    url = urls.popleft()
    scraped_urls.add(url)

    parts = urllib.parse.urlsplit(url)
    base_url = '{0.scheme}://{0.netloc}'.format(parts)

    path = url[:url.rfind('/')+1] if '/' in parts.path else url

    print('[%d] Processing %s' % (count,url))
    try:
      head = {'User-Agent':"Opera/9.80 (Macintosh; Intel Mac OS X 10.6.8; U; en) Presto/2.8.131 Version/11.11"}
      response = requests.get(url,headers = head)
    except(requests.exceptions.MissingSchema,requests.exceptions.ConnectionError):
      continue
    new_emails = set(re.findall(r'[a-z0-0\.\-+_]+@[a-z0-9\.\-+_]+\.[a-z]+', response.text ,re.I))
    emails.update(new_emails)

    soup = BeautifulSoup(response.text, features='lxml')

    for anchor in soup.find_all('a'):
      link = anchor.attrs['href'] if 'href' in anchor.attrs else ''
      if link.startswith('/'):
        link = base_url + link
      elif not link.startswith('http'):
        link =path + link
      if not link in urls and not link in scraped_urls:
        urls.append(link)
except KeyboardInterrupt:
  print('[+] Closing')

for mail in emails:
  print(mail)
实验过程演示
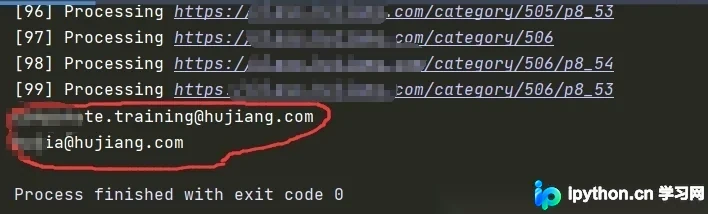
以上即为Python实现Web邮箱扫描的完整示例,更多相关技术资料请持续关注本站后续文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















