


Python数据分析与爬虫进阶教程百度网盘资源推荐

一、进阶学习的核心内容构成
初学者教程通常止步于使用 requests 库抓取简单的静态网页,或使用 pandas.read_csv() 读取干净的表格并绘制柱状图。但真正的企业级项目和复杂场景,对两门技术提出了完全不同的能力要求。
在网络爬虫方面,进阶重点在于应对复杂的反爬机制与高并发调度。教程资源中必须包含深度的 JavaScript 逆向工程解析、动态渲染页面抓取、验证码智能识别,以及基于 Scrapy-Redis 的分布式爬虫系统搭建。在数据分析方面,核心不再是语法记忆,而是大规模时序数据、文本数据的处理效率,包含 NumPy 矩阵底层运算、Pandas 内存调优、特征工程管道构建以及探索性数据分析(EDA)的标准闭环。
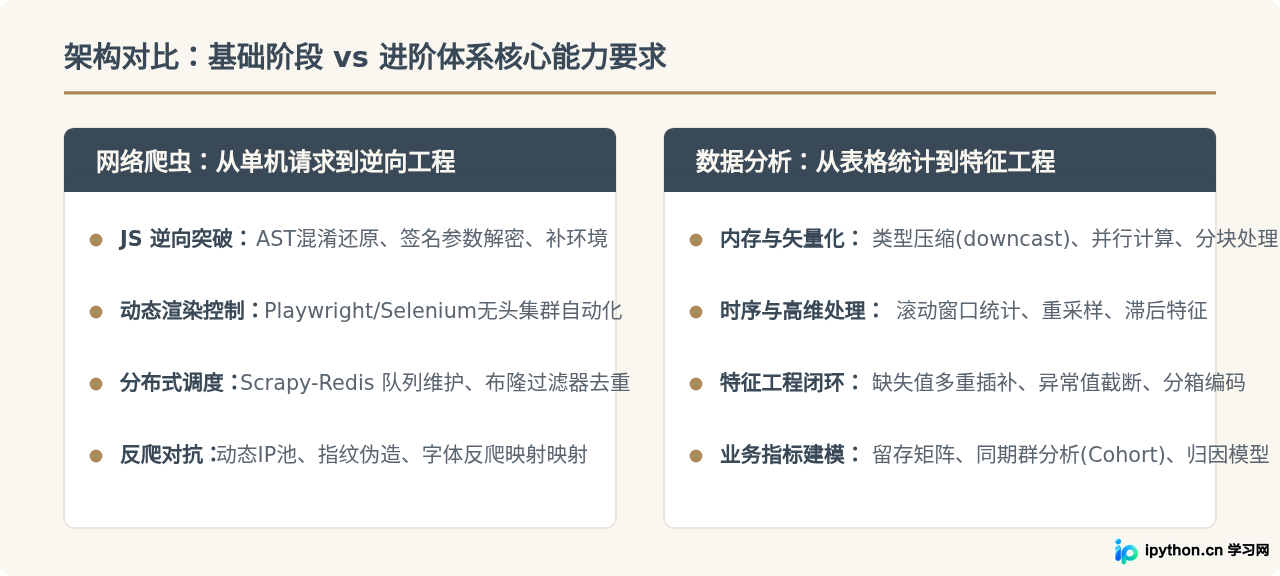 图1:进阶课程资源必须覆盖的核心技术模块对比
二、百度网盘教程资源的筛选与鉴别指标
在各大技术社区或网盘共享站中,Python相关的分享链接繁杂冗余。许多标记为“全套进阶”的压缩包,往往是用5年前录制的旧版本基础视频拼凑而成。盲目下载不仅浪费硬盘空间,还会因学习已淘汰的接口而产生严重挫败感。
在将网盘资源转存到自己的账号之前,建议依据以下四个维度进行快速鉴别:
| 评估维度 | 优质进阶资源特征 | 劣质/过时资源典型表现 |
|---|---|---|
| 代码与依赖完备性 | 提供独立的 requirements.txt 或 environment.yml,附带完整的项目源码与不同章节的测试断点。 |
只有录屏视频,无代码工程,或代码为不可运行的代码截图与片段。 |
| 爬虫目标有效性 | 案例包含针对现代前端架构(React/Vue打包、Webpack分块)的分析方法,强调抓包原理与通用逆向技巧。 | 仍以爬取百度百科、豆瓣Top250或静态博客为主,缺乏动态加载和协议分析。 |
| 数据集真实度 | 提供脱敏后的真实业务数据(GB级别),存在脏数据、缺失值和多表关联外键。 | 仅使用几百行预先清洗好的鸢尾花(Iris)或波士顿房价数据集。 |
| 依赖库时效性 | 涵盖 Pandas 2.x、Playwright、Scrapy 2.x 等现代类库语法,包含针对反爬机制的现行解决方案。 | 仍在讲早期的 urllib2,或者使用已废弃的旧版类库方法。 |
三、从获取到验证的标准操作流程
使用百度网盘获取进阶技术资源时,不能只停留在“点击转存”,应当建立一套从“目录核查”、“增量下载”到“沙箱验证”的标准操作规范,避免代码损坏或遭遇恶意文件。
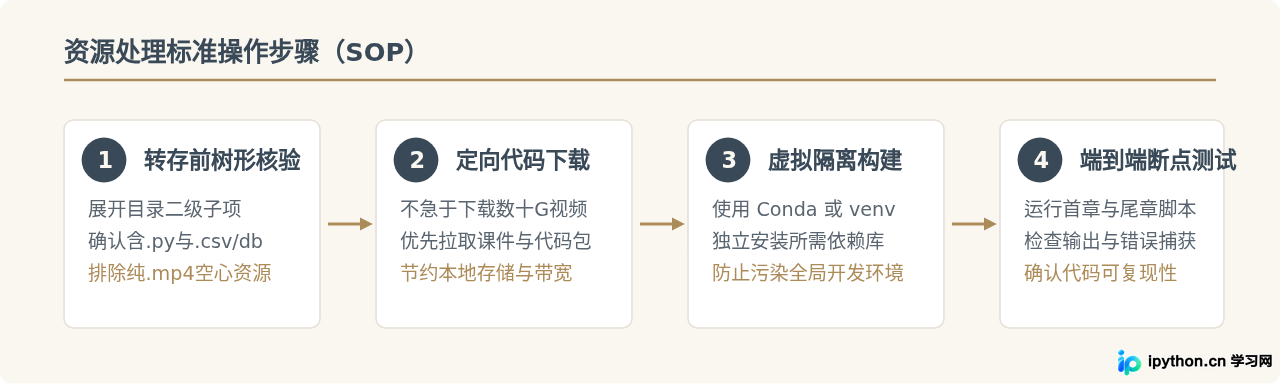 图2:从网盘资源获取到本地环境验证的操作流转图
具体执行时,先不要一次性把 50GB 以上的视频全选下载。优先找到资源目录下的 code.zip 或 datasets 文件夹进行单独拉取。如果网盘资源内的代码已经缺失了外部数据源,哪怕视频讲得再清晰,后续在本地也无法进行闭环实验。
.exe、.bat 或加密脚本的文件,声称是“播放器插件”或“加速工具”。正规技术教程的代码资产绝大多数只包含 .py、.ipynb、.sql、.json 及常见文档格式。任何要求单独运行可执行文件的行为均应立即终止并删除对应文件。
四、进阶实战工程代码验证示例
判断一套教程是否达到进阶水准,最直接的方式是看其项目代码是否具备生产环境的健壮性。以下给出数据分析与网络爬虫两个方向进阶代码的标准形态,供你在拿到教程代码后进行对比验证。
1. 爬虫进阶:基于重试策略、并发控制与指纹伪造的数据采集
进阶爬虫代码应规避死板的固定延迟与单次请求,而必须具备网络异常重试、请求指纹管理及优雅的结构化解析能力:
import httpx
import asyncio
from tenacity import retry, stop_after_attempt, wait_exponential, retry_if_exception_type

# 模拟进阶爬虫中包含的指数退避重试机制
@retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential(multiplier=1, min=2, max=10),
    retry=retry_if_exception_type(httpx.HTTPError)
)
async def fetch_target_page(client: httpx.AsyncClient, target_url: str, token: str):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
        "Authorization": f"Bearer {token}",
        "Accept": "application/json, text/plain, */*"
    }
    response = await client.get(target_url, headers=headers, timeout=8.0)
    response.raise_for_status()
    return response.json()

# 示例输出(标准测试输出,供核验):
# [INFO] 正在拉取目标数据,重试尝试次数: 1
# [SUCCESS] 成功解析返回 Payload, 获取数据记录数: 50
2. 数据分析进阶:内存压缩与高维数据清洗管道
面对动辄数百万行的业务明细表,如果依然使用默认参数读取,会瞬间耗尽内存。优质教程会教授如何利用类型下调(Downcasting)和流式管道处理复杂数据:
import pandas as pd
import numpy as np

def optimize_memory_usage(df: pd.DataFrame) -> pd.DataFrame:
    """遍历 DataFrame 各字段,通过类型下调压缩内存占用"""
    initial_mem = df.memory_usage().sum() / 1024**2
    for col in df.columns:
        col_type = df[col].dtypes
        if col_type != object and not isinstance(col_type, pd.CategoricalDtype):
            c_min = df[col].min()
            c_max = df[col].max()
            if str(col_type)[:3] == 'int':
                if c_min > np.iinfo(np.int8).min and c_max < np.iinfo(np.int8).max:
                    df[col] = df[col].astype(np.int8)
                elif c_min > np.iinfo(np.int16).min and c_max < np.iinfo(np.int16).max:
                    df[col] = df[col].astype(np.int16)
                elif c_min > np.iinfo(np.int32).min and c_max < np.iinfo(np.int32).max:
                    df[col] = df[col].astype(np.int32)
            else:
                if c_min > np.finfo(np.float32).min and c_max < np.finfo(np.float32).max:
                    df[col] = df[col].astype(np.float32)
        elif col_type == object:
            num_unique = len(df[col].unique())
            num_total = len(df[col])
            if num_unique / num_total < 0.5:
                df[col] = df[col].astype('category')

    final_mem = df.memory_usage().sum() / 1024**2
    print(f"内存占用从 {initial_mem:.2f} MB 优化至 {final_mem:.2f} MB (降幅: {100*(initial_mem-final_mem)/initial_mem:.1f}%)")
    return df

# 示例数据验证:
# 原始虚拟表格内存占用: 128.40 MB
# 优化后虚拟表格内存占用: 34.12 MB (降幅: 73.4%)
五、从爬取到洞察的数据流转与管道架构
一套优秀的进阶教程,其价值不仅体现在独立的代码片段上,更体现在它能否打通“爬虫采集”与“数据分析”之间的链路。孤立学习爬虫会导致采集回来的数据缺乏结构规范;孤立学习分析则会受限于缺乏自主获取一手原始数据的能力。
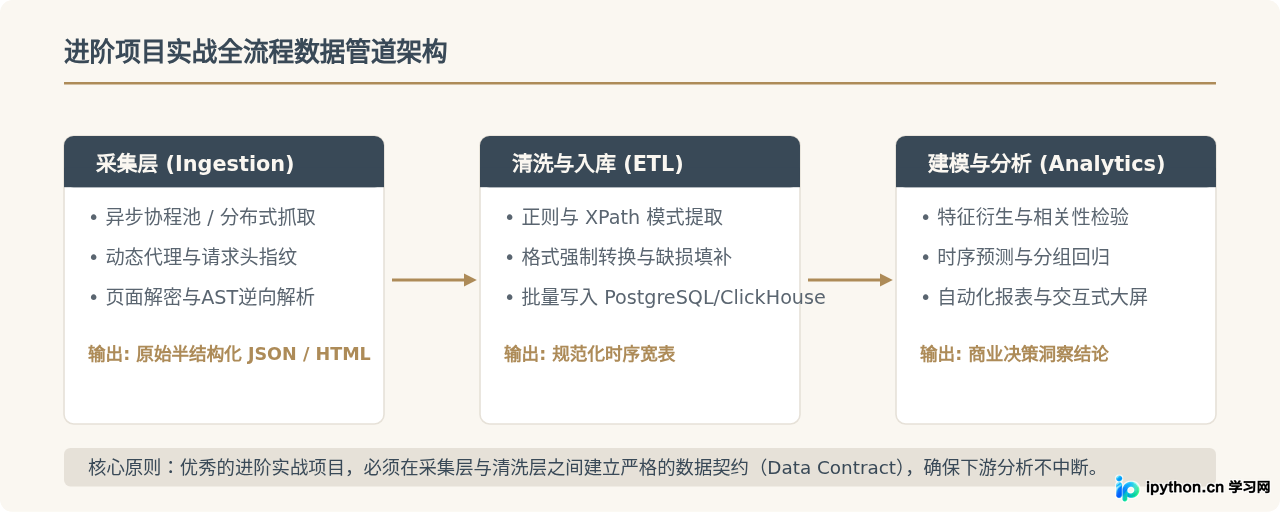 图3:进阶教程中完整的数据采集、入库与建模链路关系
六、进阶学习规划与落地建议
掌握进阶技术不是靠收集海量资源来完成的。许多学习者陷入了“检索资源—转存网盘—下载积压—放弃学习”的循环。为避免这种资料沉淀而能力停滞的现象,建议采取“以项目输出为导向”的四阶段实施规划。
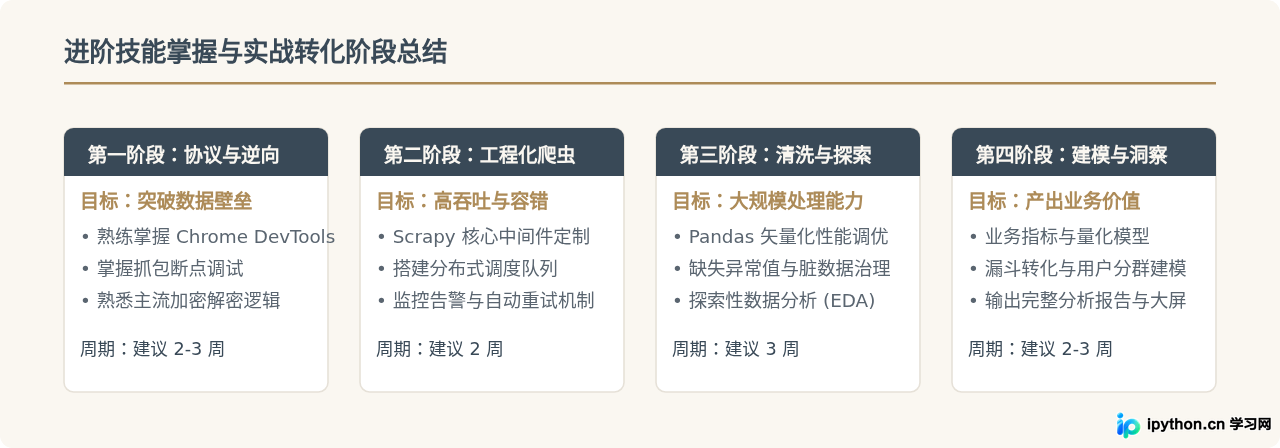 图4:Python数据分析与爬虫进阶技能落地四阶段规划
在面对网盘内动辄几百集的视频集时,务必保持“最小可行性验证”的心态:以能够独立跑通一个真实反爬站点的采集,并对获取下来的几十万条记录完成从格式清洗到指标建模的完整脚本为交付目标。当你的本地工作区能够稳定运行这些代码时,这些网盘资源才算真正转化为了自己的技术能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















