


Python实现按关键词分类下载百度图片并保存至独立文件夹

发布时间:2026-10-14 |
4人浏览过
本文介绍如何使用Python编写爬虫程序,从百度图片批量下载指定关键词的图片。核心功能是根据关键词列表自动创建对应的独立文件夹,并将下载的图片按顺序编号保存至各自目录中。文章提供了完整的代码示例及参数配置说明,包括如何设置请求头、控制爬取页数以及处理图片保存路径,帮助用户实现高效的图片分类抓取与存储。
例如,若需爬取赵丽颖、赵本山、赵文卓、赵欢、赵日天等人的图片,程序将分别创建以这些名字命名的文件夹,并将对应的图片保存至相应的目录中。
测试代码
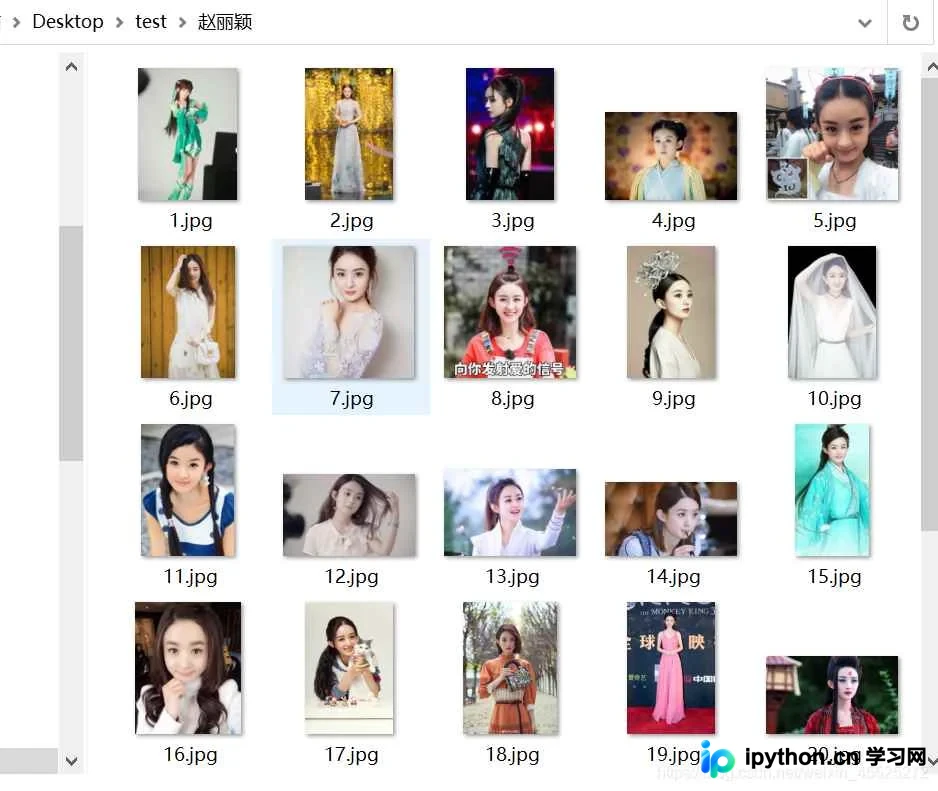
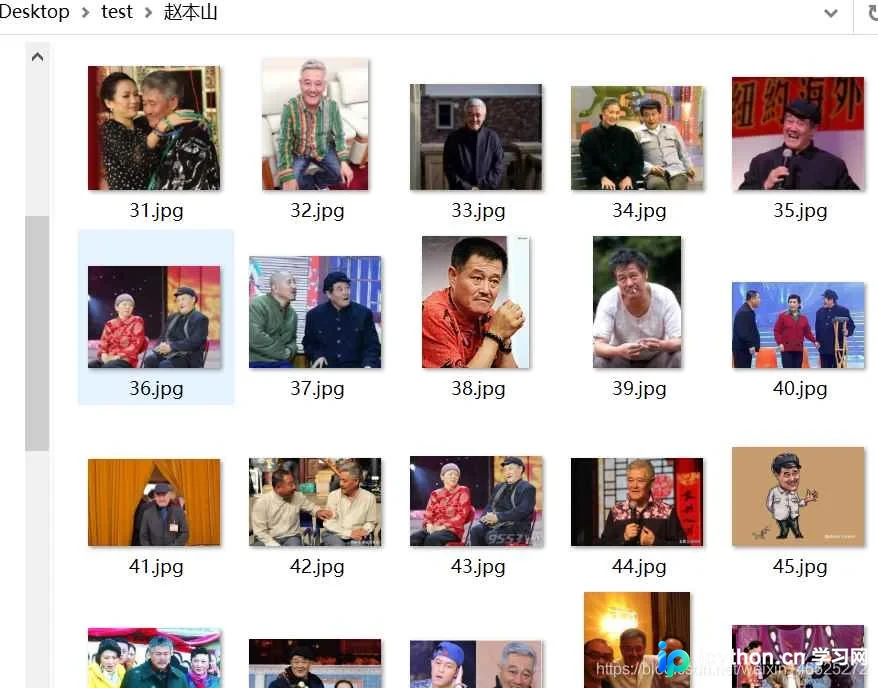
此处省略部分图片展示。
import requests
import time
import os
# 请求头,伪装成浏览器
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.116 Safari/537.36'
}
# keyword = '云斑白条天牛' # 关键字
keywords = ['赵丽颖','赵本山','赵文卓','赵欢','赵日天']
max_page = 2
i=1 # 记录图片数
for keyword in keywords:
os.makedirs(keyword)
for page in range(1,max_page):
page = page*30
# 网址
url = 'https://image.baidu.com/search/acjson?tn=resultjson_com&ipn=rj&ct=201326592&is=&fp=result&queryWord='\
+keyword+'&cl=2&lm=-1&ie=utf-8&oe=utf-8&adpicid=&st=-1&z=&ic=0&hd=&latest=©right=&word='\
+keyword+'&s=&se=&tab=&width=&height=&face=0&istype=2&qc=&nc=1&fr=&expermode=&force=&cg=wallpaper&pn='\
+str(page)+'&rn=30&gsm=1e&1596899786625='
# 请求响应
response = requests.get(url=url,headers=headers)
# 得到相应的json数据
json = response.json()
if json.get('data'):
for item in json.get('data')[:30]:
# 图片地址
img_url = item.get('thumbURL')
# 获取图片
image = requests.get(url=img_url)
# 下载图片
newstr = './'+keyword+'/'+str(i)+'.jpg'
# with open('./%s/%d.jpg'%keywords ,%i,'wb') as f:
with open(newstr,'wb') as f:
f.write(image.content) # 图片二进制数据
time.sleep(1) # 等待1s
print('第%d张%s图片下载完成...'%(i,keyword))
i+=1
print('End!')
你需要修改的参数
只需将希望爬取的关键字填入 keywords 数组中即可。
# 这里放你要查询的数组
keywords = ['','','',']
max_page 参数用于控制爬取百度图片的页数,每页包含 30 张图片。例如,设置 max_page 为 2 即可爬取 30 张图片,设置为 3 则爬取 60 张,依此类推。
max_page = 3完整代码
具体实现代码如下:
import requests
import time
import os
# 请求头,伪装成浏览器
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.116 Safari/537.36'
}
# 这里放你要查询的数组
keywords = ['','','',']
max_page = 4
i=1 # 记录图片数
for keyword in keywords:
os.makedirs(keyword)
for page in range(1,max_page):
page = page*30
# 网址
url = 'https://image.baidu.com/search/acjson?tn=resultjson_com&ipn=rj&ct=201326592&is=&fp=result&queryWord='\
+keyword+'&cl=2&lm=-1&ie=utf-8&oe=utf-8&adpicid=&st=-1&z=&ic=0&hd=&latest=©right=&word='\
+keyword+'&s=&se=&tab=&width=&height=&face=0&istype=2&qc=&nc=1&fr=&expermode=&force=&cg=wallpaper&pn='\
+str(page)+'&rn=30&gsm=1e&1596899786625='
# 请求响应
response = requests.get(url=url,headers=headers)
# 得到相应的json数据
json = response.json()
if json.get('data'):
for item in json.get('data')[:30]:
# 图片地址
img_url = item.get('thumbURL')
# 获取图片
image = requests.get(url=img_url)
# 下载图片
newstr = './'+keyword+'/'+str(i)+'.jpg'
# with open('./%s/%d.jpg'%keywords ,%i,'wb') as f:
with open(newstr,'wb') as f:
f.write(image.content) # 图片二进制数据
time.sleep(1) # 等待1s
print('第%d张%s图片下载完成...'%(i,keyword))
i+=1
print('End!')至此,关于 Python 爬取不同图片并分别保存在不同文件夹中的实现介绍完毕。如需了解更多相关 Python 爬取图片及保存至不同文件夹的内容,请搜索本站历史文章或继续浏览后续相关文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















