


Python抓取百度热搜榜完整实现代码

发布时间:2026-10-14 |
4人浏览过
本文分享使用Python获取百度实时热搜的完整代码实现。通过requests库发起请求,结合lxml进行HTML解析,提取热搜标题及排名数据,并演示如何将结果整理为排序后的字典格式,供开发者参考学习。
Python抓取百度热搜示例
近期未更新内容,现分享一个课堂练习项目。百度网页界面如下图所示:
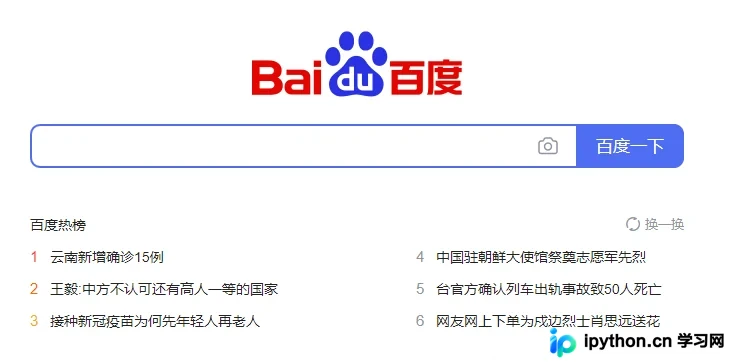
程序运行后的输出结果截图如下:

具体实现代码如下:
from lxml import etree
from lxml import html
import requests

headers={'User-Agent':'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.63 Safari/537.36'}
page = requests.get("https://www.baidu.com",headers=headers)
html = page.text
#print(source1)
# 从字符串解析
element = etree.HTML(html)

# 元素列表,获取的方式列出了如下两种
# ps = element.xpath('//*[@id="hotsearch-content-wrapper"]/li/a/span[2]')
ps = element.xpath('//*[@class="title-content-title"]')

#热搜文本内容
text = []
if len(ps) > 0:
  for p in ps:
    #输出节点的文本
    text1 = p.text
    text.append(text1)
else:
  print("空")

x = element.xpath('//*[@class="s-hotsearch-content"]/li')

#热搜文本对应的排名
index = []
for x1 in x:
  #获取节点的属性
  index1 = x1.get("data-index")
  index.append(index1)

print(text)
print(index)

#定义一个对文本和排名进行匹配的函数,返回一个字典型数据
def PP(index_array,text_array):
  x = {}
  i = 0
  for index_a in index_array:
    #index_a = int(index_a)

    x[index_a] = text_array[i]
    i = i + 1
  return x

re_text = PP(index,text)
#对字典性数据按key进行排序,即key=lambda re:re[0],排序完成后再转换为字典型数据
last_text = dict(sorted(re_text.items(),key=lambda re:re[0]))
以上就是关于Python获取百度热搜的完整代码介绍,更多相关Python 百度热搜内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















