


本地部署通义千问开源版(Qwen-7B/72B):硬件要求与步骤详解

在本地运行大型语言模型已成为许多开发者和研究者的常态。通义千问(Qwen)作为阿里云推出的开源系列模型,提供了从7B到72B不同参数规模的版本,适应从消费级显卡到服务器集群的各种硬件环境。要在本地成功跑通Qwen,首先需要明确硬件底线,其次才是软件环境的搭建。
概述
本地部署的核心挑战在于显存(VRAM)容量和内存带宽。Qwen-7B适合单张中高端消费级显卡,而Qwen-72B则通常需要多卡并行或高显存的专业加速卡。软件层面,主要依赖PyTorch生态和Transformers库进行模型加载与推理。
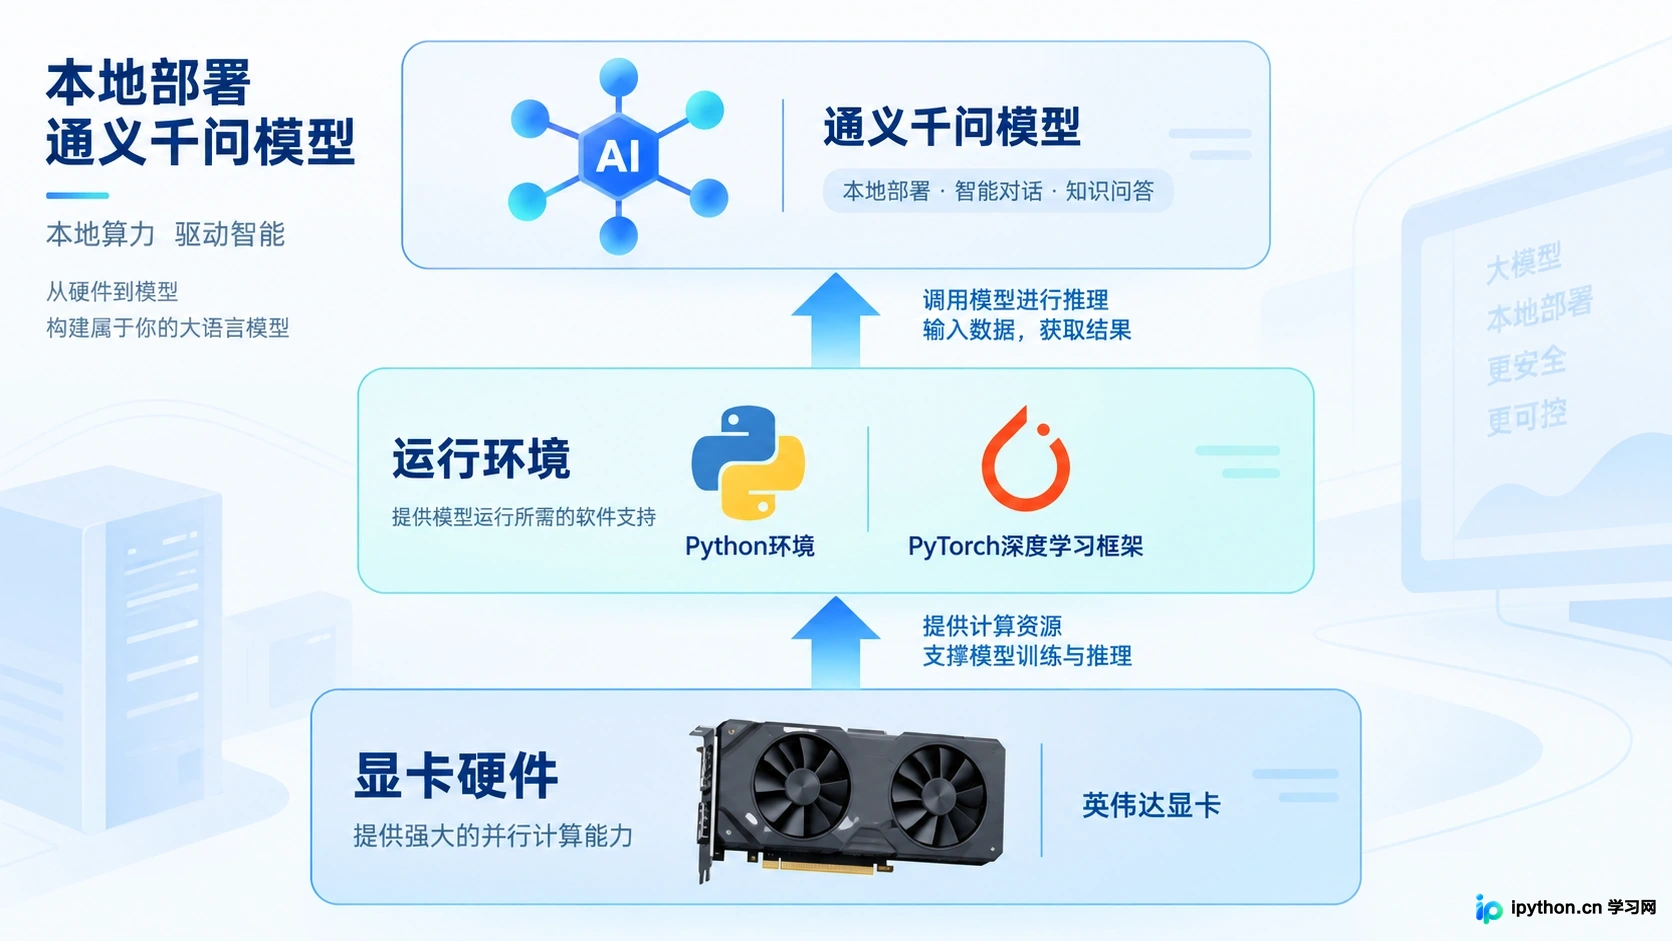
本地部署Qwen模型的硬件与软件层级关系
关于硬件要求
硬件选择直接决定了你能运行哪个版本的模型以及推理的速度。以下是两个典型版本的最低与推荐配置参考。
Qwen-7B 配置建议
Qwen-7B是一个中等规模的模型,经过量化处理后可以在单张消费级显卡上流畅运行。
- 显存要求:FP16精度下约需14GB显存;使用INT4量化后,8GB显存即可启动,但12GB-16GB更为从容。
- 推荐显卡:NVIDIA RTX 3060 12G、RTX 4090 24G或A10/A100等。
- 内存:建议系统内存至少16GB,用于数据预处理和缓存。
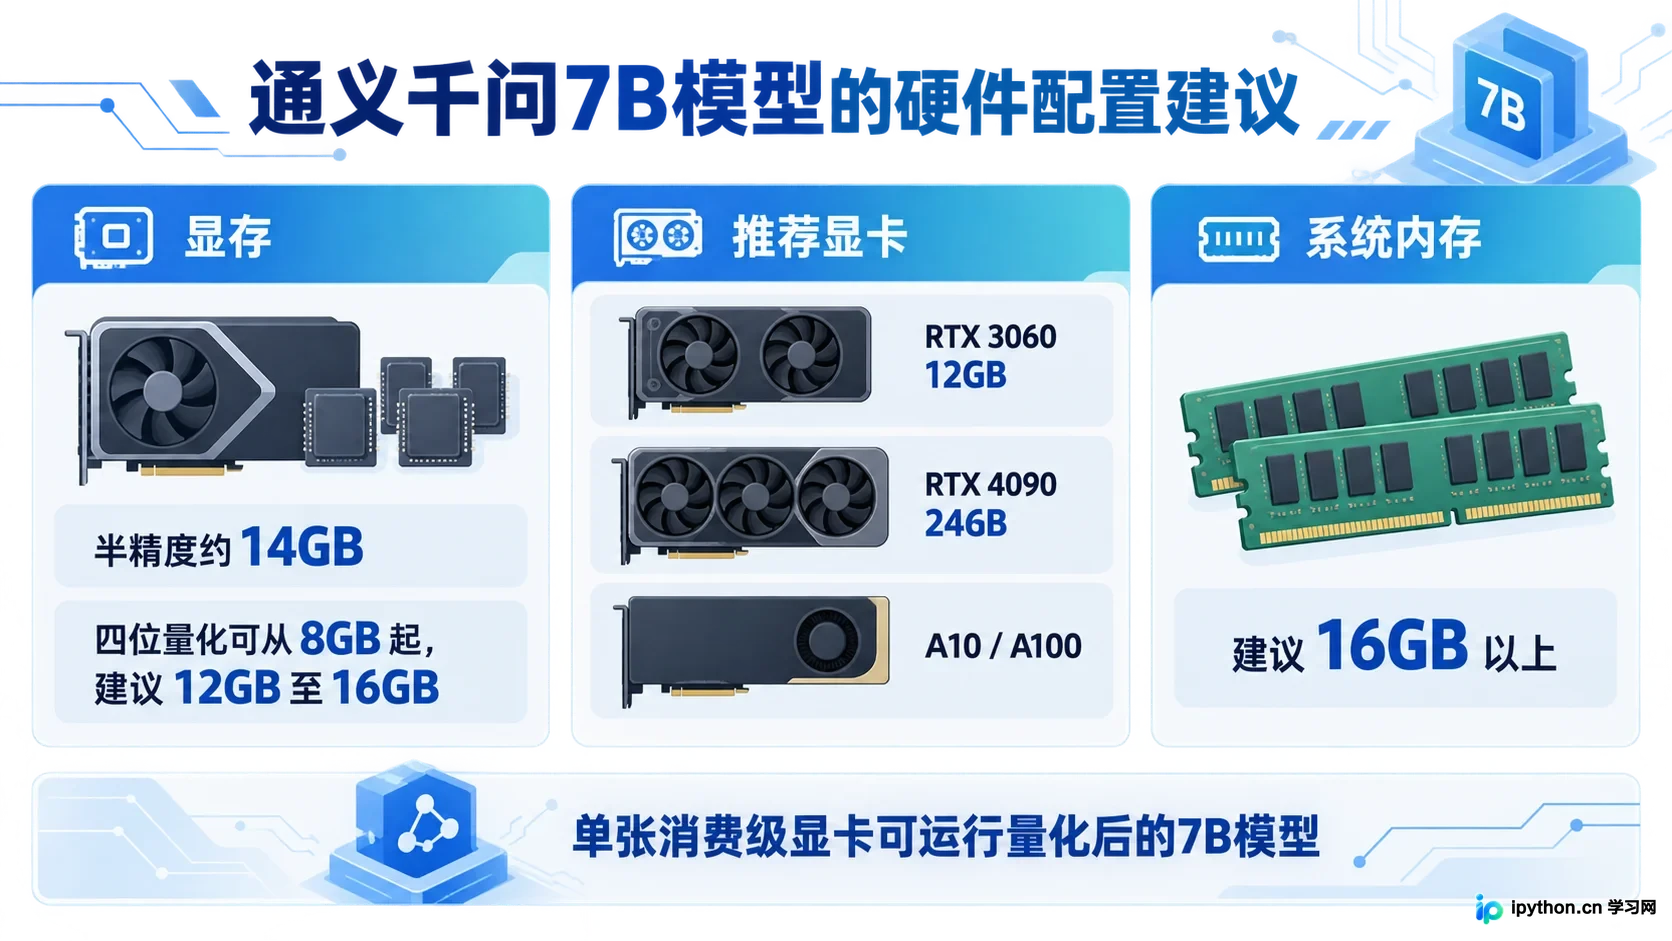
Qwen-7B 配置建议
Qwen-72B 配置建议
Qwen-72B参数量巨大,对硬件要求极高,通常面向企业级或专业工作站场景。
- 显存要求:FP16精度下需超过140GB显存,必须多卡并行;INT4量化后约需40GB-48GB显存,可通过两张A100 80G或四张RTX 3090/4090实现。
- 推荐显卡:NVIDIA A100 80G、H800或多张RTX 4090组建的多卡系统。
- 内存:建议系统内存64GB以上,以确保模型加载时的稳定性。
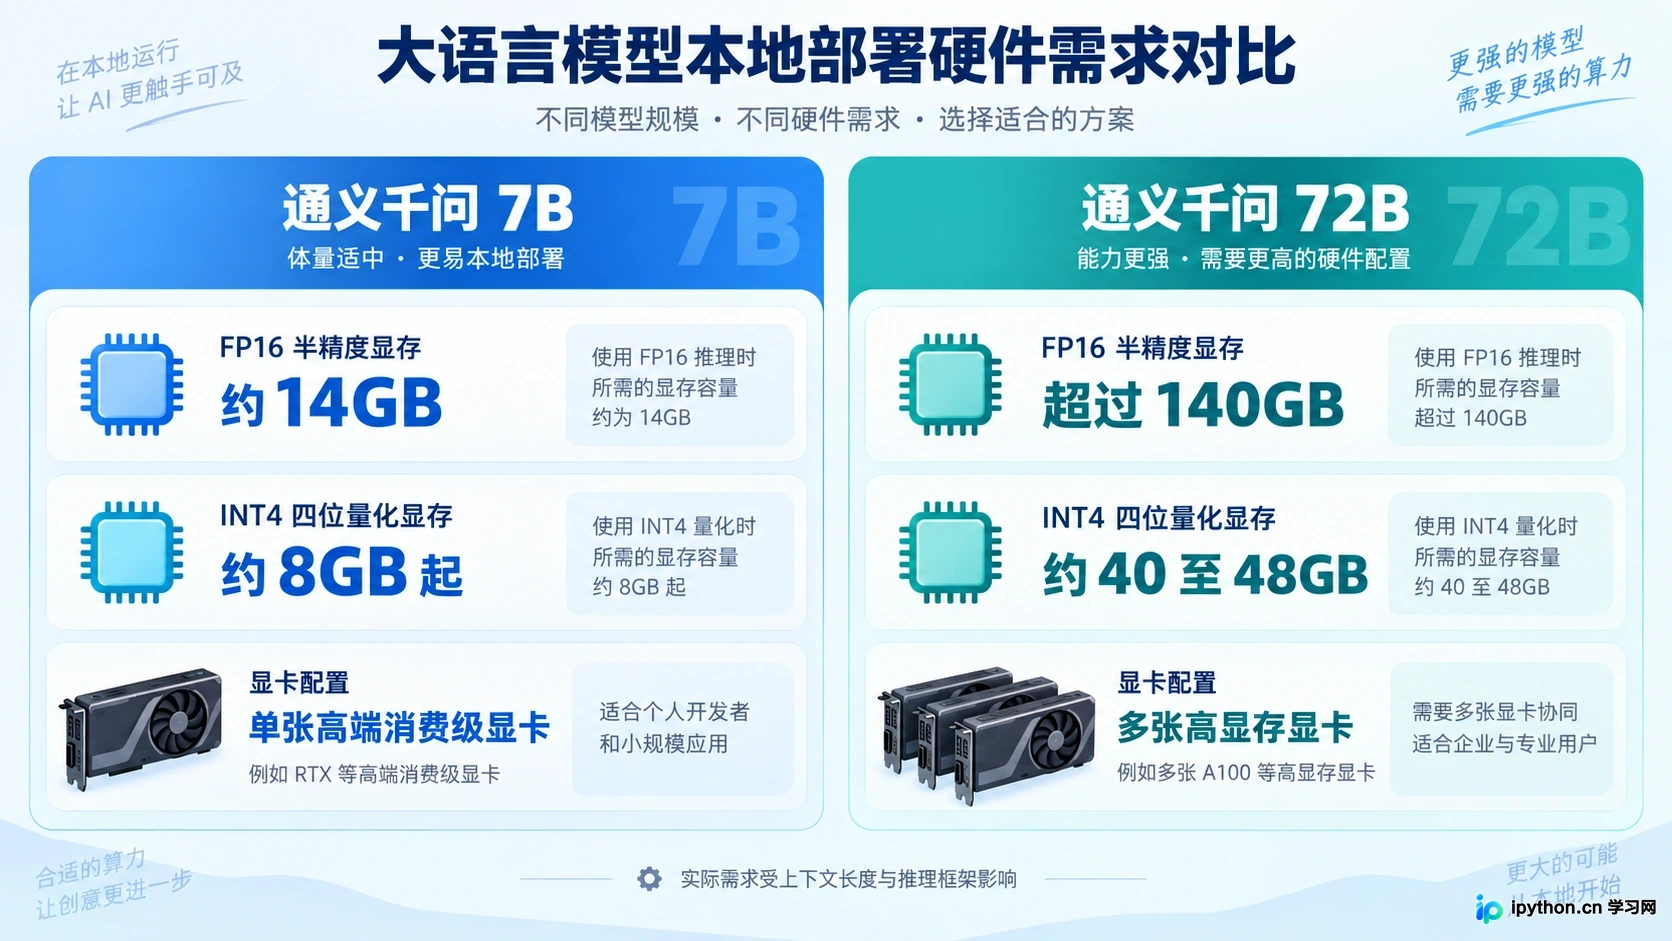
不同规模模型的显存与显卡需求对比
关于环境准备
在确认硬件达标后,需要构建基础的Python运行环境。建议使用Conda进行环境隔离,避免依赖冲突。
- 安装Miniconda或Anaconda。
- 创建独立的Python环境,建议Python版本为3.10或3.11。
- 安装PyTorch,务必根据CUDA版本选择对应的安装包,以启用GPU加速。
conda create -n qwen_env python=3.10
conda activate qwen_env
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
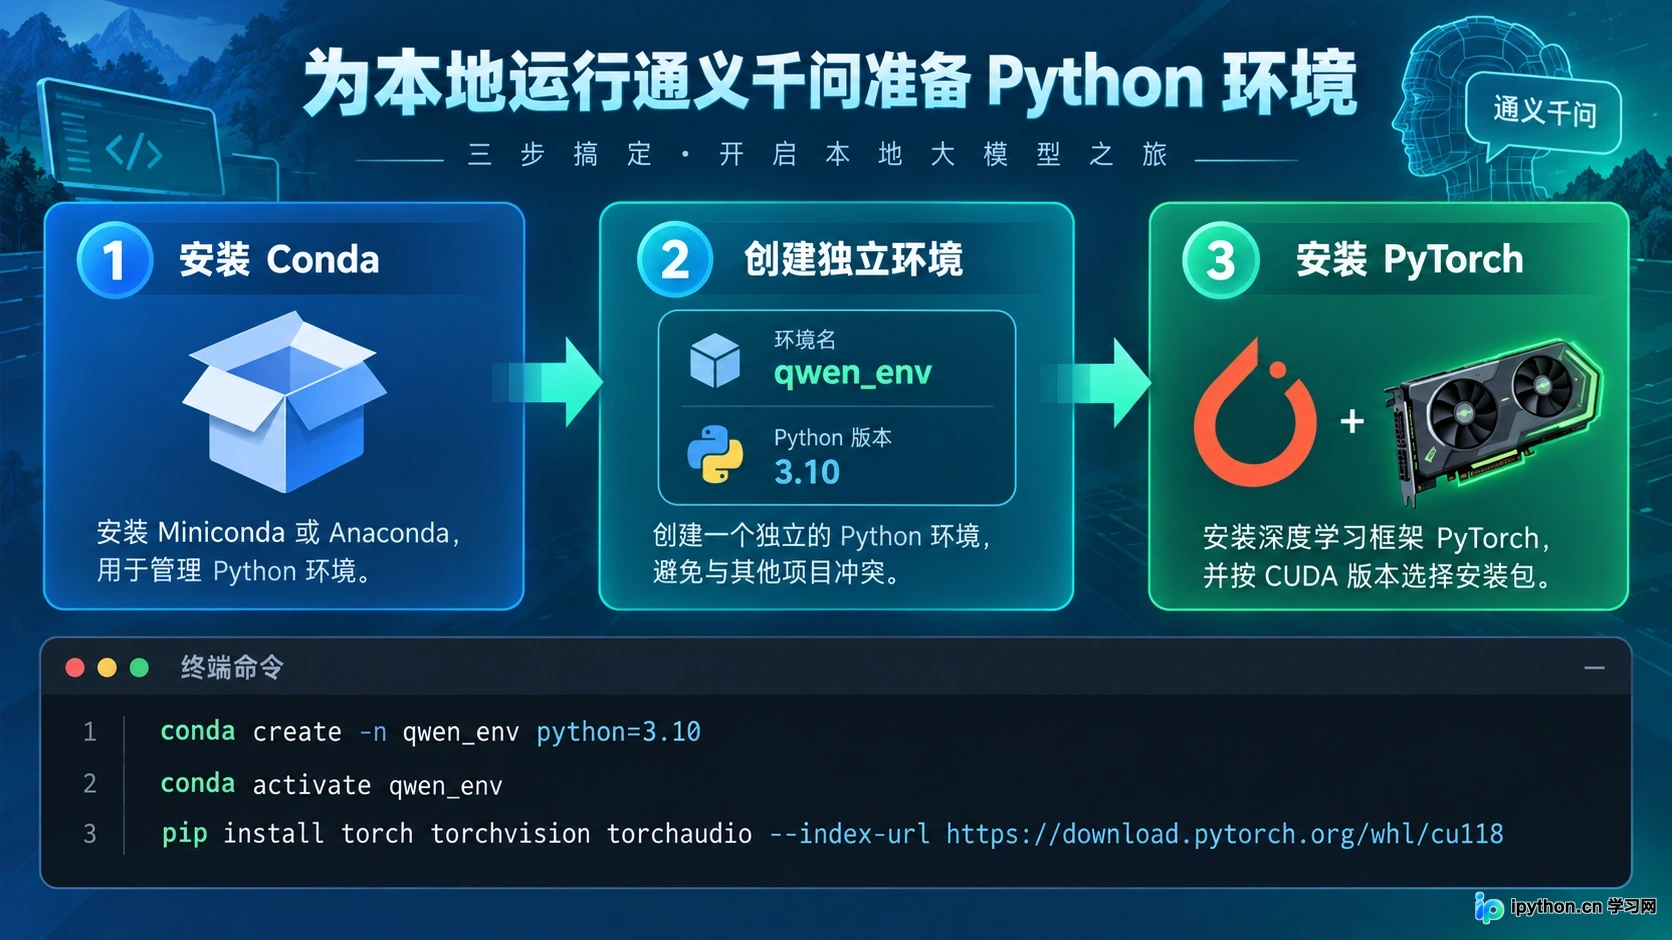
关于环境准备
关于模型下载与加载
通义千问的模型权重托管在Hugging Face Hub和ModelScope上。这里以Hugging Face为例,展示如何使用Transformers库加载模型。
首先安装必要的库:
pip install transformers accelerate sentencepiece
接着编写加载脚本。以下代码展示了如何加载Qwen-7B-Chat模型并进行一次简单的对话测试。注意,device_map="auto"可以让Accelerate自动分配模型层到可用的GPU上。
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

model_name = "Qwen/Qwen-7B-Chat"

# 加载分词器
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)

# 加载模型,启用半精度以节省显存
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    trust_remote_code=True,
    torch_dtype=torch.float16
)

# 准备输入
prompt = "你好,请介绍一下你自己。"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# 生成回复
outputs = model.generate(**inputs, max_new_tokens=512)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(response)
关于推理优化
对于资源有限的用户,量化是降低显存占用的有效手段。Qwen官方支持AWQ和GPTQ等量化格式。
如果使用INT4量化版本,只需更改模型路径即可。例如,使用Qwen/Qwen-7B-Chat-Int4替换上述代码中的model_name。这种方式可以将显存占用降低一半以上,同时保持较好的语言理解能力。
对于Qwen-72B,如果显存依然紧张,可以考虑使用vLLM或TensorRT-LLM等高性能推理框架,它们通过PagedAttention等技术显著提升了吞吐量和并发处理能力,但配置复杂度也相应增加。
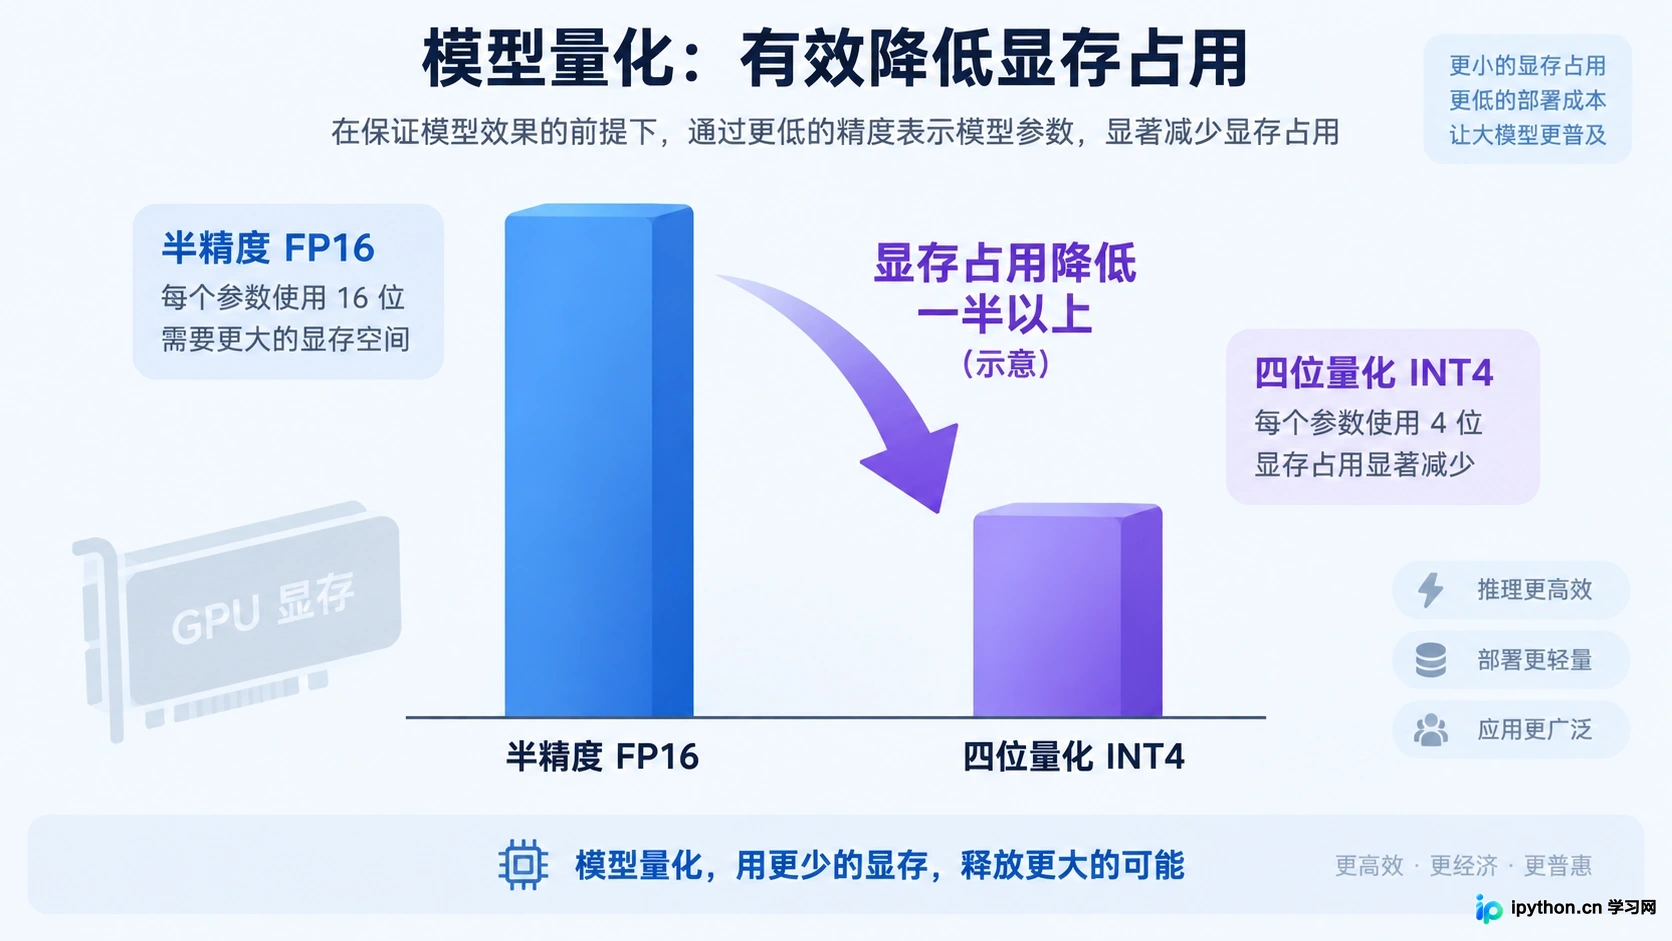
INT4量化对显存占用的优化效果
完成上述步骤后,你便拥有了一个可在本地运行的通义千问实例。后续可根据具体应用场景,调整温度参数(temperature)、顶核采样(top_p)等生成策略,以获得更符合预期的输出结果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















