


长文本处理大模型排名:支持百万级Token上下文的模型有哪些

在处理整本技术手册、法律卷宗或代码库时,传统大模型往往因上下文窗口限制而丢失关键信息。具备百万级 Token 上下文能力的模型,允许用户一次性输入数十万字的材料,无需复杂的分块检索策略即可实现全局理解。这种“全量输入”模式显著降低了信息碎片化带来的幻觉风险,提升了复杂逻辑推理的连贯性。
上下文长度并非唯一指标,核心在于模型能否在海量噪声中精准定位特定事实,即“大海捞针”(Needle In A Haystack)能力。目前主流厂商均发布了支持 100K 至 1M+ Token 的模型版本,但在实际检索准确率和推理成本上存在明显梯队差异。
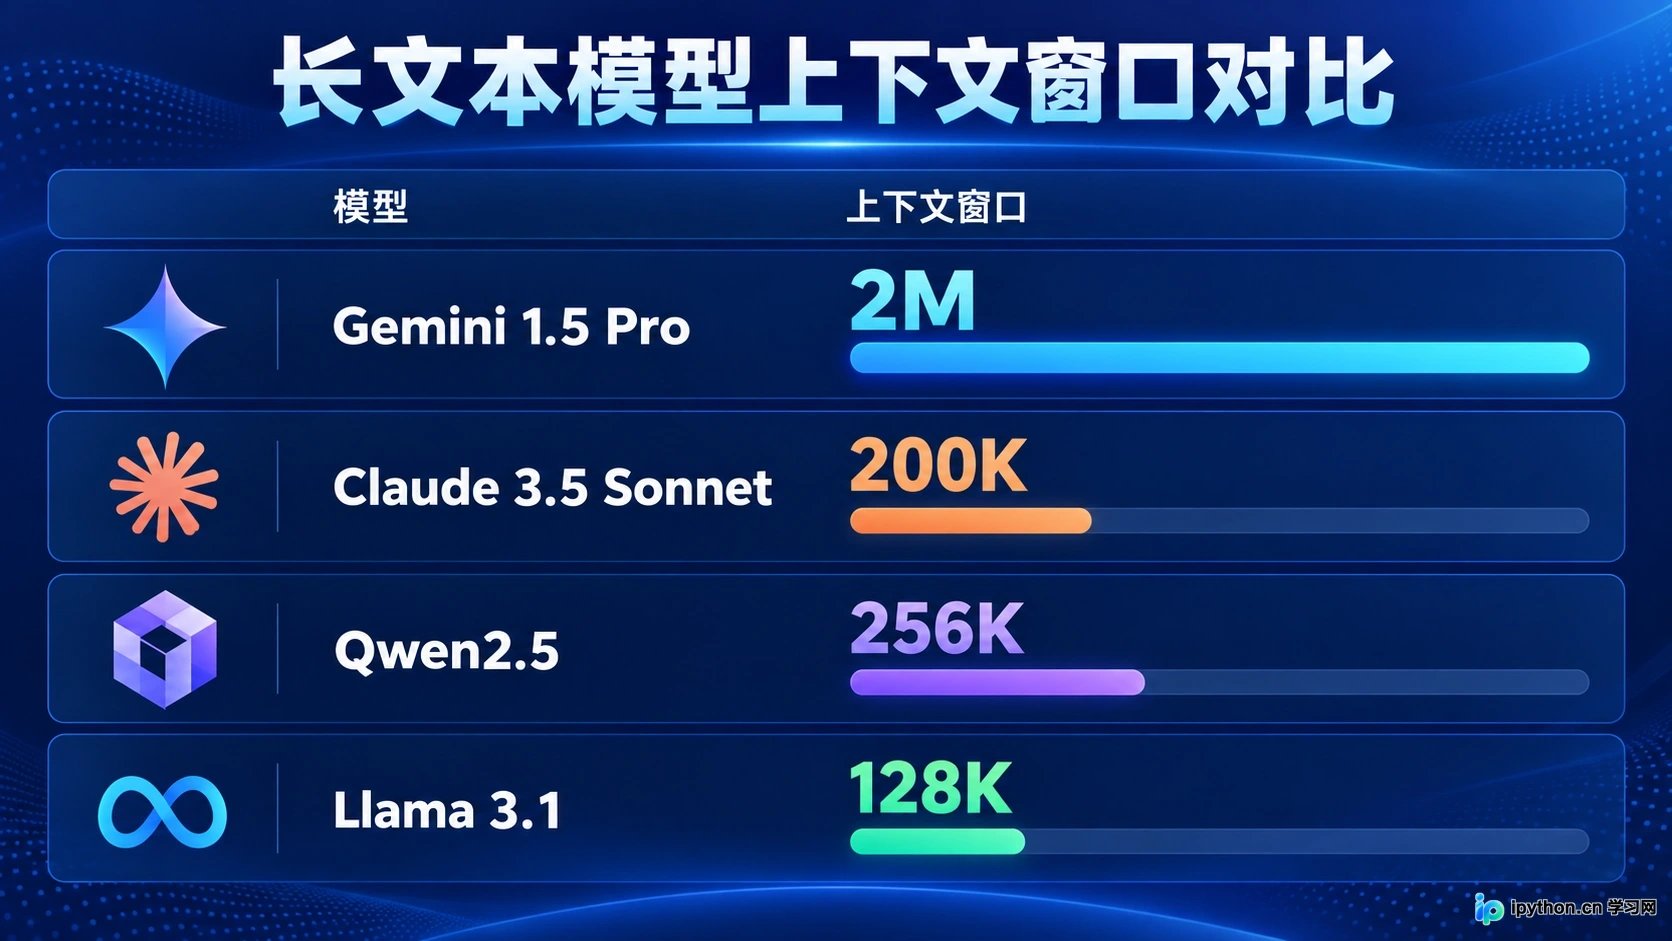
主流长文本大模型核心参数对比概览
1. 第一梯队:百万级窗口的稳定表现者
这一梯队的模型在官方基准测试中,能够在 1M Token 的极端长度下保持极高的检索准确率,适合对完整性要求极高的专业场景。
Google Gemini 1.5 Pro
Gemini 1.5 Pro 是目前公开支持上下文最长的模型之一,标准窗口为 128K,可扩展至 1M 甚至 2M Token。其最大优势在于多模态长上下文处理能力,不仅能处理文本,还能同时分析长达数小时的视频或音频文件。
在“大海捞针”测试中,Gemini 1.5 Pro 在 1M Token 长度下的检索准确率接近 100%。这意味着即使将关键信息隐藏在数百万字的中段,它也能精准提取。对于需要跨文档关联、视频内容摘要的企业级应用,它是首选方案。
Anthropic Claude 3.5 Sonnet
Claude 3.5 Sonnet 支持 200K Token 的上下文窗口。虽然数值上不及 Gemini,但 Anthropic 在长文本的逻辑连贯性和指令遵循上表现优异。它在处理长代码库重构、长篇文学创作时,能更好地保持人物设定或代码风格的一致性。
实测显示,Claude 3.5 Sonnet 在 200K 范围内的“大海捞针”测试中几乎零失误,且在长文本总结的细腻程度上优于多数竞品。对于 200K 以内的重度文本分析任务,其性价比和响应速度更具优势。
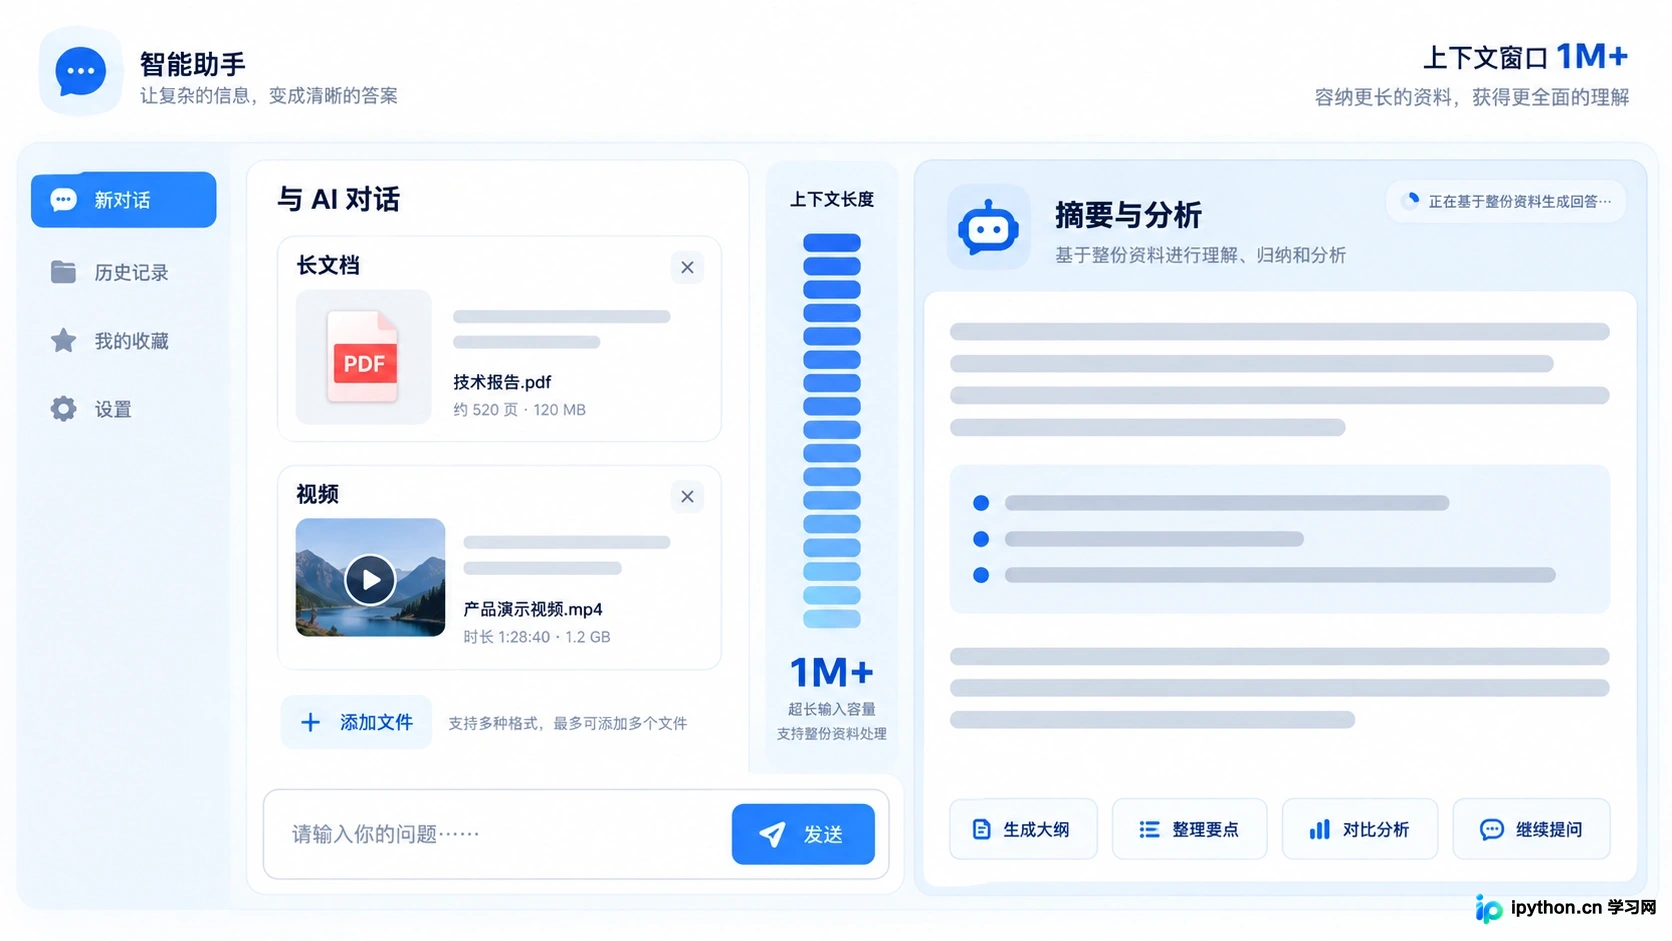
Gemini 1.5 Pro 处理超长文档的界面示意
2. 第二梯队:高性价比的开源与国产主力
这一梯队的模型通常支持 128K-256K Token,虽然在极限长度上略逊于第一梯队,但在常规长文档(如几百页的 PDF)处理上已完全够用,且部署成本更低。
Qwen2.5 (通义千问)
阿里云发布的 Qwen2.5 系列中,多个版本原生支持 128K 上下文,部分版本通过扩展可达 256K 或更高。Qwen2.5 在中文长文本理解上具有天然优势,特别是在处理中文法律条文、古籍文献时,其语义捕捉能力优于许多纯英文优化的模型。
在长文本检索测试中,Qwen2.5 在 128K 长度下保持了极高的准确率,且在多轮对话中不易遗忘早期设定的约束条件。对于国内开发者而言,其开放的 API 和本地部署选项提供了更大的灵活性。
Llama 3.1 (405B/70B)
Meta 发布的 Llama 3.1 系列将上下文窗口从 8K 大幅提升至 128K。作为开源界的标杆,Llama 3.1 的长文本能力使其成为私有化部署长文档分析系统的首选基座。虽然其在极端长度下的检索精度略低于闭源顶尖模型,但通过 RAG(检索增强生成)技术的配合,足以胜任绝大多数企业知识库问答场景。
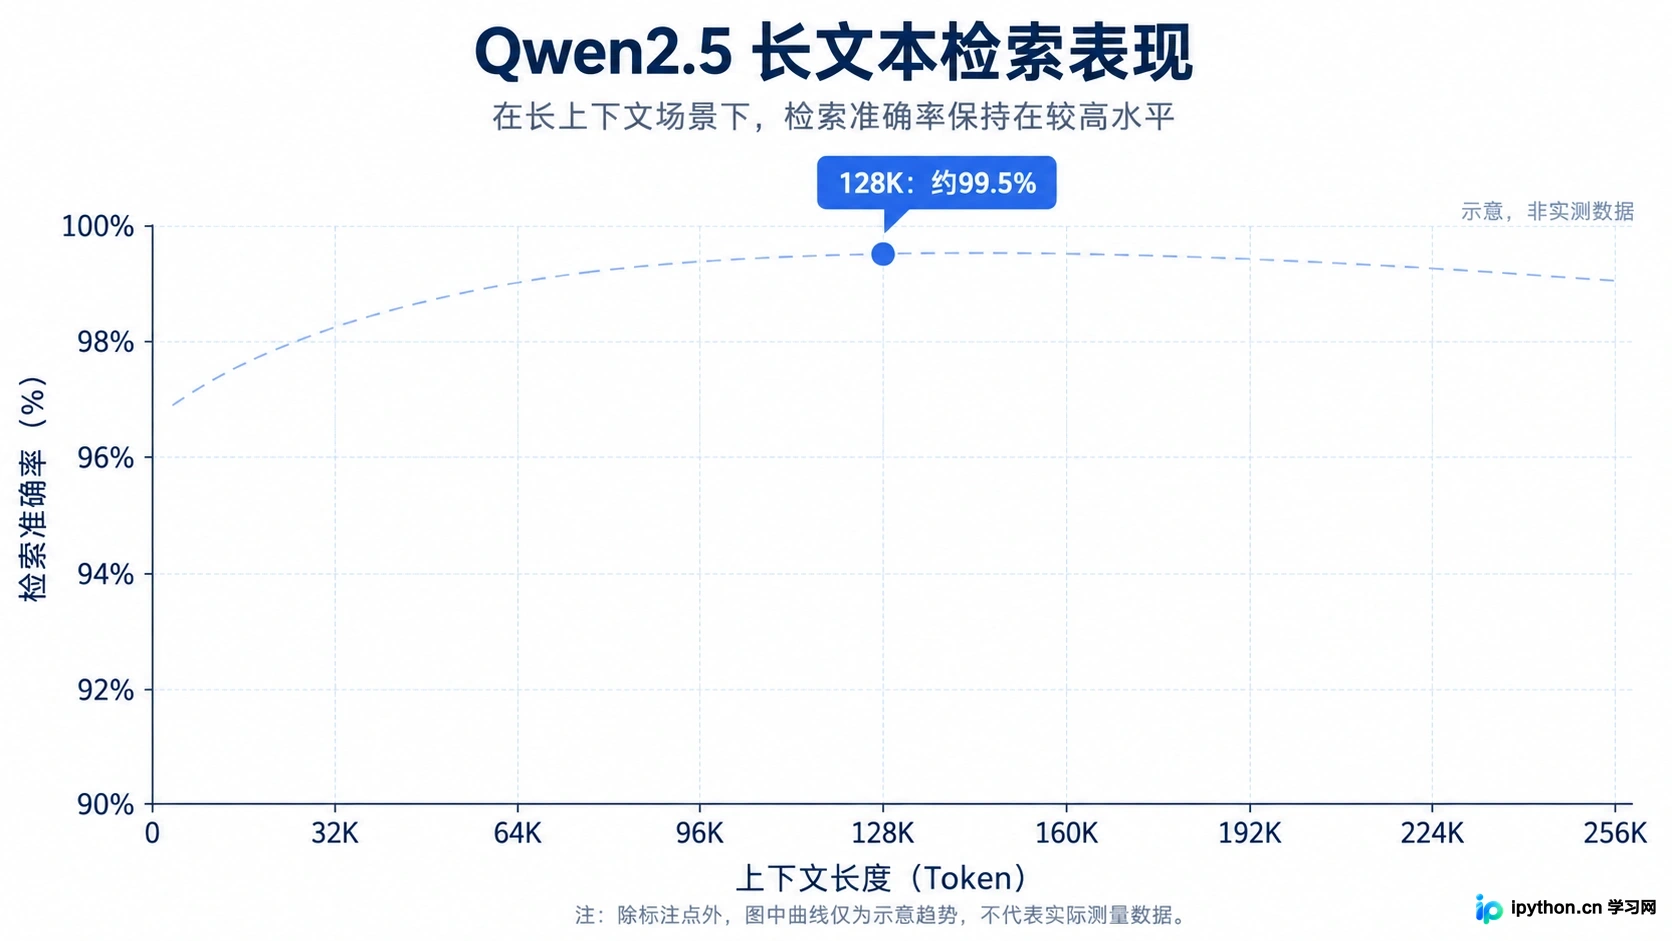
Qwen2.5 在不同上下文长度下的检索准确率
3. 关键能力对比:大海捞针测试表现
“大海捞针”测试是衡量长文本模型真实能力的试金石。该测试将关键信息(针)随机插入不同长度的无关文本(草堆)中,检验模型能否准确找回。
| 模型名称 | 最大上下文 | 100K+ 检索准确率 | 多模态支持 | 典型应用场景 |
|---|---|---|---|---|
| Gemini 1.5 Pro | 1M - 2M | ~99.9% | 强 (视频/音频) | 超大规模档案分析、视频理解 |
| Claude 3.5 Sonnet | 200K | ~99.8% | 中 (图像) | 长代码重构、深度文学分析 |
| Qwen2.5 | 128K - 256K | ~99.5% | 中 (图像) | 中文法律文书、本地知识库 |
| Llama 3.1 | 128K | ~98.5% | 弱 | 私有化部署、通用长文摘要 |
从数据可见,当上下文超过 100K 时,模型的注意力机制面临巨大挑战。Gemini 和 Claude 凭借更先进的架构优化,在长尾位置的检索稳定性上领先。而开源模型如 Llama 3.1 和 Qwen2.5 则在 128K 范围内提供了极具竞争力的性能,适合对成本敏感的场景。
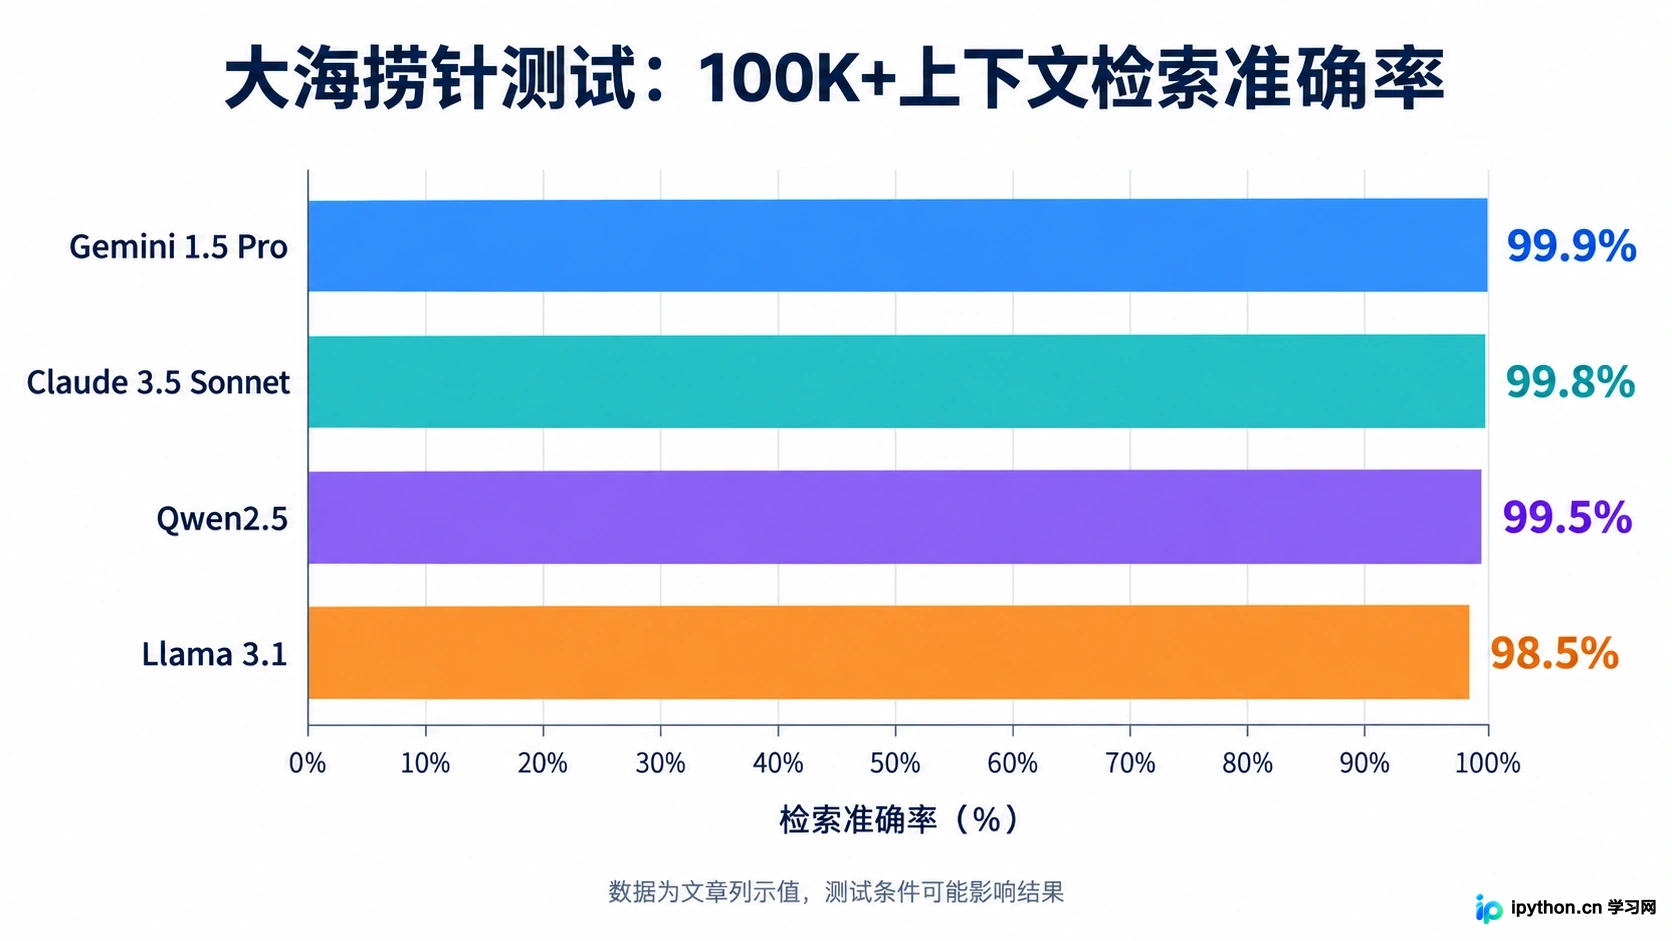
主流模型大海捞针测试准确率横向对比
4. 选型建议与注意事项
选择长文本模型时,不应盲目追求最大 Token 数,而应关注实际业务的有效窗口。
如果需处理单次输入超过 50 万字的材料,或涉及视频音频同步分析,Gemini 1.5 Pro 是目前无可替代的选择。其超长窗口能确保信息的绝对完整,避免分块处理带来的逻辑断裂。
若主要处理 20 万字以内的专业文档、代码库或长篇创作,Claude 3.5 Sonnet 提供了更好的指令遵循能力和细腻的文本生成质量,且 API 响应速度更快,成本更可控。
对于中文场景或需要私有化部署的企业,Qwen2.5 是最佳平衡点。它在中文语义理解上的深度优化,使其在处理本土化长文档时表现更佳,且支持灵活的本地微调。
最后需注意,长上下文意味着更高的计算开销和延迟。在实际应用中,建议先对文档进行初步清洗,去除无关的格式字符和冗余信息,以最大化有效 Token 的利用率。同时,即便模型支持百万级窗口,关键指令仍应放在输入的开头或结尾,以利用模型的“近因效应”提升执行准确率。
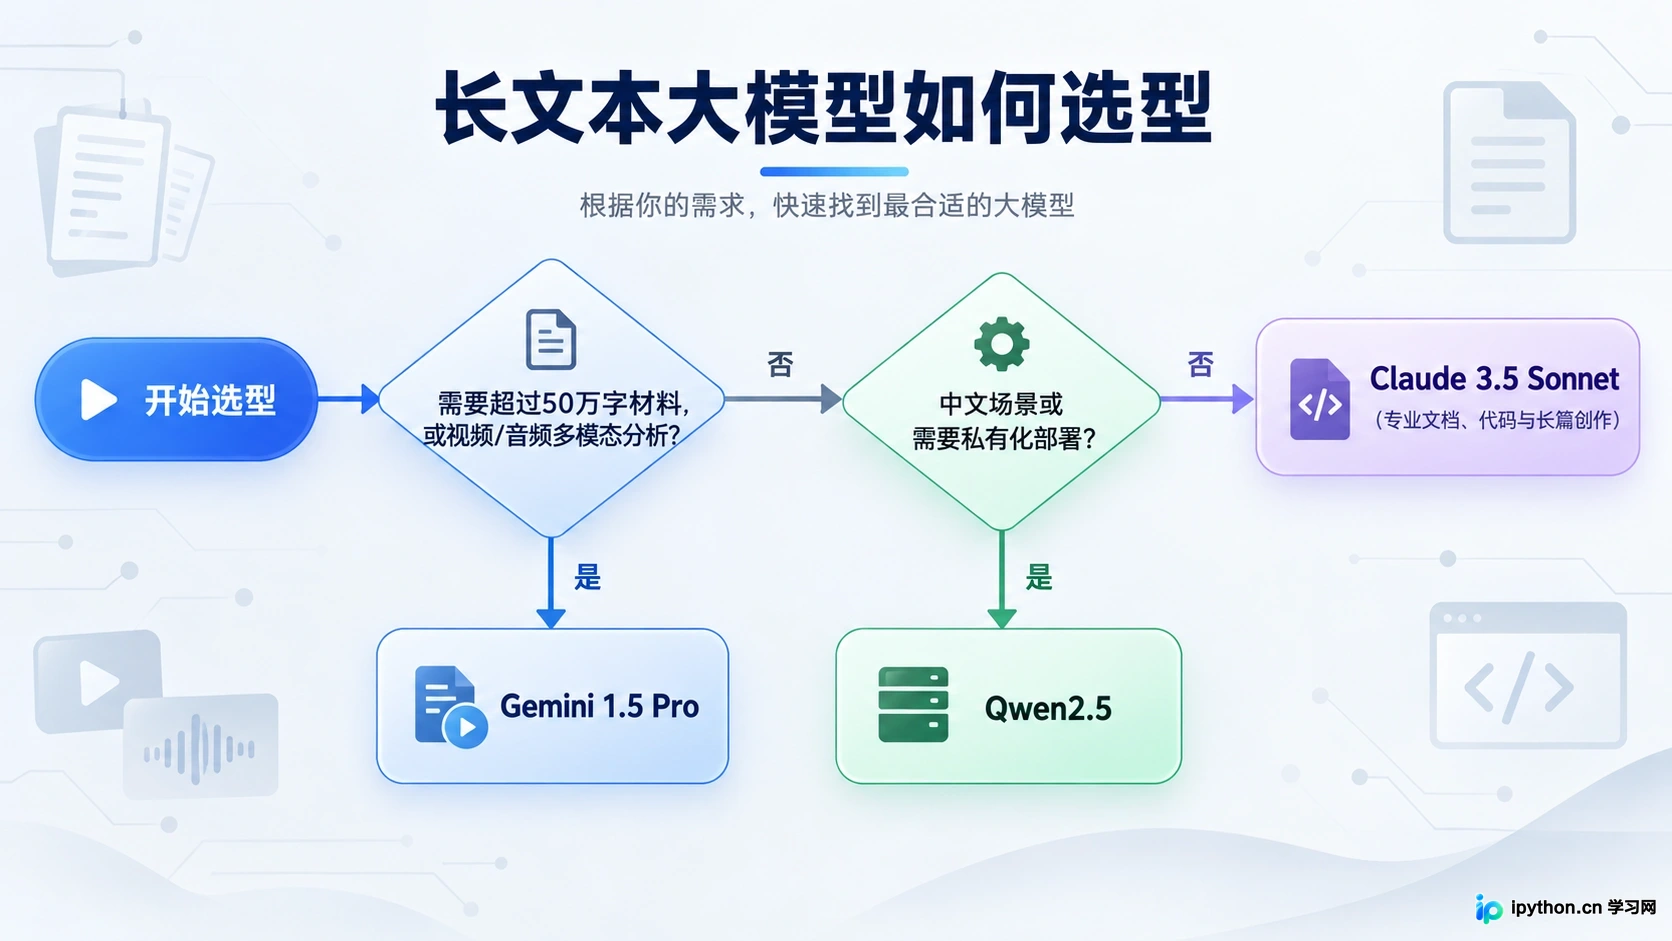
长文本大模型选型决策路径
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















