


Python实现TapTap游戏截图自动抓取教程

本文详细介绍如何利用Python编写爬虫程序,自动抓取TapTap平台上的游戏高清截图。通过解析搜索接口获取游戏ID,再调用详情API提取图片链接,最终实现批量下载保存。文中包含完整的代码示例及关键步骤解析,适合对网络爬虫感兴趣的开发者参考。
Python抓取TapTap游戏截图教程
本文介绍如何使用Python编写一个简单的爬虫程序,用于自动下载TapTap网站上的游戏截图。以下是具体的实现流程与代码细节。
获取游戏ID与截图链接
首先,在TapTap网站的搜索框中输入目标游戏名称,例如“原神”。
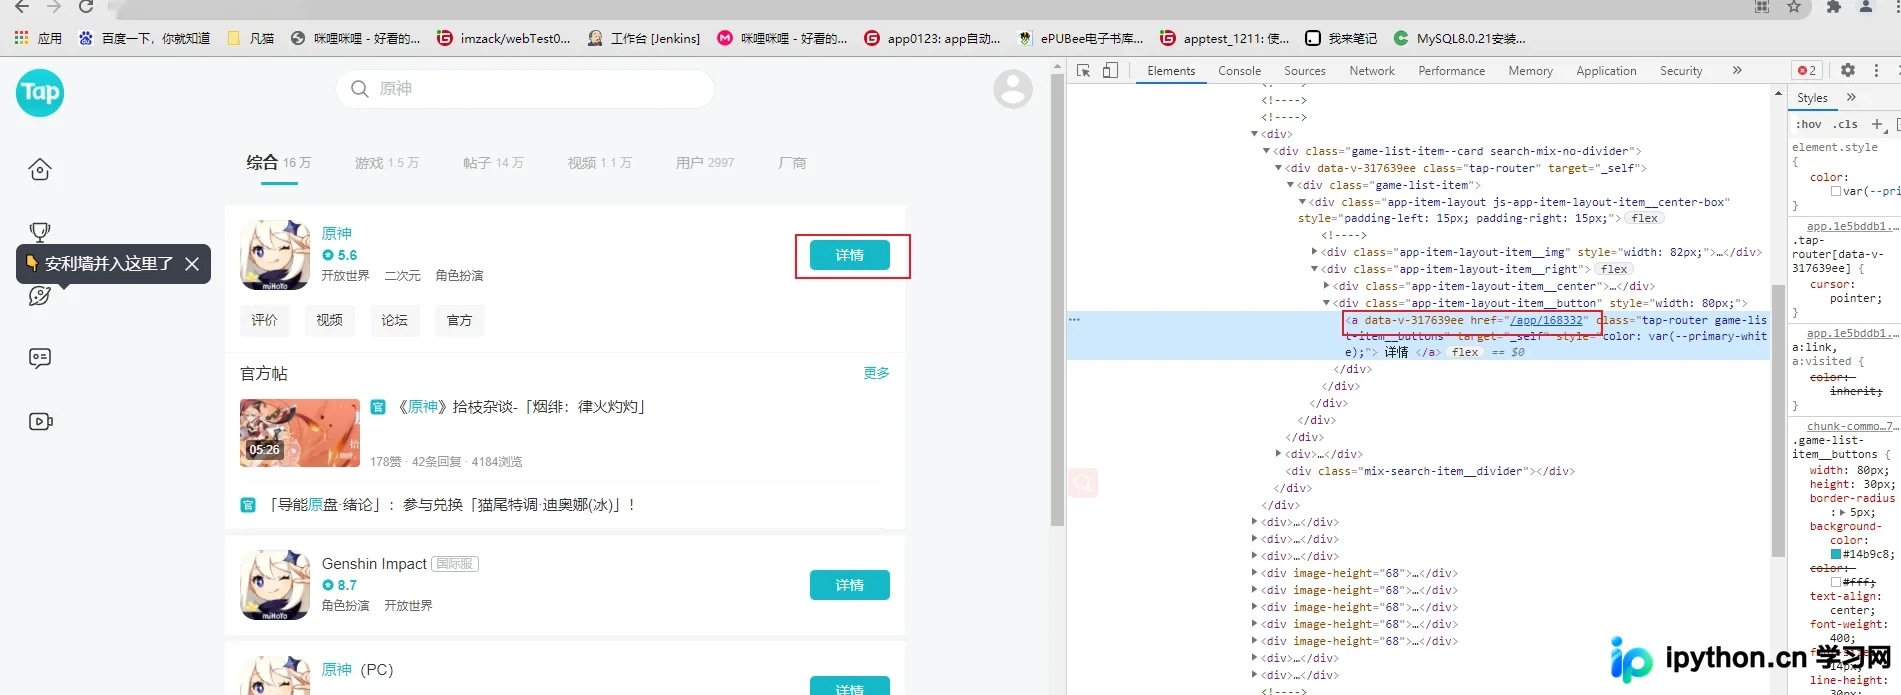
接着,打开浏览器的开发者工具(Developer Tools),点击“详情”按钮进入游戏页面。点击后页面会跳转至该游戏的专属详情页。
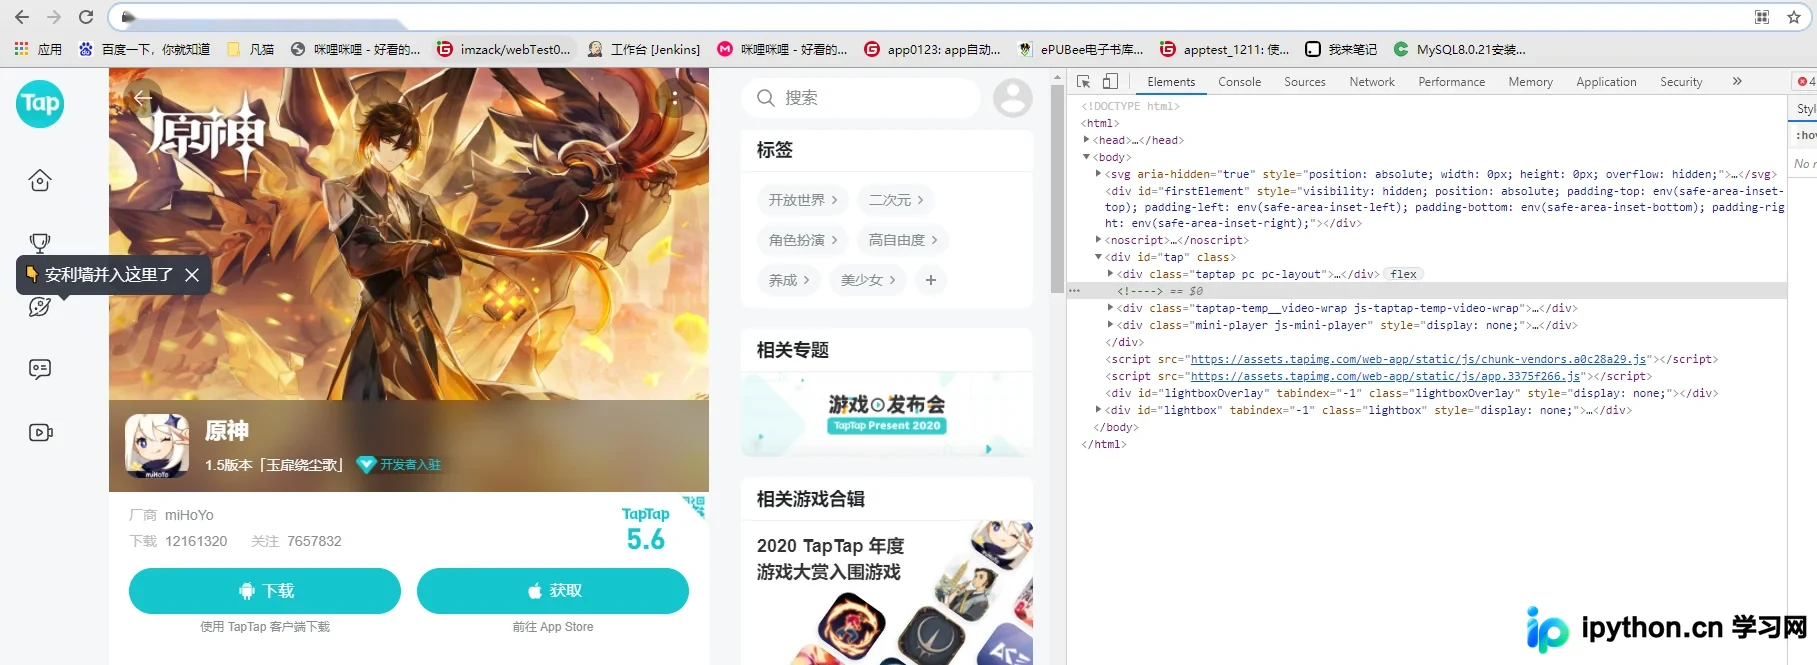
观察跳转后的浏览器地址栏,可以看到URL格式为:https://www.taptap.com/app/168332。其中,TapTap官网域名后跟随“app/”及该游戏的唯一ID。我们可以利用Python的re模块(正则表达式)从相关接口数据中提取出这个游戏ID。
x_ua = 'V=1&PN=WebApp&LANG=zh_CN&VN_CODE=4&VN=0.1.0&LOC=CN&PLT=PC&DS=Android&UID=97bb961f-bf03-4c7a-8cd7-8d6d8655d9c8&DT=PC'

def search(game_name):
    """根据游戏名搜索提取出游戏id"""
    url = 'https://www.taptap.com/webapiv2/mix-search/v1/by-keyword'
    data = {
        'kw': f'{game_name}',
        'X-UA' : x_ua
        # 'X-UA': 'V=1&PN=WebApp&LANG=zh_CN&VN_CODE=4&VN=0.1.0&LOC=CN&PLT=PC&DS=Android&UID=97bb961f-bf03-4c7a-8cd7-8d6d8655d9c8&DT=PC'
    }
    r = requests.get(url=url, params=data)

    pattern = re.compile('"type":"app","identification":"app:(.+?)"', re.S)
    r1 = pattern.findall(r.text)
    #从response中提取游戏id
    return r1[0]
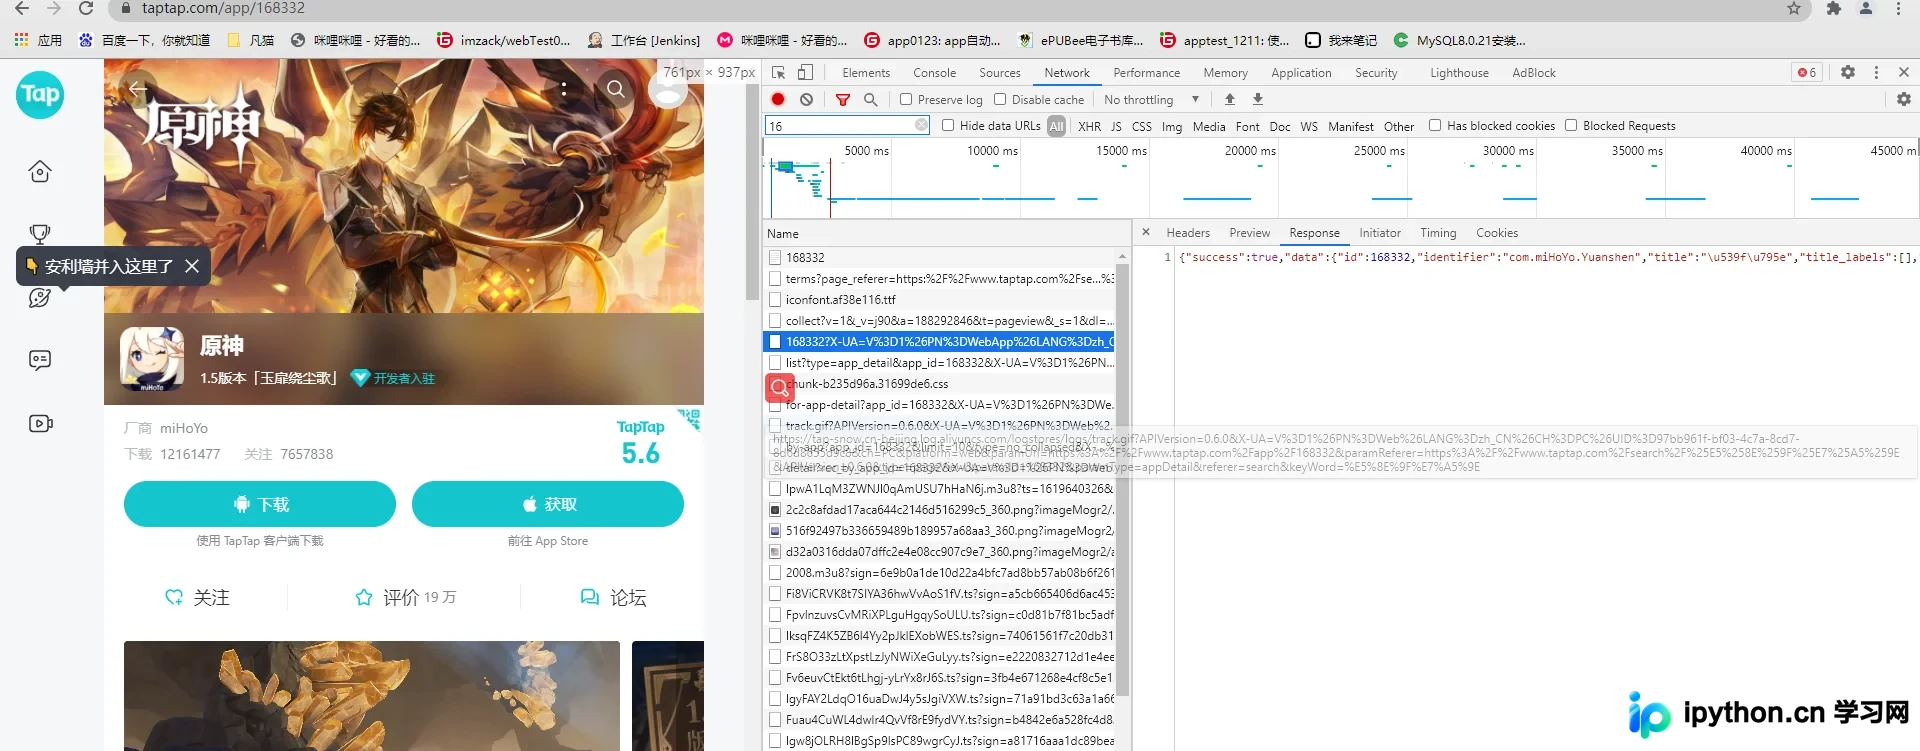
随后,在开发者工具中观察网络请求接口,可以发现通过特定接口能够获取到游戏截图的链接列表。
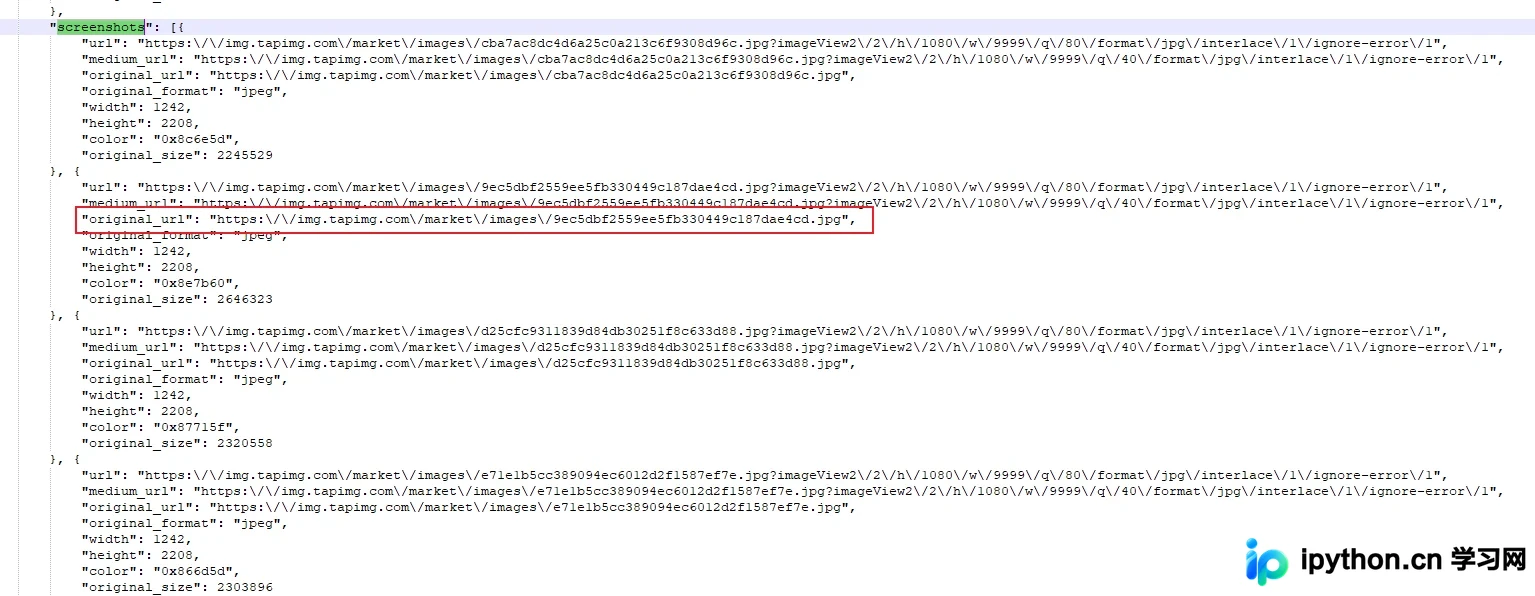
对返回的数据进行JSON格式化处理后,可以发现数据结构中“data”字段下的“screenshots”列表里,每个元素包含“original_url”键,其值即为截图的原始链接。使用json.load将响应内容转换为字典对象后,即可便捷地提取出这些图片URL。
   url = f'https://www.taptap.com/webapiv2/app/v2/detail-by-id/{search(game_name)}'
    r = requests.get(url=url, params={'X-UA': x_ua})
    data = json.loads(r.text)
    #转换为字典格式
    original_url = data.get('data').get('screenshots')
    #提取出截图url
本地保存截图实现
接下来,通过循环遍历提取到的图片链接,将每张图片下载并保存至本地指定目录。
for i in original_url:
            time.sleep(0.5)
            game_original_url = i.get('original_url')
            print(game_original_url, type(game_original_url))
            respones = requests.get(game_original_url)
            img = respones.content
            file_name = game_original_url[-36: -4]
            screenshots = os.path.join(os.path.dirname(__file__), f'screenshots/{game_name}')
            if not os.path.exists(screenshots):
                os.makedirs(screenshots)
            file_path = os.path.join(screenshots, file_name)
            with open(file_path + '.png', 'wb') as f:
                f.write(img)
完整代码示例
以下是实现上述功能的完整代码示例:
import os
import requests
import json
import re
import time

x_ua = 'V=1&PN=WebApp&LANG=zh_CN&VN_CODE=4&VN=0.1.0&LOC=CN&PLT=PC&DS=Android&UID=97bb961f-bf03-4c7a-8cd7-8d6d8655d9c8&DT=PC'

def search(game_name):
    """根据游戏名搜索提取出游戏id"""
    url = 'https://www.taptap.com/webapiv2/mix-search/v1/by-keyword'
    data = {
        'kw': f'{game_name}',
        'X-UA' : x_ua
        # 'X-UA': 'V=1&PN=WebApp&LANG=zh_CN&VN_CODE=4&VN=0.1.0&LOC=CN&PLT=PC&DS=Android&UID=97bb961f-bf03-4c7a-8cd7-8d6d8655d9c8&DT=PC'
    }
    r = requests.get(url=url, params=data)

    pattern = re.compile('"type":"app","identification":"app:(.+?)"', re.S)
    r1 = pattern.findall(r.text)
    #从response中提取游戏id
    return r1[0]

def download_screenshots(game_name):
    url = f'https://www.taptap.com/webapiv2/app/v2/detail-by-id/{search(game_name)}'
    r = requests.get(url=url, params={'X-UA': x_ua})
    data = json.loads(r.text)
    #转换为字典格式
    original_url = data.get('data').get('screenshots')
    #提取出截图url
    try:
        for i in original_url:
            time.sleep(0.5)
            game_original_url = i.get('original_url')
            print(game_original_url, type(game_original_url))
            respones = requests.get(game_original_url)
            img = respones.content
            file_name = game_original_url[-36: -4]
            screenshots = os.path.join(os.path.dirname(__file__), f'screenshots/{game_name}')
            if not os.path.exists(screenshots):
                os.makedirs(screenshots)
            file_path = os.path.join(screenshots, file_name)
            with open(file_path + '.png', 'wb') as f:
                f.write(img)

    except:
        print('下载失败')

if __name__ == '__main__':
    download_screenshots('lol')
以上即为使用Python爬取TapTap游戏截图的完整步骤与详细解析。如需获取更多相关技术资料,请持续关注本站发布的其他文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















