


Python爬虫实战:自动搜索并获取小说最新章节及最快访问网站

本文介绍如何使用Python爬虫技术,通过模拟百度搜索请求解析搜索结果页面,提取小说最新章节链接。程序结合访问耗时计算权重,自动筛选出更新最快且响应速度最优的前5个网站链接,解决手动查找小说更新慢、网站打开困难的问题,并提供完整代码实现与案例演示。
一、引言
今年五一假期自驾返回乡下老家,由于家中未安装宽带,只能依赖手机热点上网。期间发现4G信号质量不如以往,通过百度搜索小说最新更新时,打开相关网站速度缓慢,有时需要尝试多个网页才能找到可正常访问的最新更新内容。为了简化这一过程,作者决定利用Python爬虫技术开发一个简易工具,自动查找小说最新更新并访问响应最快的网站。经过对网络报文的深入研究及近一天的编码调试,该功能已实现,下文将详细介绍具体实施过程。
二、关于相关访问请求及应答报文
2.1、百度搜索请求
当我们在百度网页搜索框中输入关键词进行搜索时,系统提交的URL请求格式如下:
https://www.baidu.com/s?wd=搜索词&pn=10&rn=50请求的url为https://www.baidu.com/s,该请求包含三个关键参数:
- wd:代表用户输入的搜索关键词
- pn:用于指定当前页在总搜索结果中的起始序号。例如,若总共有300条相关记录,希望从第130条开始显示,则需将pn参数设置为130
- rn:定义每页显示的结果数量,默认值为10条。用户可自定义此数值,但若设定值超过50,系统会强制将其重置为每页10条。
2.2、百度返回搜索结果
百度返回的搜索结果格式多样,作者认为以下解析方式最为简便: 以搜索小说《青萍》为例,观察其中一条返回记录的结构:
<h3 class="t"><a data-click="{
			'F':'778317EA',
			'F1':'9D73F1E4',
			'F2':'4CA6DE6B',
			'F3':'54E5243F',
			'T':'1620130755',
			'y':'FE7FF57A'}"
			href="http://www.baidu.com/link?url=9LLa46B6hp69vJdLx6wOGfBpoS7BaRe8zV3oSNj_Vc2AxuU0Tz5Bl7CZlqNPobdw_BElAgaadA_HfCJMtADpyq" rel="external nofollow"  target="_blank">
			<em>青萍</em>最新章节,<em>青萍</em>免费阅读 - 大神小说网</a>
			</h3>
整个搜索结果项被包裹在h3标签内,具体的网站链接位于a标签中,并通过href属性指定。需要注意的是,此处返回的URL实际上是百度的重定向地址。通过访问该URL,可以获取响应消息中的最终目标网站地址。
2.3、小说网站关于最新更新的展现及html报文格式
经分析,约30%的小说网站展示最新章节的方式具有相似的结构,示例如下:
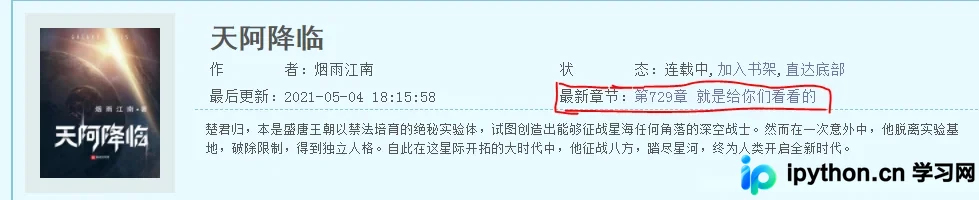
页面首先显示“最新章节”、“最新更新”或“最近更新”等提示文本,随后紧跟最新章节的章节序号及名称链接。对应的HTML报文结构大致如下:
<p>最新章节:<a href="/book/12/12938/358787.html" rel="external nofollow" target="_blank">第729章 就是给你们看看的</a></p>该报文的主要特征包括:
“最新章节”文本与最新章节链接位于同一个父标签内。此外,返回的章节URL并非绝对地址,而是相对于小说网站根目录的相对路径。
作者的程序正是基于上述格式特征来搜索小说并定位最新章节。因此,程序最终能成功获取的小说网站仅占整个搜索结果的大约30%。不过,对于阅读小说而言,这一覆盖率已足够使用。
三、实现思路及代码
3.1、根据url获取网站名
def getHostName(url):
    httpPost = url[10:]
    hostName = url[:10]+httpPost.split('/')[0]
    return hostName
3.2、根据百度返回搜索结果地址打开网站获取小说信息
基于2.3节所述的小说网站返回内容结构,程序通过百度搜索结果中的URL访问对应小说网站,并计算从发送请求到接收响应的耗时:
def getNoteInfo(url):
    """
    打开指定小说网页URL获取最新章节信息
    url:百度搜索结果指定的搜索匹配记录的url
    返回该URL对应的章节ID、打开耗时、网站真正URL、网站主机名、章节相对url、章节名

    """
    head = mkhead()
    start = time.time_ns()
    req = urllib.request.Request(url=url, headers=head)
    try:
        resp = urllib.request.urlopen(req,timeout=2)
        #根据响应头获取真正的网页URL对应的网站名
        hostName = getHostName(resp.url)
        text = resp.read()
        #网页编码有2种:utf-8和GBK
        pageText = text.decode('utf-8')
    except UnicodeDecodeError:
        pageText =  text.decode('GBK')
    except Exception as  e:
        errInf = f"打开网站 {url} 失败,异常原因:\n{e}\n" + '\n' + traceback.format_exc() + '\n'
        logPag(errInf, False)
        return None

    #最新章节的HTML报文类似: '<p>最新章节:<a href="/html/107018/122306672.html" rel="external nofollow" >第672章 天之关梁</a></p>'
    end = time.time_ns()
    soup = BeautifulSoup(pageText, 'lxml')
    # 根据最新章节的提示信息搜索最新章节
    result = soup.find_all(string=re.compile(r'最新更新[::]|最新章节[::]|最近更新[::]|最新[::]'))
    found = False
    for rec in result:
        recP = rec.parent
        pa = recP.a
        matchs = re.match(r'(?:最新更新|最新章节|最近更新|最新)[::]第(.+)章(.+)', recP.text)
        if not matchs:return None
        groups = matchs.groups()
        if matchs and pa is not None:
            found = True
            chapter = toInt(groups[0]) #章节序号
            chapterName = groups[1] #章节名
            chaperUrl = pa.attrs['href'] #章节相对URL
            break
    if not found:
        return None

    cost = (end - start) / 1000000  #网页打开耗时计算
    return (chapter,cost,resp.url,hostName,chaperUrl,chapterName)
注意:由于不同网站的响应情况存在差异,在打开网页时设置超时时间至关重要,这能有效避免因访问缓慢的网站而拖累整体处理速度。
3.3、获取小说网页绝对url地址
将响应信息中的相对URL与提取的网站主机名拼接,生成网页的绝对URL地址:
def getChapterUrl(noteInf):
    chapter, cost, url, hostName, chaperUrl, chapterName = noteInf
    if chaperUrl.strip().startswith('http'):return chaperUrl
    elif chaperUrl.strip().startswith('/'):return hostName.strip()+chaperUrl.strip()
    else:return hostName.strip()+'/'+chaperUrl.strip()
3.4、计算排序权重
根据访问小说网页获取的信息计算排序权重,确保最新章节排在前面,且在章节相同的情况下,访问速度最快的网站排名更靠前。
def noteWeight(n):
#入参n为小说信息元组: chapter, cost, url, hostName, chaperUrl, chapterName
    ch,co = n[:2]
    w = ch * 100000 + min(99999, 100000 / co)
    return w
3.5、进行百度搜索并解析搜索结果访问小说最新更新
根据搜索词在百度执行搜索,并提取最新章节且访问速度最快的前5个网站URL进行输出:
def BDSearchUsingChrome(inputword,maxCount=150):
    """
    输出相关搜索结果中具有最新章节且访问速度最快的前5个网站url
    :param word: 搜索关键词,如小说名、小说名+作者名等
    :param maxCount: 最多处理的搜索记录数
    :return: None
    """
    #百度请求url类似:https://www.baidu.com/s?wd=青萍&pn=10&rn=50
    rn = 50 #每页50条记录
    #构建请求头模拟本机谷歌浏览器访问百度网页
    head = mkheadByHostForChrome('baidu.com')
    word =  urllib.parse.quote(inputword)
    urlPagePre = 'https://www.baidu.com/s?wd='+word+'&rn=50&'
    pageCount = int(0.999+maxCount/rn)
    validNoteInf = []
    seq = 0
    logPag("开始执行搜索...")
    for page in range(pageCount):
        pn = rn*page
        urlPage = urlPagePre+str(pn)
        pageReq = urllib.request.Request(url=urlPage, headers=head)
        pageResp = urllib.request.urlopen(pageReq,timeout=2)
        pageText = pageResp.read().decode()

        if pageResp.status == 200:
            soup = BeautifulSoup(pageText,'lxml')
            links = soup.select('h3.t a[href^="http://www.baidu.com/link?url="]')

            for l in links:
                noteInf = getNoteInfo(l.attrs['href'])
                seq += 1
                if noteInf is None:
                    #print(seq,'、',l.attrs['href'],None)
                    logPag(f"{seq}、{l.attrs['href']}:查找最新章节失败,忽略",True)
                else:
                    logPag(f"{seq}、返回小说信息: {noteInf}",True)
                    #chapter,cost,url,hostName,chaperUrl,chapterName = noteInf
                    validNoteInf.append(noteInf)
    validNoteInf.sort(key=noteWeight,reverse=True)
    print(f"小说: {inputword} 最新更新访问最快的5个网站是:")
    for l in validNoteInf[:5]:#输出相关搜索结果中具有最新章节且访问速度最快的前5个网站url
        print(f"{validNoteInf.index(l)+1}、第{l[0]}章 {l[-1]}  {getChapterUrl(l)}  ,网页打开耗时 {l[1]} 毫秒")
    input("按回车键退出!")
四、搜索案例
以搜索月关大大的作品《青萍》为例,执行搜索的代码语句如下:
BDSearchUsingChrome('青萍月关',150)执行结果如下:
小说: 青萍月关 最新更新访问最快的5个网站是: 1、第688章 东边日出西边雨 http://www.huaxiaci.com/41620/37631250.html ,网页打开耗时 262.0 毫秒 2、第688章 东边日出西边雨 http://www.huaxiaci.com/41620/37631250.html ,网页打开耗时 278.0 毫秒 3、第688章 东边日出西边雨 http://www.huaxiaci.com/41620/37631250.html ,网页打开耗时 345.5 毫秒 4、第688章 东边日出西边雨 https://www.24kwx.com/book/9/9202/8889236.html ,网页打开耗时 774.0 毫秒 5、第688章 东边日出西边雨 https://www.27kk.net/9526/2658932.html ,网页打开耗时 800.5 毫秒 按回车键退出!
五、小结
本文介绍了使用Python搜索指定小说最新更新章节以及访问最快网站的实现思想和关键应用代码,实现了自动搜索小说最新更新章节以及获取访问最快的网站。以上的实现由于已经获取最新章节的链接,再稍微改进,就可以直接将最新章节下载到本地观看。
到此这篇关于Python爬虫之爬取最新更新的小说网站的文章就介绍到这了,更多相关Python爬取最新更新的小说网站内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















