


Python Pandas缺失值处理全指南:识别、删除与填充策略

本文详解Pandas中缺失值的处理流程,涵盖np.nan、None及自定义缺失值的识别方法。深入解析isnull、dropna与fillna函数的核心参数(如axis、how、thresh、method),提供删除与填充缺失值的最佳实践及注意事项,帮助开发者高效完成数据清洗。
前言
在数据处理的实际场景中,数据缺失是常见现象。本文将系统介绍如何利用Pandas库对数据中的缺失值进行有效处理。
一、什么是缺失值
从数据构成的角度来看,缺失值主要包含两类:一是Pandas内部定义的空值,二是用户自定义的缺失值表示。
1. Pandas内置空值类型:Pandas中主要存在三种空值表示:np.nan(Not a Number)、None以及pd.NaT(专门用于时间序列的空值,需注意大小写敏感)。这三种类型均可通过Pandas提供的isnull()、notnull()或isna()函数进行识别。
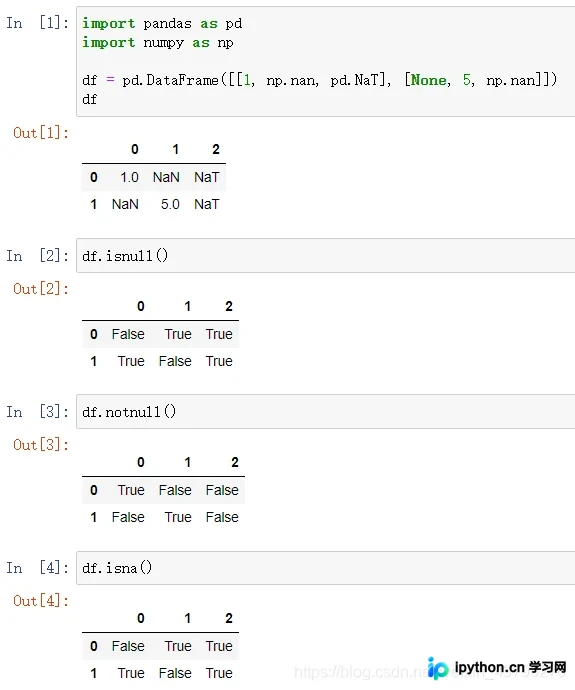
isnull()与notnull()的返回结果互为逻辑取反,而isnull()与isna()的功能及返回结果完全一致。在实际应用中,任选其一即可判断数据是否包含空值。若数据量庞大,建议结合NumPy库中的any()或all()函数进行批量判断。
需特别注意以下两个关键点:
- 若某列数据全部为空,且同时包含pd.NaT、np.nan和None,Pandas会自动将该列统一转换为pd.NaT类型。
- 空值(np.nan、None、pd.NaT)在概念上严格区别于空字符串""和空格字符串" ",二者不可混淆。
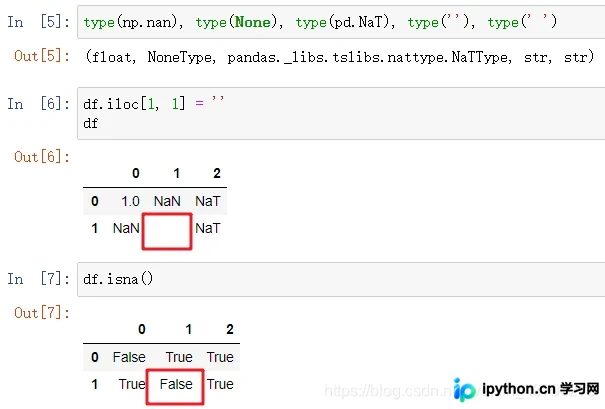
从Python解释器的类型视角来看,np.nan属于float类型,None属于NoneType类型,二者在Pandas中均显示为NaN;pd.NaT属于Pandas特有的NaTType,显示为NaT。相比之下,空字符串和空格的数据类型均为字符串(str),Pandas不会将其判定为空值。
2. 自定义缺失值:自定义缺失值的形式多样,例如前文提到的空字符串或空格(尽管因直观性较差,通常不推荐直接使用)。
在数据采集过程中,部分数据可能因获取失败或本身不存在而缺失。为便于记录,常使用特定符号(如问号?、斜杠/、字母NA等)来代表这些缺失值。
若数据由自行采集,通常已知缺失值的定义规则;若数据由他人提供,一般会附带数据说明文档,其中明确标注了缺失值的定义方式。
对于自定义缺失值,isnull()等内置函数无法直接识别,但可利用isin()函数进行判断。识别后,需将这些自定义值统一替换为np.nan,从而将数据中的缺失值统一转化为Pandas内置的空值类型,以便后续统一处理。
此外,在数据处理过程中,某些操作(如除以0、数字与空值运算等)也可能意外生成新的缺失值。
二、判断缺失值
1. 自定义缺失值的识别与替换
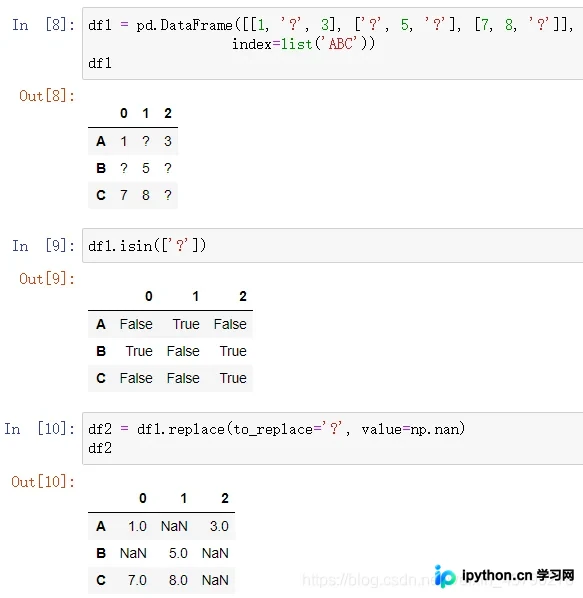
isin(values):用于判断Series或DataFrame中是否包含指定值,参数values可接受可迭代对象、Series、DataFrame或字典。判断自定义缺失值时,通常以列表形式传入目标值。
replace(to_replace=None, value=None):用于替换Series或DataFrame中的指定值。主要传入两个参数:to_replace指定被替换的值,value指定替换后的值。该函数支持Python基础类型(整型、字符串、列表、字典等)及正则表达式。
调用replace()时,默认返回原数据的一个副本,不修改原数据(inplace参数默认为False)。若将inplace设置为True,则直接修改原数据。其他高级参数此处略过,可根据实际需求查阅文档添加。
实际上,replace()函数可直接用于缺失值的填充处理,实现一步到位,无需先替换为np.nan再处理。当然,先统一替换为np.nan再统一处理也是可行的策略。
2. 空值判断
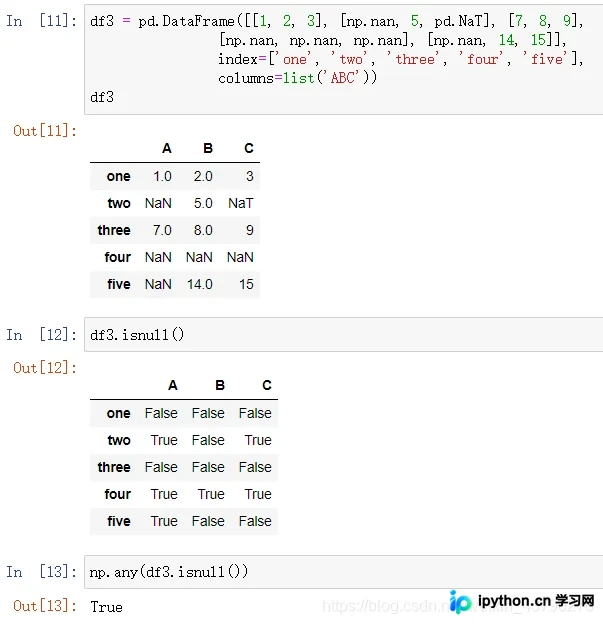
isnull():用于判断Series或DataFrame中是否包含空值,其结果与isna()相同,与notnull()相反。返回结果是一个与原数据形状一致的Series或DataFrame,包含布尔值。
当数据量较大时,肉眼观察布尔值结果效率低下。此时需借助NumPy库中的any()或all()函数,对判断结果进行进一步聚合分析,以快速确定是否存在空值。
三、删除缺失值
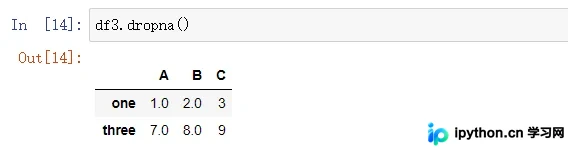
dropna(axis=0, how="any", thresh=None, subset=None, inplace=False):该函数用于删除Series或DataFrame中的空值。
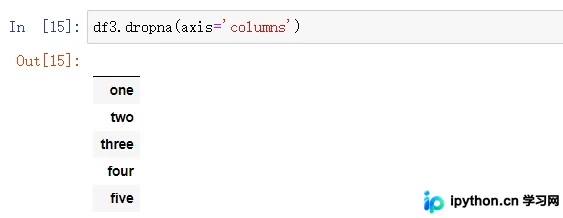
axis:默认为0(即'index'),表示按行删除,即删除包含空值的行。若将axis设为1或'columns',则按列删除,即删除包含空值的列。实际应用中,通常不建议按列删除,例如若某列代表年龄,仅因部分年龄缺失而删除整列数据,会导致大量有效信息丢失。
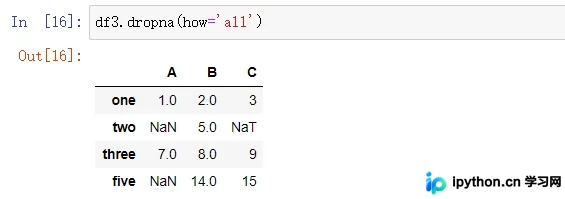
how:默认为'any',表示只要行(或列)中存在任意一个空值,即删除该行(或列)。若将how设为'all',则仅当行(或列)中所有值均为空值时,才执行删除操作。
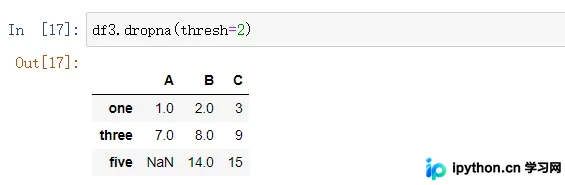
thresh:用于设定删除的阈值,需传入一个整数。若某行(或列)中非空值(non-NA values)的数量少于thresh,则删除该行(或列)。换言之,行(或列)中必须至少保留thresh个非空值,否则将被删除。
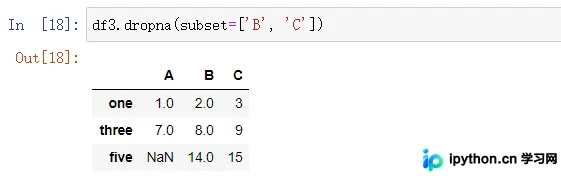
subset:指定在判断空值时仅考虑subset指定的列(或行)子集,其他列(或行)中的空值将被忽略。例如,按行删除时,subset可设为特定列的子集。
inplace:默认为False,返回原数据的一个副本。若设为True,则直接修改原数据。
删除缺失值必然导致数据量减少。若缺失值占比过高(例如超过10%,具体阈值视项目而定),直接删除数据可能对分析结果产生显著负面影响,此种做法通常不合理。
四、填充缺失值
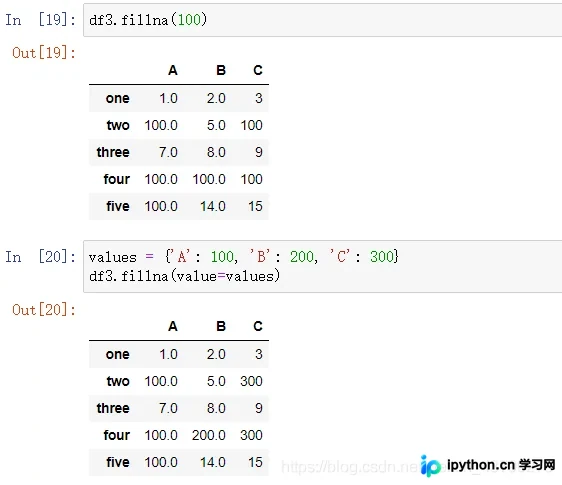
fillna(value=None, method=None, axis=None, inplace=False, limit=None):该函数用于填充Series或DataFrame中的空值。
value:指定填充的具体值,可以是标量、字典、Series或DataFrame。
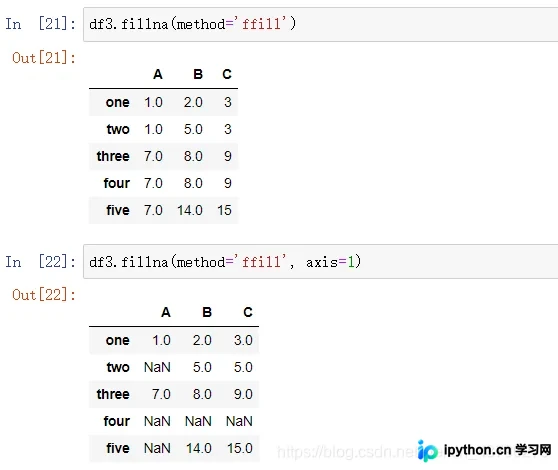
method:指定填充方式,默认为None。支持ffill、pad、bfill、backfill四种模式。ffill和pad表示使用前一个值填充:若axis=0,则用上一行的值填充;若axis=1,则用左侧的值填充。若空值位于第一行/列,或其前序值全为空值,则无法获取有效填充值,结果仍为空。bfill和backfill表示使用后一个值填充,axis用法及无有效填充值的情况与ffill/pad相同。
注意:当指定填充方式method时,不可同时指定填充值value,否则将引发报错。
axis:通常与method配合使用,axis=0表示按行操作,axis=1表示按列操作。
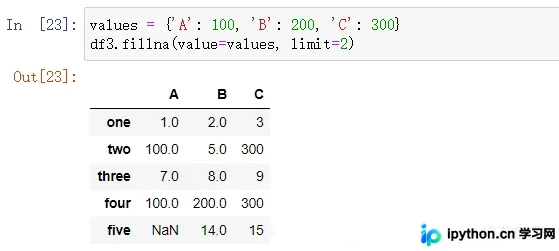
limit:指定填充执行的次数限制。按行填充时,每行填充一次计为一次执行;按列同理。
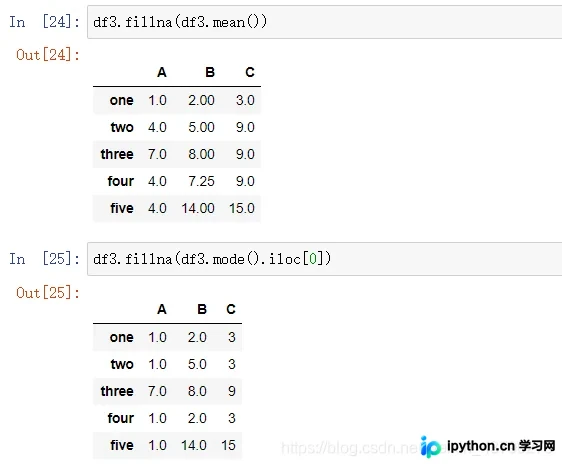
在缺失值填充时,若采用自定义值填充数值型数据,最常用的是均值和众数。DataFrame的众数本身也是一个DataFrame,且可能存在多个众数(极端情况下,若无重复值,众数即为原DataFrame)。因此,使用mode()函数求众数时,通常取第一行的值进行填充。
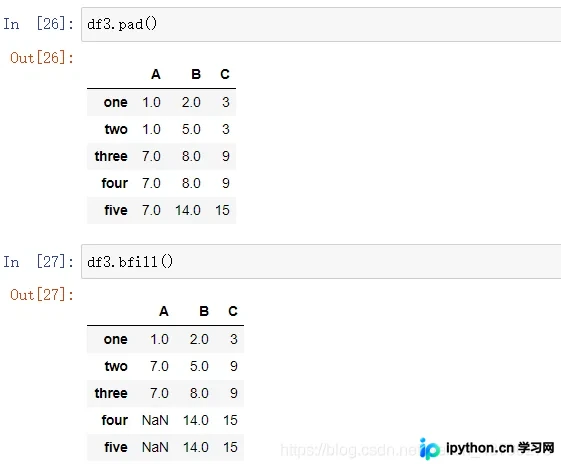
除在fillna()中传入method参数外,Pandas还提供了独立的填充函数,可直接调用以实现不同填充策略。
pad(axis=0, inplace=False, limit=None):使用前一个值进行填充。
ffill():功能同pad()。
bfill():使用后一个值进行填充。
backfill():功能同bfill()。
执行数据填充后,可能仍存在空值(例如使用ffill或pad时,若第一行即为空值)。对此情况,需在填充前进行人工预判,避免选择不适用的填充策略;并在填充完成后,再次检查数据中是否仍残留空值。
总结
至此,关于Python Pandas缺失值处理的核心内容已介绍完毕。如需了解更多Pandas缺失值处理技巧,建议查阅本站往期文章或继续关注后续更新。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















