


Python正则表达式re.search()基础用法详解

本文详细介绍Python中re.search()函数的基本用法。涵盖其三个核心参数:pattern、string及可选的flags标志位。通过多个代码示例演示如何匹配字符串、获取匹配位置span()、提取内容group(),以及使用re.I忽略大小写。同时讲解结合compile预编译提升效率的方法,并深入解析group()中数字索引与命名分组的使用区别。
1 re.search() 的作用:
re.search函数用于在整个字符串中进行搜索,并返回第一个成功的匹配对象。如果未找到匹配项,则返回None。
从源码实现来看,re.search()方法包含3个参数。
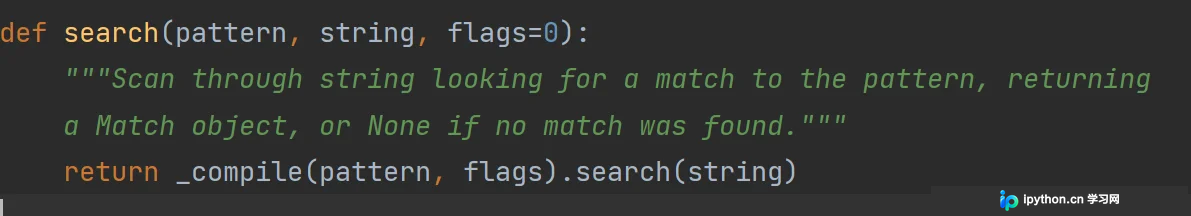
pattern:定义匹配的规则模式。
string:指定需要进行匹配的目标字符串。
flags:可选的标志位参数,用于控制匹配行为。例如,若需忽略字符大小写,可通过设置该标志位实现。
flags 的主要内容如下
flags:可选参数,用于指定匹配模式,如忽略大小写、多行模式等。具体可用参数如下:
- re.I:忽略大小写匹配。
- re.L:表示特殊字符集 \w, \W, \b, \B, \s, \S 依赖于当前环境。
- re.M:启用多行模式。
- re.S:使 . 匹配包括换行符在内的任意字符(默认情况下 . 不包括换行符)。
- re.U:表示特殊字符集 \w, \W, \b, \B, \d, \D, \s, \S 依赖于 Unicode 字符属性数据库。
- re.X:为了增加可读性,忽略空格和 # 后面的注释。
2 demo 练习re.search() 的使用
2.1 search 简单的匹配
import re

content = "abcabcabc"
rex = re.search("c", content)
print(rex)
打印结果如下
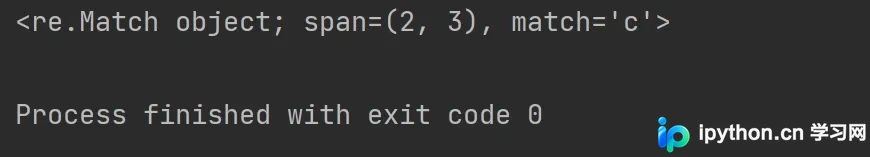
从输出内容可以看到 span(2, 3) 表示匹配成功的起始和结束下标,因此若想获取匹配位置的下标,可以使用 span 方法。
match 属性表示匹配的内容,此处内容为 c。
2.2 获取匹配的下标
import re

content = "abcabcabc"
rex = re.search("c", content)
print(rex.group())
打印结果如下
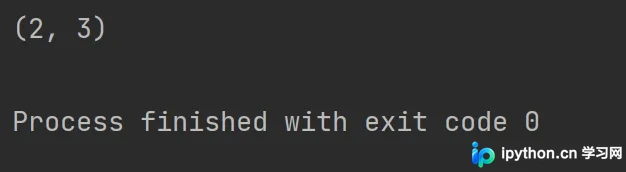
2.3 获取匹配的内容 ,使用group(匹配的整个表达式的字符串)
import re

content = "abcabcabc"
rex = re.search("c", content)
print(rex.group())
打印结果如下
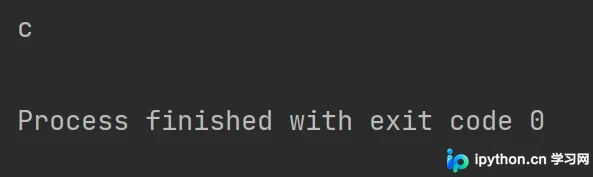
注意 group 和 span 不能同时使用,否则会报错。
2.4 使用标志位忽略匹配的大小写
import re

content = "abcabcabc"
rex = re.search("C", content, re.I)
print(rex.group())
打印结果如下
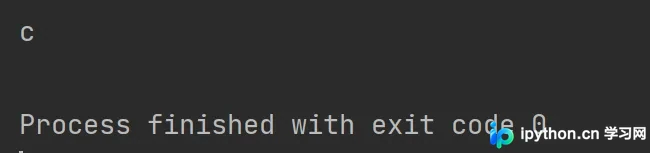
这里使用大写字母 C 并忽略大小写之后也能匹配到 c。
2.5 使用search 匹配字符串里面的数组
import re

content = "abc123abc"
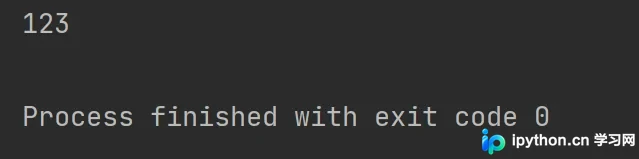
rex = re.search("\d+", content)
print(rex.group())
打印结果
2.6 search 结合compile 使用
import re

content = "abc123abc"
rex_content = re.compile("\d+")
rex = rex_content.search(content)
print(rex.group())
打印结果
2.7 group 的使用
import re

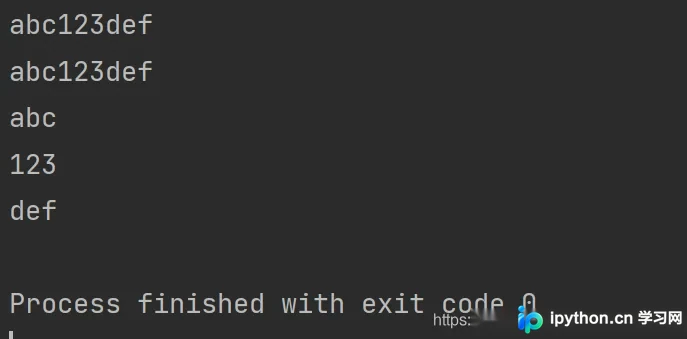
content = "abc123def"
rex_compile = re.compile("([a-z]*)([0-9]*)([a-z]*)")
rex = rex_compile.search(content)
print(rex.group())
print(rex.group(0))  # group()和group(0) 一样匹配的是整体
print(rex.group(1))  # 匹配第一个小括号的内容
print(rex.group(2))  # 匹配第二个小括号的内容
print(rex.group(3))  # 匹配第三个小括号的内容
打印结果
group() 小括号里面不止有数字,可以是自定的内容如下
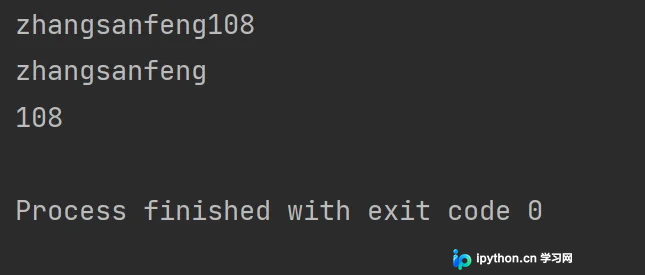
content = "zhangsanfeng108le"
rex_compile = re.compile("(?P<name>[a-z]*)(?P<age>[0-9]*)")
rex_content = rex_compile.search(content)
print(rex_content.group())
print(rex_content.group("name"))  # 这里效果等同于group(1)
print(rex_content.group("age"))  # 这里效果等同于group(2)
打印结果如下
总结
到此这篇关于python正则表达式re.search()基本使用的文章就介绍到这了,更多相关python正则表达式re.search()内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















