


Dify 知识库 RAG 配置:文档分段策略与嵌入模型选择技巧

明明把公司手册传进了 Dify 知识库,AI 却总是答非所问,或者干脆说“找不到相关信息”?这种挫败感在搭建 RAG(检索增强生成)应用时太常见了。很多时候,问题不在大模型本身,而在于你喂给它的“饲料”处理得不够精细。
在 Dify 中,知识库的核心就两步:怎么切分文档(分段),以及怎么理解文字(嵌入)。只要调整好这两个环节,检索准确率往往能有立竿见影的提升。
选对分段模式:别盲目相信“自动”
Dify 创建知识库时,默认推荐的是“自动分段与清洗”。这对大多数通用文档确实够用,系统会根据标点符号和段落结构智能切割。但如果你发现 AI 经常断章取义,或者把两个不相关的概念混在一起,就该试试“自定义分段”了。
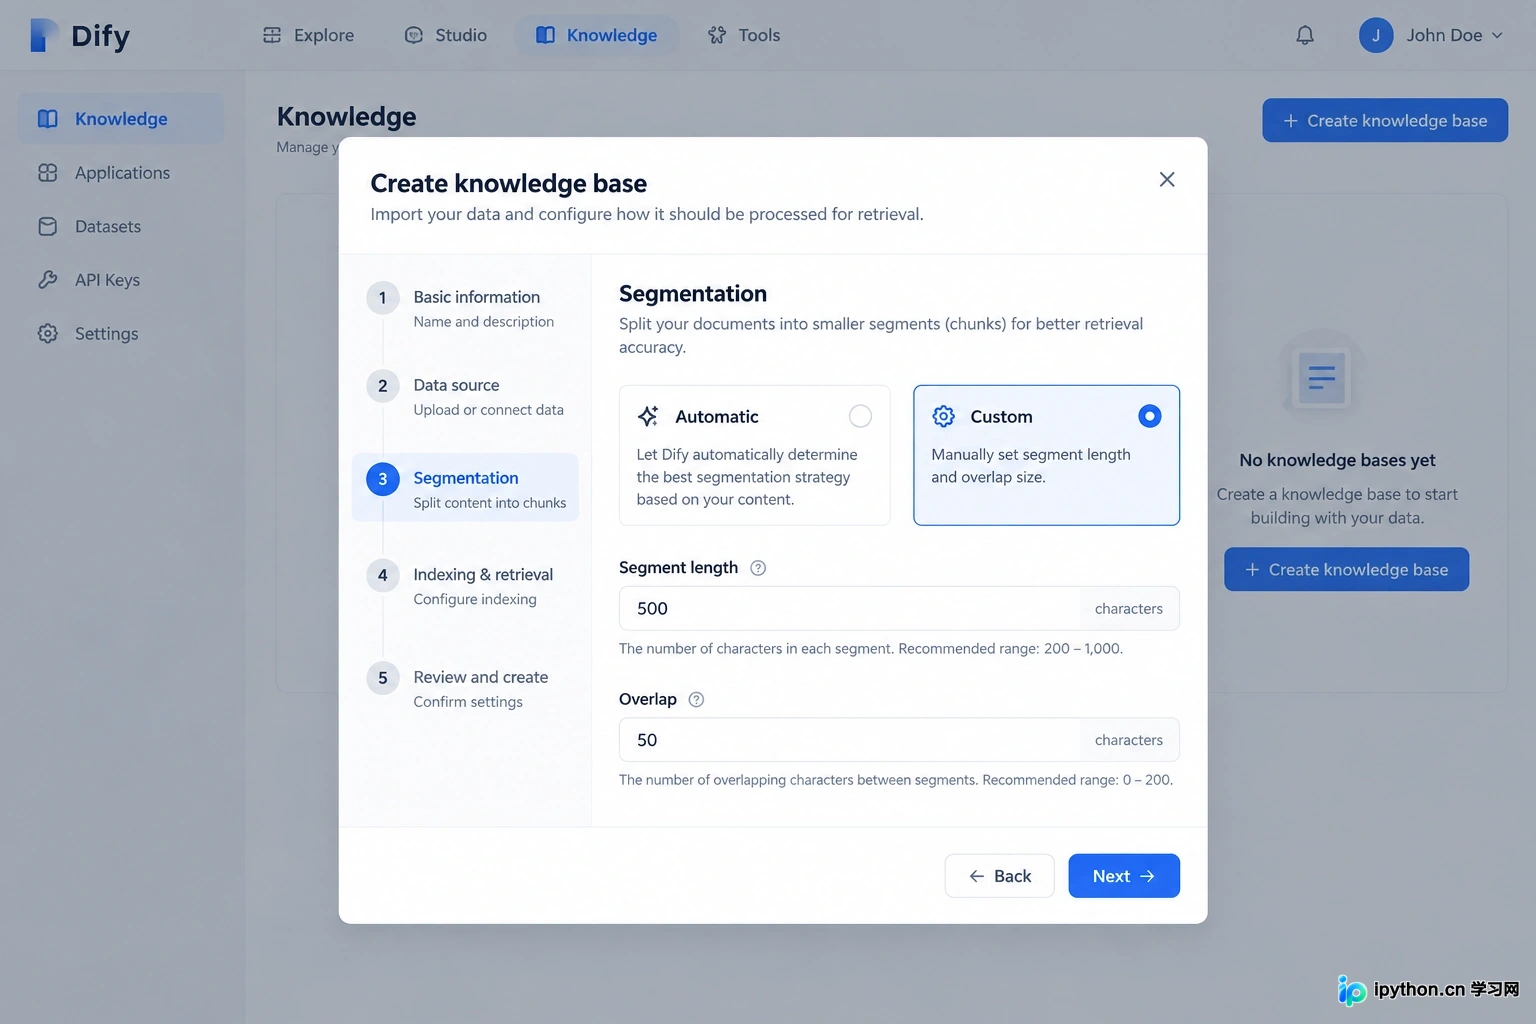
Dify 知识库分段模式选择:自动与自定义对比
自动分段适合结构松散的博客、新闻或日常对话记录。它的好处是省心,坏处是可能把一个完整的逻辑链条切断。比如一段代码解释,前半段在讲原理,后半段在讲报错,自动分段可能会把它们拆成两块,导致检索时只命中了一半信息。
对于技术文档、法律条款或操作手册,强烈建议使用“自定义分段”。你可以设置固定的字符长度(如 500-800 字符),并开启“重叠分段”。重叠是关键,它能让上一段的结尾和下一段的开头有部分内容重复,确保上下文连贯。这样即使检索命中了某一段的边缘,也能通过重叠部分找回丢失的语境。
另外,别忘了利用“分隔符”。如果你的文档是用 Markdown 写的,指定 ## 或 ### 作为分隔符,能让 Dify 更尊重你的标题层级,避免把不同章节的内容强行拼凑在一起。
嵌入模型:不是越贵越好,而是越匹配越好
分段决定了信息的颗粒度,而嵌入模型(Embedding Model)决定了系统如何理解这些信息的语义。在 Dify 的市场里,模型琳琅满目,很多新手容易陷入“选最贵的肯定没错”的误区。
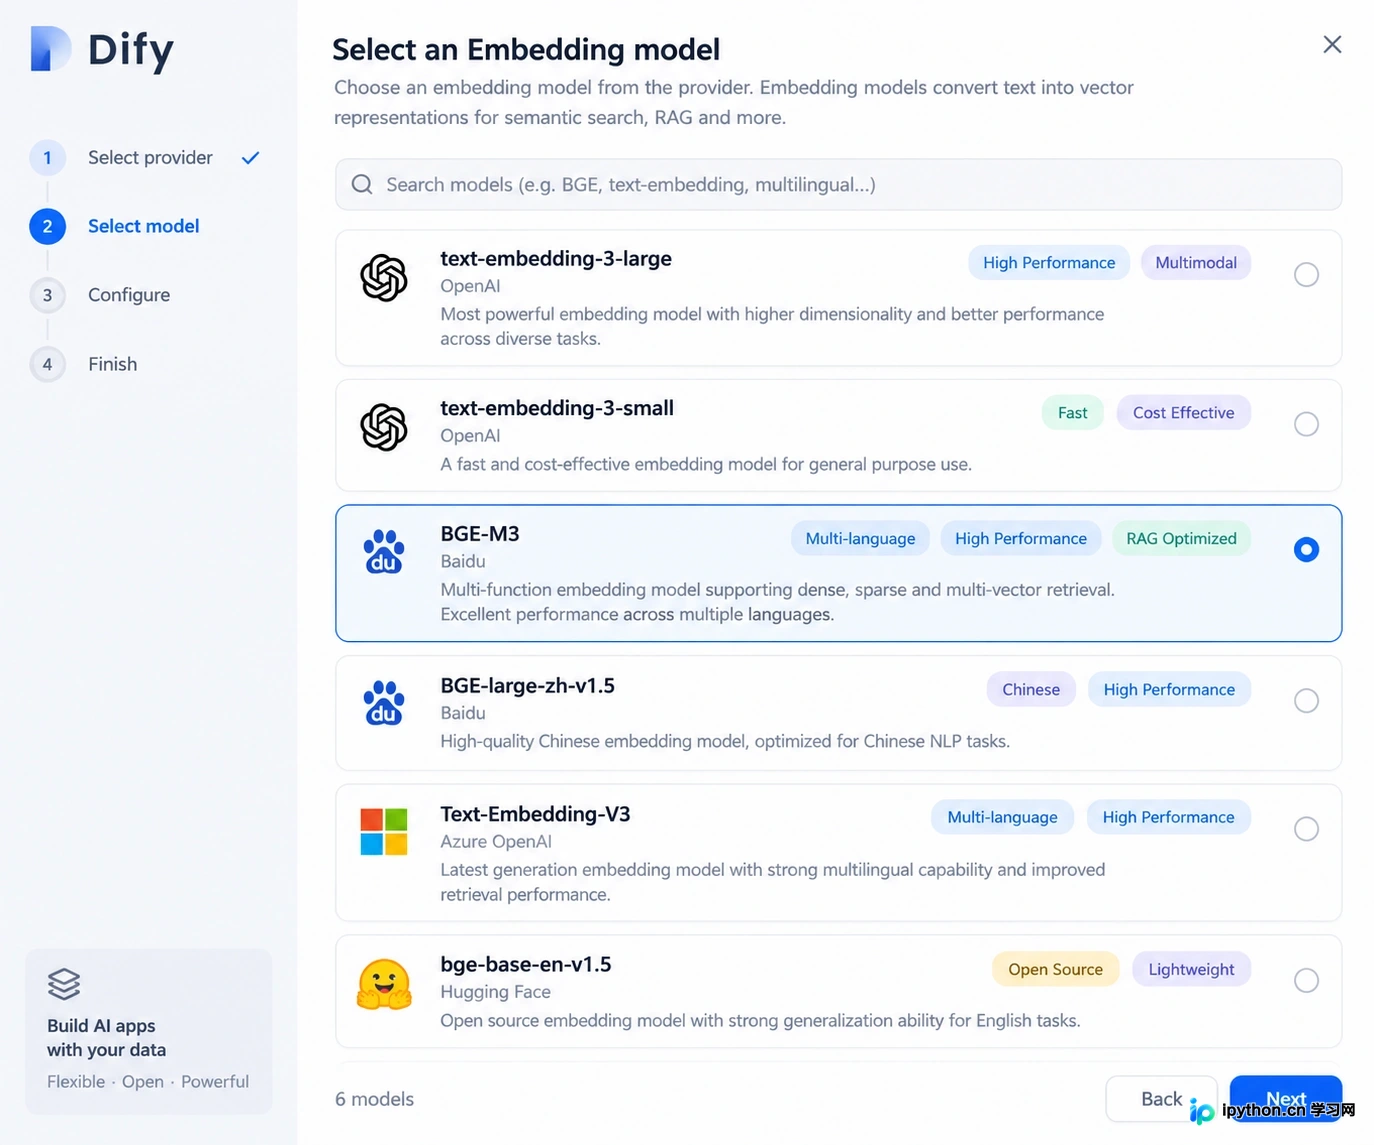
Dify 嵌入模型市场:多语言模型选择示意
实际上,嵌入模型的选择主要看两点:语言支持和维度匹配。如果你的知识库全是中文文档,却选了一个主要针对英文优化的模型,效果会大打折扣。目前,BGE-M3 或 Text-Embedding-V3 等支持多语言的模型在中文场景下表现相当稳健,且很多提供商都有免费额度或低成本方案。
还有一个容易被忽视的细节是索引方式。Dify 通常提供“高质量”和“经济”两种索引模式。高质量模式会使用向量索引,检索精度高,适合对准确性要求严苛的场景;经济模式则可能结合关键词检索,速度快但精度稍逊。对于初期测试,建议先用高质量模式跑通流程,确认是模型问题还是数据问题后,再考虑成本优化。
预处理:垃圾进,垃圾出
再好的算法也救不了脏数据。在上传文档前,花十分钟做一下清洁,比后期调参一小时都管用。
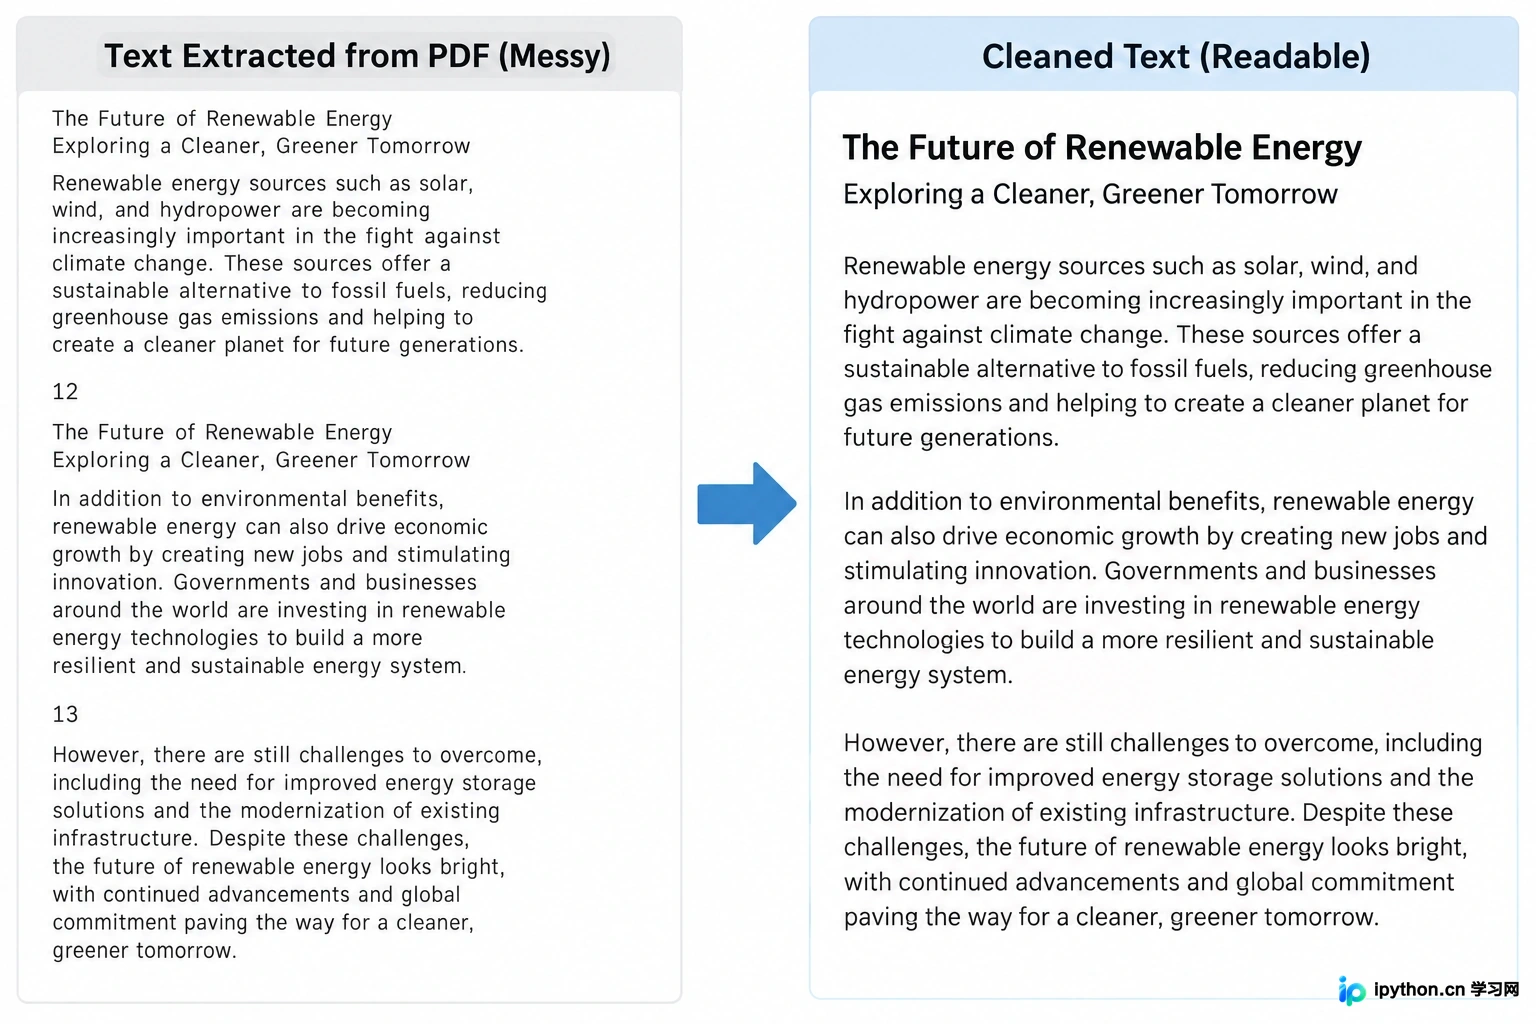
文档清洁:去除页眉页脚与无效符号
检查文档中是否有大量的页眉、页脚、页码或无意义的特殊符号。这些噪音会被嵌入模型当成有效信息处理,干扰向量空间的分布。特别是 PDF 转换来的文本,经常会出现断行错乱,建议在上传前用简单的文本编辑器批量替换掉多余的空行和乱码。
如果文档中包含表格,要注意 Dify 对表格的处理能力有限。复杂的嵌套表格最好转换成清晰的列表或自然语言描述,否则检索时很容易丢失行列对应的关系。
调试与迭代:看召回结果说话
配置完成后,不要急着发布。使用 Dify 知识库自带的“命中测试”功能,输入几个典型的用户问题,观察系统召回了哪些片段。
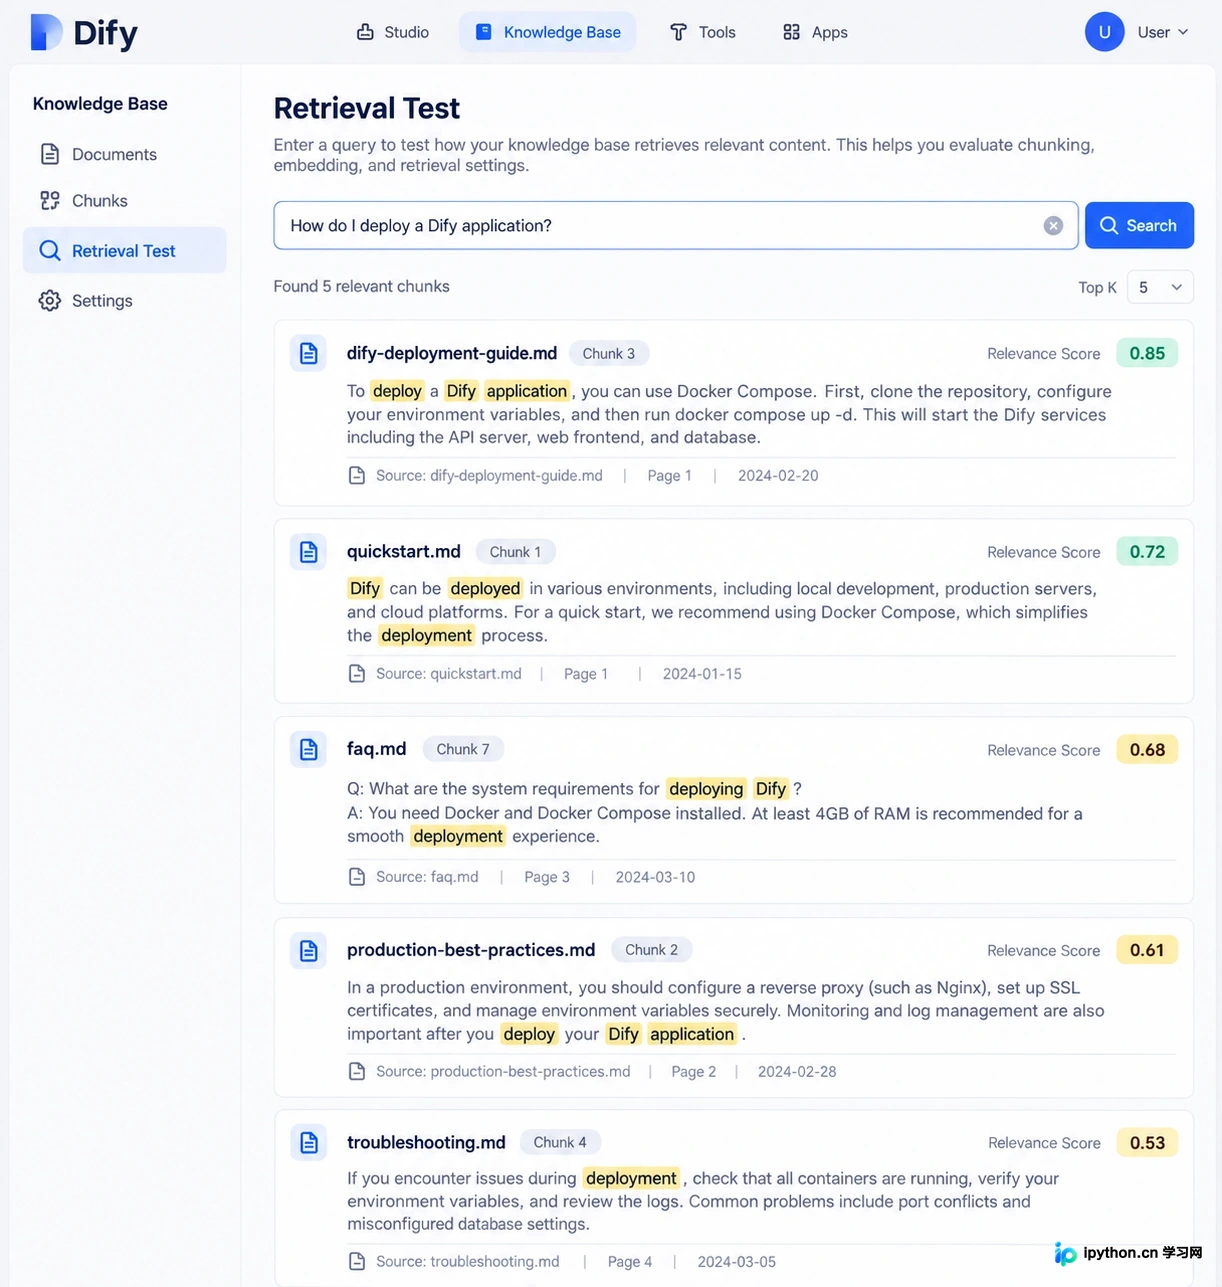
使用命中测试查看检索召回片段
如果召回的片段相关性低,说明嵌入模型可能不匹配,或者分段太碎导致语义缺失;如果召回了相关片段但 AI 回答依然错误,那可能是提示词(Prompt)的问题,或者是分段过长导致关键信息被淹没。这时候,回到分段设置,适当减小分段长度或增加重叠率,往往能解决问题。
RAG 优化是一个动态过程。随着业务数据的积累,定期回顾那些“回答失败”的案例,调整分段策略或更换更垂直领域的嵌入模型,才能让知识库真正变“聪明”。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















