


Dify知识库能否对接外部API实现动态更新

在构建基于大语言模型的应用时,静态上传的知识库往往面临数据滞后问题。通过对接外部API,可以让Dify应用实时获取最新业务数据、新闻或库存信息,确保回答的准确性与时效性。这种方案无需人工干预文件上传,适合需要高频更新内容的场景。
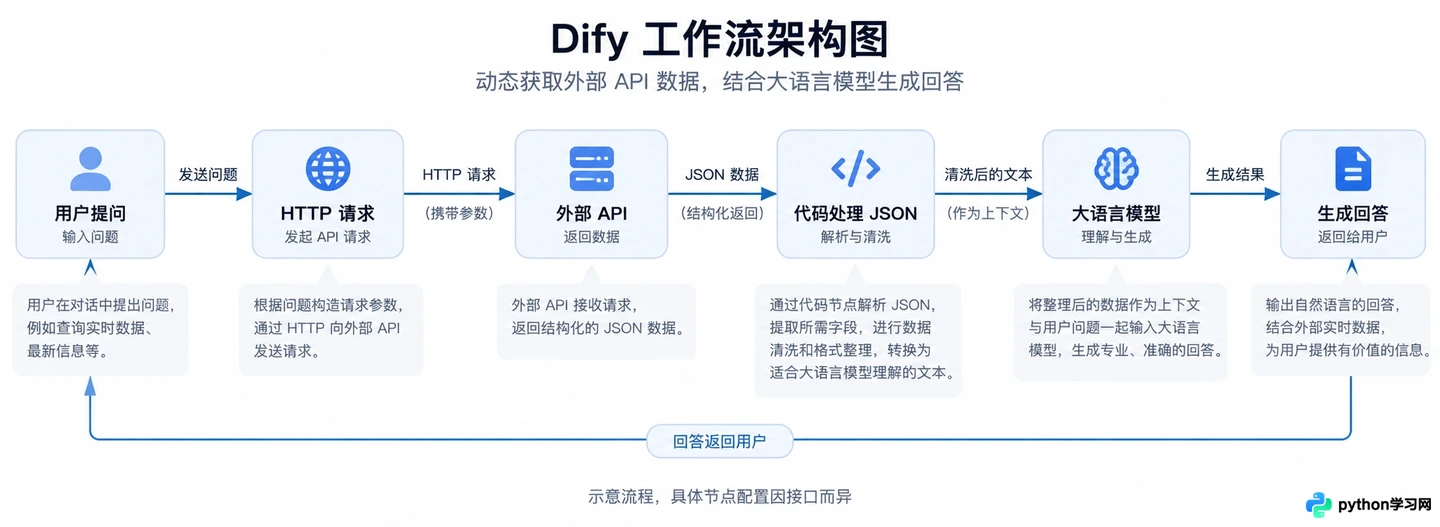
Dify工作流中HTTP请求与数据处理的基本架构示意
实现这一功能的核心逻辑并非直接“连接”数据库,而是利用Dify的工作流(Workflow)能力。首先通过HTTP请求节点从外部接口拉取数据,接着使用代码或文本处理节点清洗格式,最后将处理后的文本作为上下文传递给模型,或存入支持动态索引的知识库结构中。这里我们主要演示如何在工作流中实时拉取并注入API数据,这是目前最灵活且无需等待索引重建的动态更新方式。
开始前,请确保你拥有一个可公开访问或带有鉴权Token的外部API接口,以及一个已创建的Dify应用(建议选择工作流型应用以便更灵活地控制数据流向)。
- 创建HTTP请求节点获取数据
进入Dify应用编排页面,从左侧组件栏拖拽【HTTP请求】节点到画布中。该节点用于模拟后端服务向外部API发起调用。
在节点配置面板中,设置请求方法为GET(根据实际API要求选择POST等)。在URL字段填入你的API地址,例如 https://api.example.com/latest-news。如果API需要认证,点击【Headers】添加Authorization头,填入Bearer Token或其他鉴权信息。
关键步骤是测试连通性。点击节点下方的【运行】或【测试】按钮,观察右侧输出区域。若配置正确,你将看到原始的JSON响应数据。这一步验证了Dify能否成功触达外部数据源。
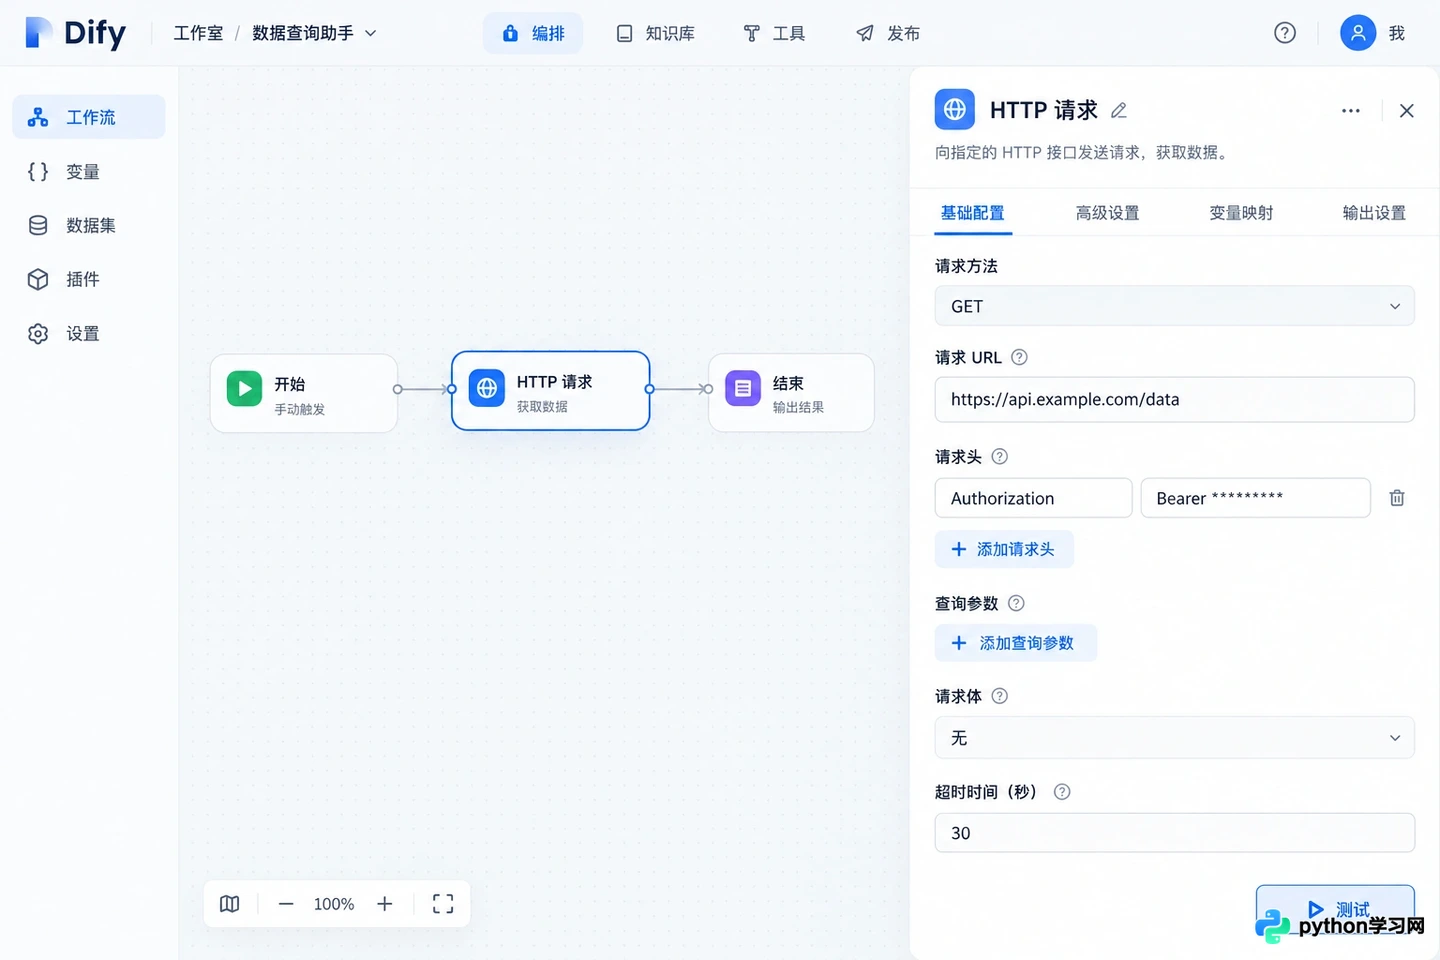
配置HTTP请求节点的URL和Headers参数
- 使用代码节点清洗与提取文本
API返回的通常是结构化JSON数据,而大模型更适合处理自然语言文本。因此,需要添加一个【代码】节点来提取关键字段。
拖拽【代码】节点连接到HTTP请求节点之后。在代码编辑器中,选择Python或JavaScript环境。以Python为例,输入以下逻辑:
def main(arg1: str) -> dict:
    import json
    # 假设arg1是HTTP节点输出的JSON字符串
    data = json.loads(arg1)
    # 提取标题和内容,拼接为自然语言文本
    items = data.get('items', [])
    text_list = []
    for item in items:
        text_list.append(f"标题:{item['title']}\n内容:{item['content']}")
    result_text = "\n\n".join(text_list)
    return {"cleaned_text": result_text}
在输入变量中,将HTTP节点的输出body映射给 arg1。运行测试后,检查输出结果是否为易读的纯文本格式。这一步确保了后续环节接收到的数据是干净、无冗余符号的。
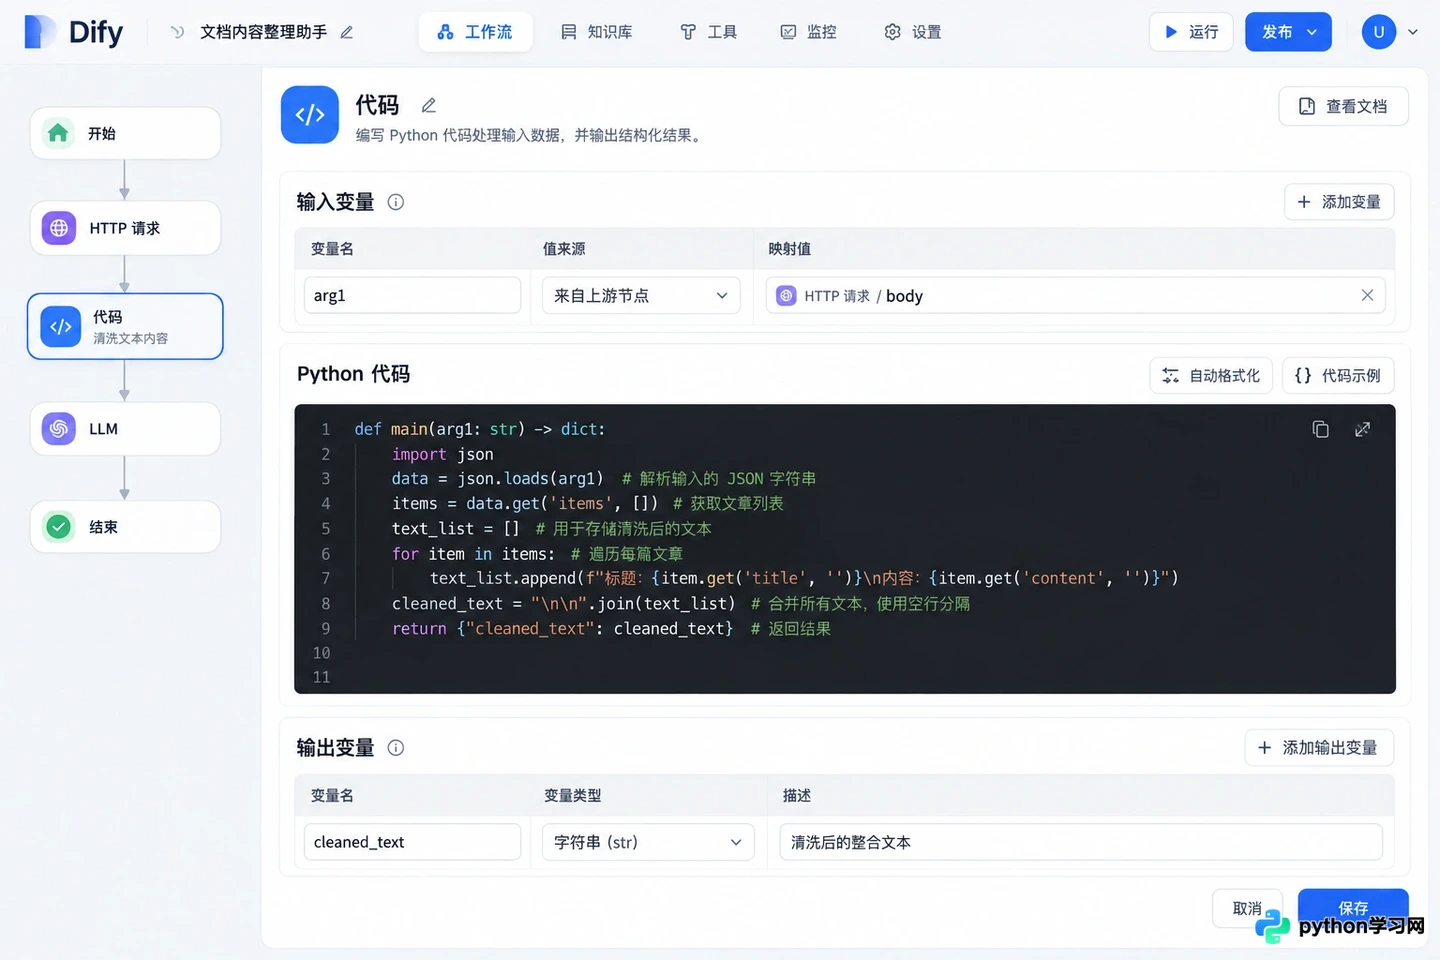
在代码节点中编写Python脚本提取JSON字段
- 将动态数据注入提示词或知识库检索
对于实时性要求极高的场景,推荐直接将清洗后的文本作为上下文注入提示词,而非存入传统静态知识库。这是因为传统知识库索引需要时间,而工作流中的变量是实时的。
在【LLM】节点中,打开上下文设置。选择【引用变量】,选中上一步代码节点输出的 cleaned_text。这样,每次用户提问时,系统都会先拉取最新API数据,再结合用户问题进行回答。
如果你必须使用知识库的向量检索功能(例如数据量极大),Dify目前支持通过API后台管理知识库文档。你可以编写一个外部脚本,定期调用Dify的Dataset API删除旧文档并上传新文档。但在工作流内部,上述“实时注入”方式是实现动态更新的最快路径。
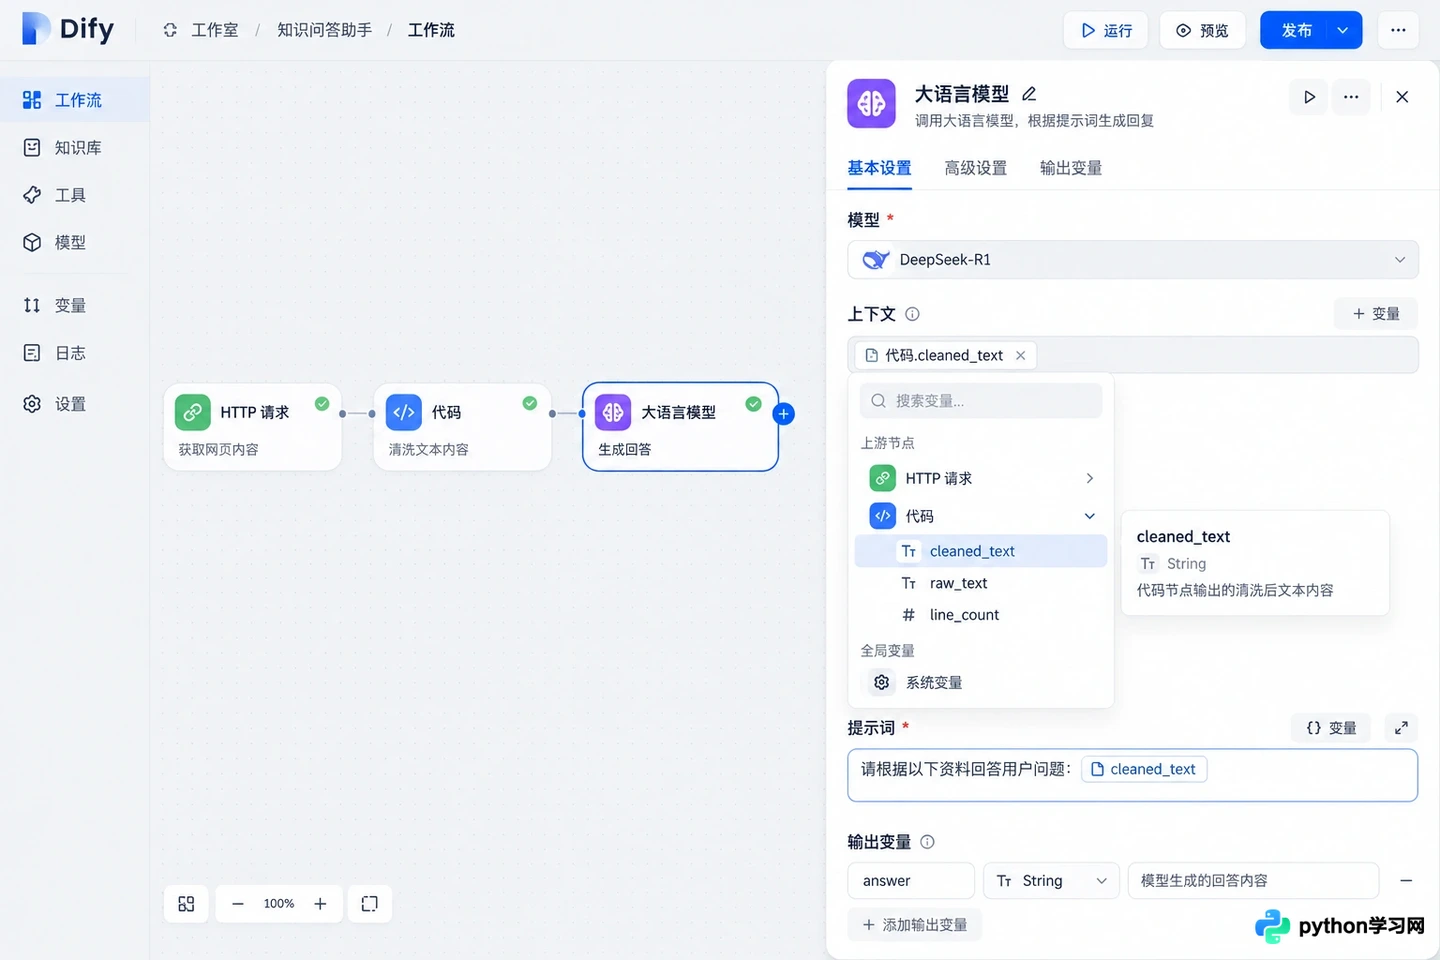
在LLM节点上下文中引用清洗后的文本变量
- 验证动态更新效果
完成编排后,点击右上角【发布】。在预览窗口输入与API数据相关的问题,例如询问最新的新闻标题或库存状态。
观察回答内容是否包含刚刚从API拉取的最新信息。为了验证动态性,你可以修改外部API的返回内容(或使用不同的测试接口),再次提问,确认Dify的回答随之变化,而不是依赖缓存或旧数据。
这种模式下,知识库的“更新”实际上是每次对话时的“实时获取”。只要API可用,数据就是最新的。保存当前工作流版本,以便后续迭代优化数据清洗逻辑。
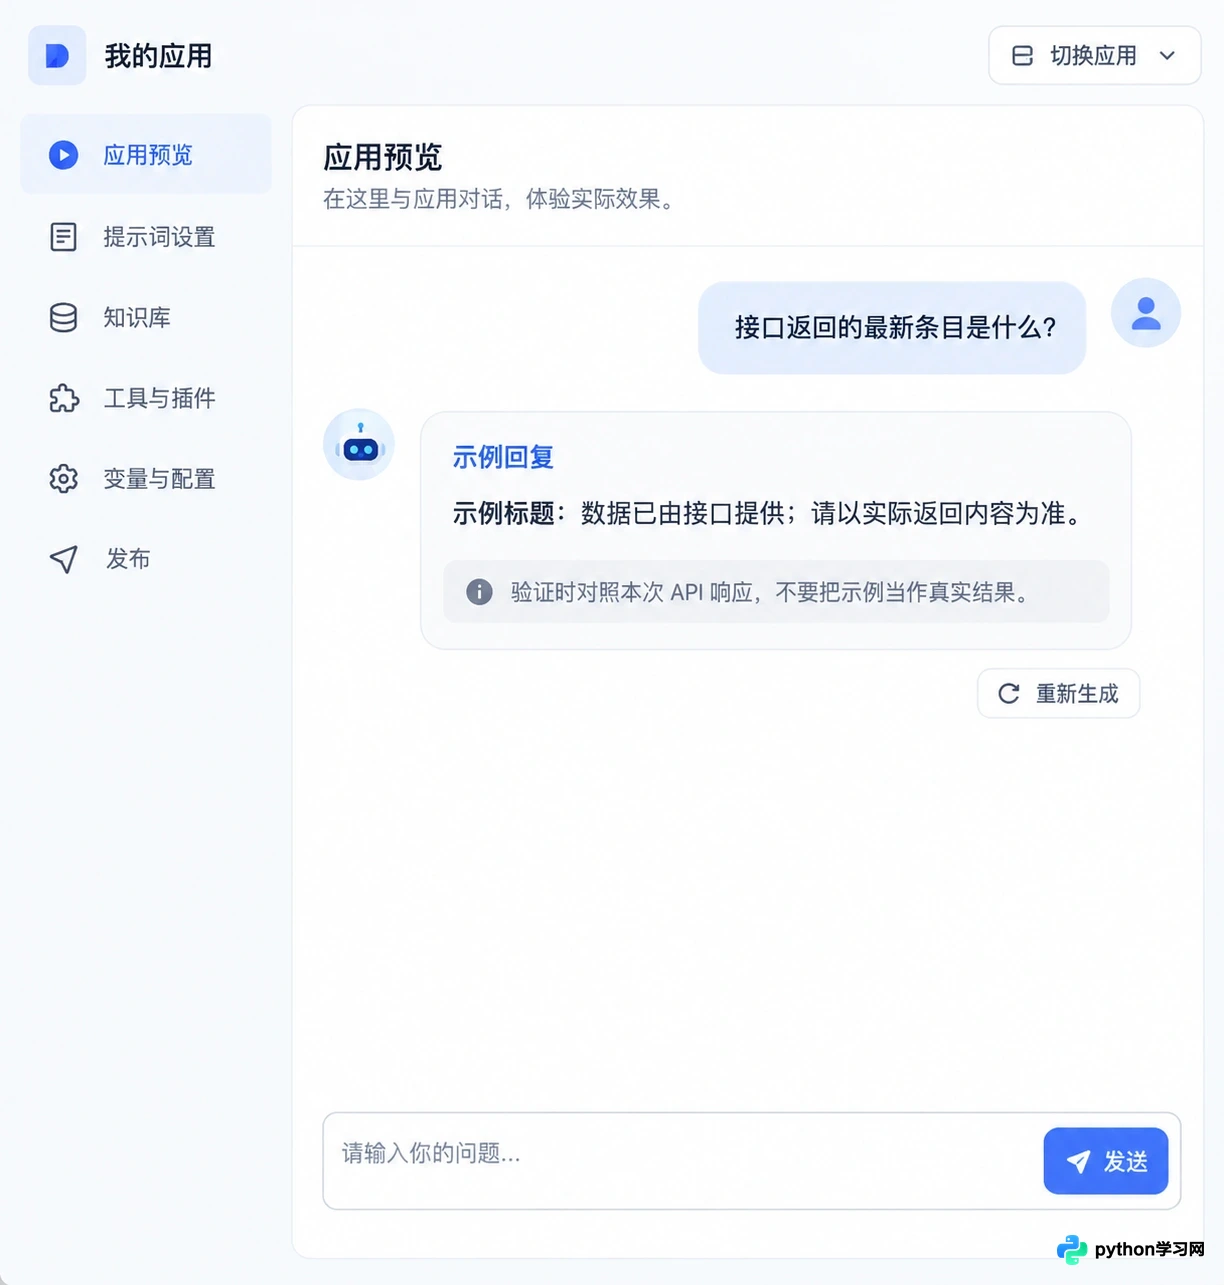
在预览窗口验证API数据是否实时更新
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















