


Python 中如何使用 KNNImputer 填充缺失值

本文介绍如何利用 scikit-learn 0.22 版本新增的 KNNImputer 类,通过 KNN 算法原理对数据集中的缺失值进行高效插补。文章通过简单示例和 Kaggle 皮马印第安人糖尿病数据集的实际案例,详细演示了从导入库、处理零值缺失、设置邻居数到最终填充的全过程,并指出该方法仅支持数值型特征。
查看以下代码实现。
# 加载库
import numpy as np
from fancyimpute import KNN
from sklearn.preprocessing import StandardScaler
from sklearn.datasets import make_blobs
# 创建模拟特征矩阵
features, _ = make_blobs(n_samples = 1000,
n_features = 2,
random_state = 1)
# 标准化特征
scaler = StandardScaler()
standardized_features = scaler.fit_transform(features)
standardized_features
# 制造缺失值
true_value = standardized_features[0,0]
standardized_features[0,0] = np.nan
standardized_features
# 预测
features_knn_imputed = KNN(k=5, verbose=0).fit_transform(standardized_features)
# features_knn_imputed = KNN(k=5, verbose=0).complete(standardized_features)
features_knn_imputed
# #对比真实值和预测值
print("真实值:", true_value)
print("预测值:", features_knn_imputed[0,0])
真实值: 0.8730186113995938
预测值: 1.0955332713113226
补充说明:scikit-learn 提供了一种便捷且可靠的缺失值填充方案,即 KNNImputer。
在数据挖掘任务中,处理样本中的缺失值是不可或缺的一环。选择恰当的缺失值插补方法至关重要,因为它会直接影响最终模型的拟合效果。
2019 年底,scikit-learn 发布了 0.22 版本。该版本不仅修复了部分旧 bug,还引入了多项新功能,使得数据挖掘工作更加便捷。其中,新增的 KNNImputer 是一个极为实用的缺失值插补工具。基于 KNN 算法原理,这种方法利用“近朱者赤”的思想,通过参考其他特征的分布情况来填充目标特征的缺失值,相比直接使用均值或中位数填充,其结果更为可靠。
接下来,通过实际案例展示 KNNImputer 的具体使用方法。
使用 KNNImputer 前,需从 scikit-learn 中导入该模块。
from sklearn.impute import KNNImputer首先通过一个小例子进行演示,数据集中第二个样本存在缺失值。
data = [[2, 4, 8], [3, np.nan, 7], [5, 8, 3], [4, 3, 8]]KNNImputer 的超参数设置与 KNN 算法一致,其中 n_neighbors 用于指定选取“邻居”样本的数量。我们先尝试设置 n_neighbors=1。
imputer = KNNImputer(n_neighbors=1)
imputer.fit_transform(data)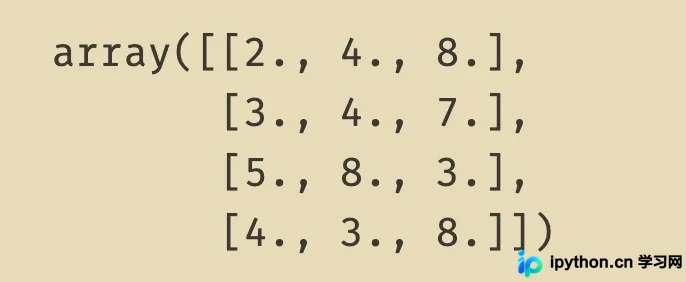
结果显示,由于第二个样本的第一列特征 3 和第三列特征 7,与第一行样本的第一列特征 2 和第三列特征 8 之间的欧氏距离最近,因此缺失值依据第一个样本进行填充,填充值为 4。那么,当 n_neighbors=2 时会发生什么?
imputer = KNNImputer(n_neighbors=2)
imputer.fit_transform(data)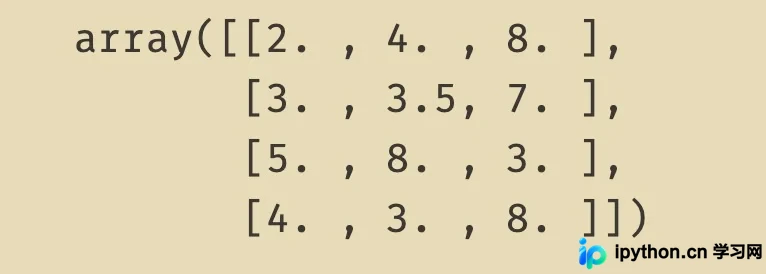
此时,根据欧氏距离计算出的最近邻居为第一行样本和第四行样本。填充值变为这两个样本第二列特征 4 和 3 的平均值,即 3.5。
接下来,我们查看一个实际案例。该数据集源自 Kaggle 上的皮马印第安人糖尿病预测分类赛题,其中包含大量缺失值,我们将尝试使用 KNNImputer 进行插补处理。
import numpy as np
import pandas as pd
import pandas_profiling as pp
import matplotlib.pyplot as plt
import seaborn as sns
sns.set(context="notebook", style="darkgrid")
import warnings
warnings.filterwarnings('ignore')
%matplotlib inline

from sklearn.impute import KNNImputer
#Loading the dataset
diabetes_data = pd.read_csv('pima-indians-diabetes.csv')
diabetes_data.columns = ['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness',
                       'Insulin', 'BMI', 'DiabetesPedigreeFunction', 'Age', 'Outcome']
diabetes_data.head()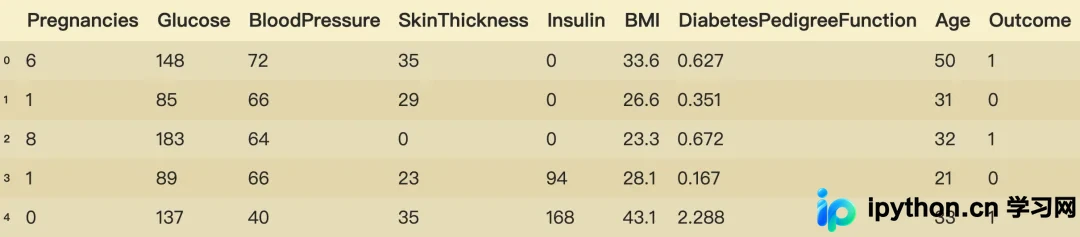
在该数据集中,0 值代表缺失值,因此我们需要先将 0 转换为 nan 值,然后再执行缺失值处理操作。
diabetes_data_copy = diabetes_data.copy(deep=True)
diabetes_data_copy[['Glucose','BloodPressure','SkinThickness','Insulin','BMI']] = diabetes_data_copy[['Glucose','BloodPressure','SkinThickness','Insulin','BMI']].replace(0, np.NaN)

print(diabetes_data_copy.isnull().sum())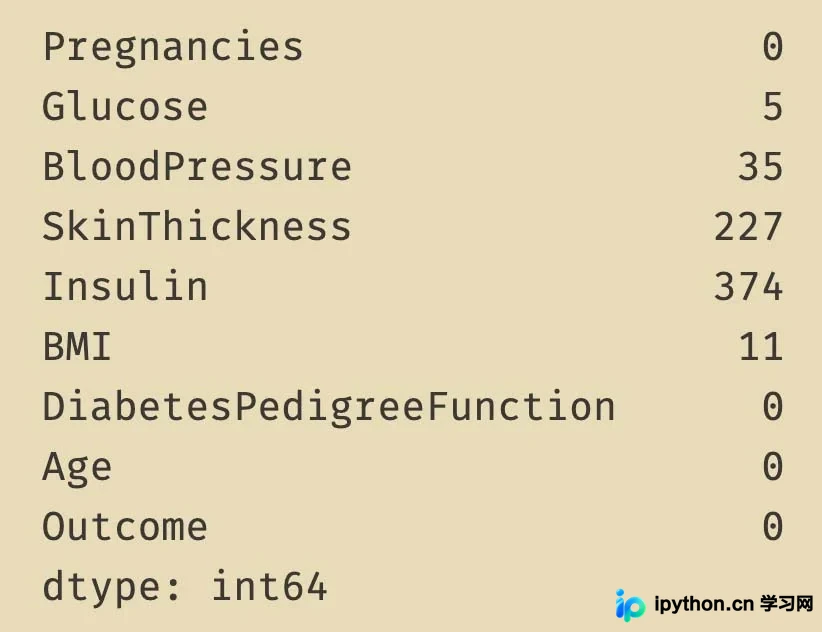
在本文中,我们尝试利用 DiabetesPedigreeFunction 和 Age 两个特征,对 BloodPressure 中的 35 个缺失值进行 KNNImputer 插补。
首先查看缺失值分布在哪些样本中。
null_index = diabetes_data_copy.loc[diabetes_data_copy['BloodPressure'].isnull(), :].index
null_index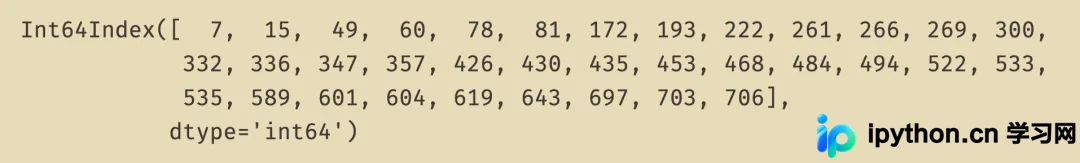
imputer = KNNImputer(n_neighbors=10)
diabetes_data_copy[['BloodPressure', 'DiabetesPedigreeFunction', 'Age']] = imputer.fit_transform(diabetes_data_copy[['BloodPressure', 'DiabetesPedigreeFunction', 'Age']])
print(diabetes_data_copy.isnull().sum())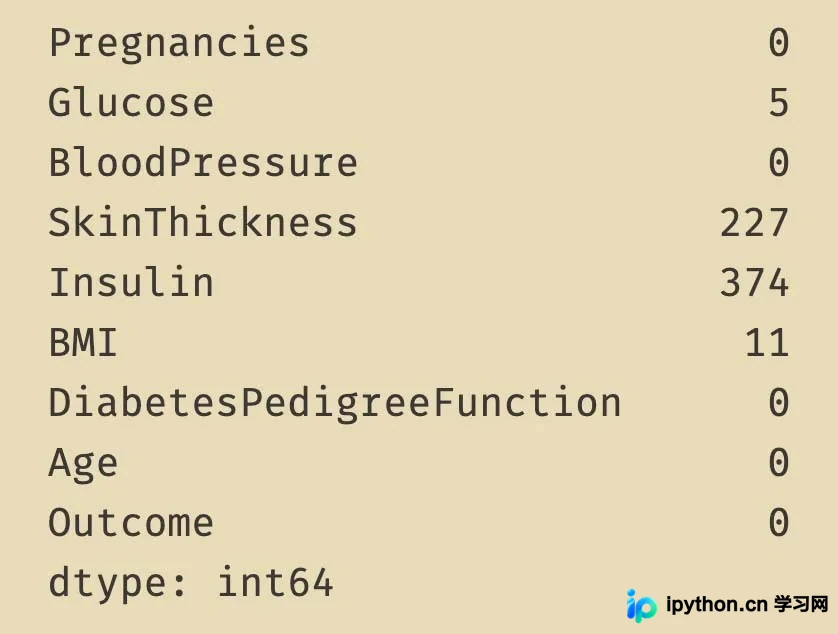
可以看到,BloodPressure 中的 35 个缺失值已消失。以下是部分填充后的具体数据截图。
diabetes_data_copy.iloc[null_index]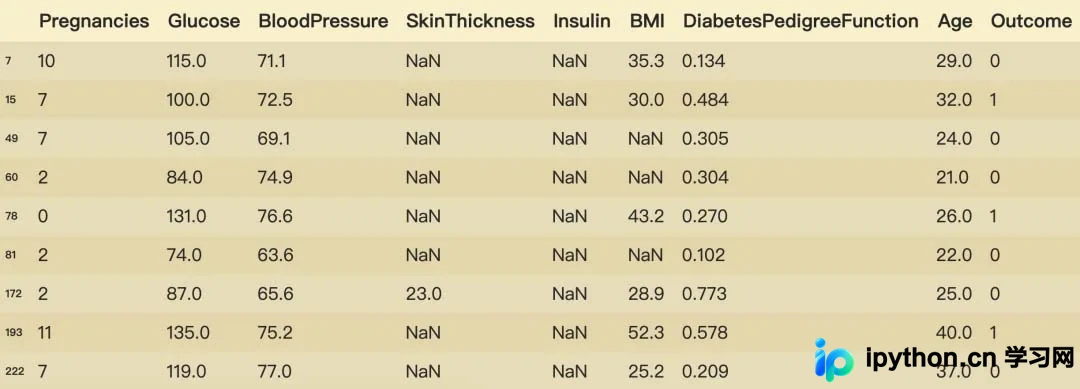
至此,BloodPressure 中的缺失值已根据 DiabetesPedigreeFunction 和 Age 使用 KNNImputer 完成填充。需要注意的是,对于非数值型特征,必须先将其转换为数值型特征,才能进行 KNNImputer 填充操作,因为目前 KNNImputer 方法仅支持数值型特征。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















