


利用numpy和pandas处理csv文件中的时间方法

发布时间:2026-10-13 |
4人浏览过
本文介绍在机器学习与深度学习中,如何利用Python的pandas和numpy库处理CSV文件中的时间变量。通过示例代码展示将时间列合并、解析为标准格式,并转换为float或int类型数值的过程,以便进行后续的分析与建模。
运行环境包含numpy、pandas库以及Python3版本。
在机器学习与深度学习的预测或回归任务中,若变量包含时间信息,需进行适当转换方可进行分析。相关时间变量示例如下,本文将演示如何使用pandas和numpy处理CSV文件中的时间数据。
date (UTC) Price
01/01/2015 0:00 48.1
01/01/2015 1:00 47.33
01/01/2015 2:00 42.27
#coding:utf-8
import datetime
import pandas as pd
import numpy as np
import pickle
#用pandas将时间转为标准格式
dateparse = lambda dates: pd.datetime.strptime(dates,'%d/%m/%Y %H:%M')
#将时间栏合并,并转为标准时间格式
rawdata = pd.read_csv('RealMarketPriceDataPT.csv',parse_dates={'timeline':['date','(UTC)']},date_parser=dateparse)
#定义一个将时间转为数字的函数,s为字符串
def datestr2num(s):
 #toordinal()将时间格式字符串转为数字
 return datetime.datetime.strptime(s,'%Y-%m-%d %H:%M:%S').toordinal()
x = []
y = []
new_date = []
for i in range(rawdata.shape[0]):
 x_convert = int(datestr2num(str(rawdata.ix[i,0])))
 new_date.append(x_convert)
 y_convert = rawdata.ix[i,1].astype(np.float32)
 x.append(x_convert)
 y.append(y_convert)
x = np.array(x).astype(np.float32)
"""
with open('price.pickle','wb') as f:
 pickle.dump((x,y),f)
"""
print(datetime.datetime.fromordinal(new_date[0]),'------>>>>>>',new_date[0])
print(datetime.datetime.fromordinal(new_date[10]),'------>>>>>>',new_date[10])
print(datetime.datetime.fromordinal(new_date[20]),'------>>>>>>',new_date[20])
print(datetime.datetime.fromordinal(new_date[30]),'------>>>>>>',new_date[30])
print(datetime.datetime.fromordinal(new_date[40]),'------>>>>>>',new_date[40])
print(datetime.datetime.fromordinal(new_date[50]),'------>>>>>>',new_date[50])
处理结果展示
目标是将CSV文件中的时间列合并为单列,并转换为便于数据分析的float或int类型。
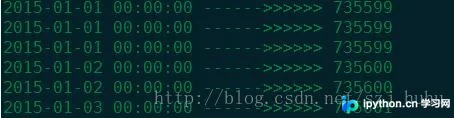
以上即为利用numpy和pandas处理CSV文件中时间的方法分享,希望能为读者提供参考,并欢迎继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















