


解析TensorFlow权重文件:从CheckpointReader到ResNet架构详解

本文详细介绍如何利用TensorFlow的tf.train.NewCheckpointReader函数解读权重文件。通过get_variable_to_shape_map和get_tensor方法获取张量名称及数值,并深入解析ResNet_v2_152模型中tensor name的命名规则,包括block、unit及层类型。同时补充了TensorFlow模型调用过程中checkpoint、graph及model文件的生成机制与查看方法,适用于模型调试与部署参考。
解读TensorFlow权重文件时,可以使用tf.train.NewCheckpointReader函数作为入口工具。
调用reader.get_variable_to_shape_map()方法,能够提取出权重文件中存储的所有tensor名称。
通过reader.get_tensor(key)函数,可以获取指定key对应的具体权重数值。
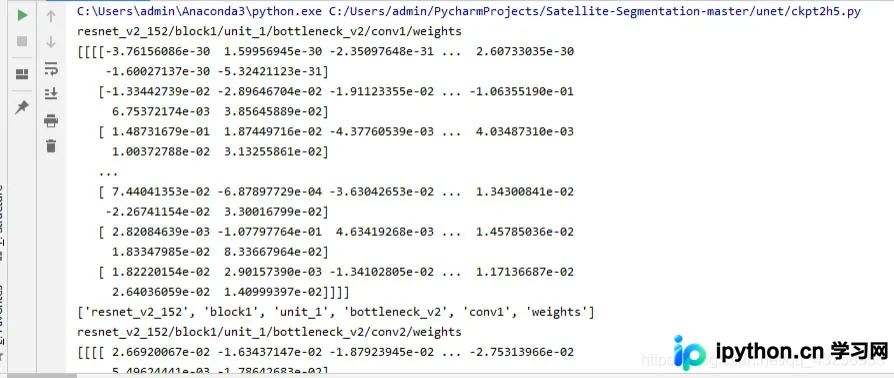
import tensorflow as tf
cpktFileName = r'.\models\resnet_v2_152.ckpt'
reader = tf.train.NewCheckpointReader(cpktFileName)
for key in sorted(reader.get_variable_to_shape_map()):

    if key.endswith('weights') or key.endswith('biases'):
        keySplits = key.split(r'/')
        print(key)
        print(reader.get_tensor(key))
针对resnet_v2_152模型的权重tensor名称进行具体解读。
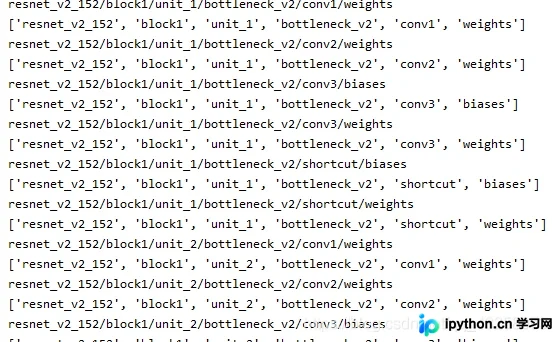
首先,每个tensor name均以resnet_v2_152作为前缀开头。
其次,tensor name的第二段标识为block,该模型共包含四个block,这一结构直接对应于网络架构的设计。
第三,第三字段标识为unit,每个block内部包含的unit数量并不相同,这同样由网络架构决定。
第四,除了最终的平坦层(flatten layer)外,第四字段统一标记为bottleneck_v2。
第五,第五字段表示具体的卷积或跳跃连接类型,常见取值包括'conv1'、'conv2'、'conv3'以及'shortcut'。
第六,第六字段区分参数类型,通常为'weights'(权重)或'biases'(偏置)。
补充说明:关于TensorFlow模型的调用流程及权重查看方法。
此处以vc版本的tensorpack说明文档为例进行阐述。
模型调用机制分析。
每次运行模型时,系统会生成checkpoint、graph以及model相关文件。
具体而言,若文件夹中已存在checkpoint文件,且配置了自动调用上次模型的选项,则可以在之前的基础上继续训练;否则系统将重新生成新的模型文件,且无法调用之前的模型,即使该文件夹中已存在旧文件。
此外,每次运行都会重新生成graph文件,即使旧的graph文件依然存在。因此,调用上次模型与文件夹中是否保留graph文件无关。
权重变量的查看方法。
import numpy as np
import tensorflow as tf
import sys
model = sys.argv[1]
tensor = sys.argv[2]
reader = tf.train.NewCheckpointReader(model)
all_variables = reader.get_variable_to_shape_map()
#reader = pywrap_tensorflow.NewCheckpointReader(ckpt_path)
#param_dict = reader.get_variable_to_shape_map()
for key, val in all_variables.items():
    try:
        print key, val
        #key是网络参数名,val是维度
    except:
        pass
w0 = reader.get_tensor(tensor)
np.save('con1d_w.npy',w0)
print(type(w0))
print(w0.shape)
print(w0[0])
相关文件内容的详细解读。
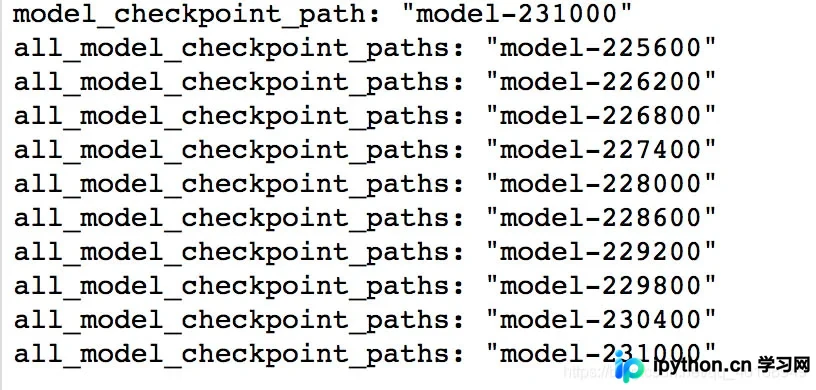
checkpoint文件记录了保存的最新checkpoint文件名以及其他checkpoint文件的列表。在推理(inference)阶段,可以通过修改此文件来指定使用哪一个模型。
MyModel.meta文件用于保存图结构,该文件采用pb(Protocol Buffer)格式,内部包含变量、op操作符以及集合等信息。
ckpt文件是二进制格式,用于保存所有的weights、biases、gradients等变量。在TensorFlow 0.11版本之前,这些数据保存在.ckpt文件中;0.11版本之后,数据通过两个文件进行保存,例如:
MyModel.data-00000-of-00001
MyModel.index
以上内容为个人经验总结,希望能为大家提供参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















