


Python实现影视网站资源链接抓取工具

发布时间:2026-10-14 |
3人浏览过
本文介绍使用Python编写的影视网站资源抓取工具,通过requests和re模块解析网页结构,结合多线程与并发处理提升效率。代码包含自定义请求头、Cookie管理及正则提取逻辑,支持批量获取指定影视内容的下载链接,适合对Python爬虫感兴趣的用户参考学习。
项目源码托管地址如下所示:
https://github.com/GriffinLewis2001/Python_movie_links_scraper
程序运行效果展示
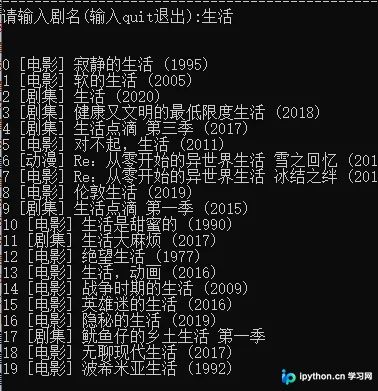
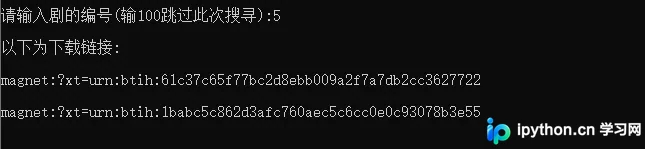
所需依赖模块导入
import requests,re
from requests.cookies import RequestsCookieJar
from fake_useragent import UserAgent
import os,pickle,threading,time
import concurrent.futures
from goto import with_goto
核心爬虫逻辑代码
def get_content_url_name(url):
    send_headers = {
     "User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36",
    "Connection": "keep-alive",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.8"

        }
    cookie_jar = RequestsCookieJar()
    cookie_jar.set("mttp", "9740fe449238", domain="www.yikedy.co")
    response=requests.get(url,send_headers,cookies=cookie_jar)
    response.encoding='utf-8'
    content=response.text
    reg=re.compile(r'<a href="(.*?)" rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  class="thumbnail-img" title="(.*?)"')
    url_name_list=reg.findall(content)
    return url_name_list

def get_content(url):
    send_headers = {
     "User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36",
    "Connection": "keep-alive",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.8"

        }
    cookie_jar = RequestsCookieJar()
    cookie_jar.set("mttp", "9740fe449238", domain="www.yikedy.co")
    response=requests.get(url,send_headers,cookies=cookie_jar)
    response.encoding='utf-8'
    return response.text


def search_durl(url):
    content=get_content(url)
    reg=re.compile(r"{'\\x64\\x65\\x63\\x72\\x69\\x70\\x74\\x50\\x61\\x72\\x61\\x6d':'(.*?)'}")
    index=reg.findall(content)[0]
    download_url=url[:-5]+r'/downloadList?decriptParam='+index
    content=get_content(download_url)
    reg1=re.compile(r'title=".*?" href="(.*?)" rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow" ')
    download_list=reg1.findall(content)
    return download_list
def get_page(url):
    send_headers = {
     "User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36",
    "Connection": "keep-alive",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.8"

        }
    cookie_jar = RequestsCookieJar()
    cookie_jar.set("mttp", "9740fe449238", domain="www.yikedy.co")
    response=requests.get(url,send_headers,cookies=cookie_jar)
    response.encoding='utf-8'
    content=response.text
    reg=re.compile(r'<a target="_blank" class="title" href="(.*?)" rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  title="(.*?)">(.*?)<\/a>')
    url_name_list=reg.findall(content)
    return url_name_list
@with_goto
def main():

    print("=========================================================")
    name=input("请输入剧名(输入quit退出):")
    if name == "quit":
        exit()
    url="http://www.yikedy.co/search?query="+name
    dlist=get_page(url)
    print("\n")
    if(dlist):
        num=0
        count=0
        for i in dlist:
            if (name in i[1]) :
                print(f"{num} {i[1]}")
                num+=1
            elif num==0 and count==len(dlist)-1:
                goto .end
            count+=1
        dest=int(input("\n\n请输入剧的编号(输100跳过此次搜寻):"))
        if dest == 100:
            goto .end
        x=0
        print("\n以下为下载链接:\n")
        for i in dlist:
            if (name in i[1]):
                if(x==dest):
                    for durl in search_durl(i[0]):
                        print(f"{durl}\n")

                    print("\n")

                    break
                x+=1

    else:
        label .end
        print("没找到或不想看\n")
完整可运行代码
import requests,re
from requests.cookies import RequestsCookieJar
from fake_useragent import UserAgent
import os,pickle,threading,time
import concurrent.futures
from goto import with_goto

def get_content_url_name(url):
    send_headers = {
     "User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36",
    "Connection": "keep-alive",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.8"

        }
    cookie_jar = RequestsCookieJar()
    cookie_jar.set("mttp", "9740fe449238", domain="www.yikedy.co")
    response=requests.get(url,send_headers,cookies=cookie_jar)
    response.encoding='utf-8'
    content=response.text
    reg=re.compile(r'<a href="(.*?)" rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  class="thumbnail-img" title="(.*?)"')
    url_name_list=reg.findall(content)
    return url_name_list

def get_content(url):
    send_headers = {
     "User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36",
    "Connection": "keep-alive",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.8"

        }
    cookie_jar = RequestsCookieJar()
    cookie_jar.set("mttp", "9740fe449238", domain="www.yikedy.co")
    response=requests.get(url,send_headers,cookies=cookie_jar)
    response.encoding='utf-8'
    return response.text


def search_durl(url):
    content=get_content(url)
    reg=re.compile(r"{'\\x64\\x65\\x63\\x72\\x69\\x70\\x74\\x50\\x61\\x72\\x61\\x6d':'(.*?)'}")
    index=reg.findall(content)[0]
    download_url=url[:-5]+r'/downloadList?decriptParam='+index
    content=get_content(download_url)
    reg1=re.compile(r'title=".*?" href="(.*?)" rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow" ')
    download_list=reg1.findall(content)
    return download_list
def get_page(url):
    send_headers = {
     "User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.103 Safari/537.36",
    "Connection": "keep-alive",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.8"

        }
    cookie_jar = RequestsCookieJar()
    cookie_jar.set("mttp", "9740fe449238", domain="www.yikedy.co")
    response=requests.get(url,send_headers,cookies=cookie_jar)
    response.encoding='utf-8'
    content=response.text
    reg=re.compile(r'<a target="_blank" class="title" href="(.*?)" rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  rel="external nofollow"  title="(.*?)">(.*?)<\/a>')
    url_name_list=reg.findall(content)
    return url_name_list
@with_goto
def main():

    print("=========================================================")
    name=input("请输入剧名(输入quit退出):")
    if name == "quit":
        exit()
    url="http://www.yikedy.co/search?query="+name
    dlist=get_page(url)
    print("\n")
    if(dlist):
        num=0
        count=0
        for i in dlist:
            if (name in i[1]) :
                print(f"{num} {i[1]}")
                num+=1
            elif num==0 and count==len(dlist)-1:
                goto .end
            count+=1
        dest=int(input("\n\n请输入剧的编号(输100跳过此次搜寻):"))
        if dest == 100:
            goto .end
        x=0
        print("\n以下为下载链接:\n")
        for i in dlist:
            if (name in i[1]):
                if(x==dest):
                    for durl in search_durl(i[0]):
                        print(f"{durl}\n")

                    print("\n")

                    break
                x+=1

    else:
        label .end
        print("没找到或不想看\n")

print("本软件由CLY.所有\n\n")
while(True):
    main()
以上是关于使用Python从影视网站抓取下载链接的详细教程,如需了解更多Python相关资源,请持续关注本站后续更新的文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















