


Python实现基于HanLP二元语法模型的维特比分词

本文详解如何利用Python和HanLP库实现基于二元语法的中文分词。通过加载一元与二元语法模型构建词网,并应用Viterbi算法求解最短路径,完成从模型训练到预测解码的完整流程。文章包含核心代码解析与实战测试,展示模型对未见词汇的泛化能力。
前言
在机器学习流程中,获取训练集后便进入预测阶段。预测即利用已训练模型对输入句子进行推断,在中文分词场景下,该过程表现为推断最优分词序列,这一过程也常被称为解码。
在HanLP库中,二元语法的解码功能由ViterbiSegment分词器提供。本文将深入解析该分词器的具体使用方法与实现原理。
加载模型
在前文博文中,我们已完成一元语法与二元语法模型的训练。后续处理均基于生成的模型文件进行,因此首要步骤是将这些模型文件加载至程序中:
if __name__ == "__main__":
    MODEL_PATH = "123"
    HanLP.Config.CoreDictionaryPath = MODEL_PATH + ".txt"
    HanLP.Config.BiGramDictionaryPath = MODEL_PATH + ".ngram.txt"
    CoreDictionary = SafeJClass("com.hankcs.hanlp.dictionary.CoreDictionary")
    CoreBiGramTableDictionary = SafeJClass('com.hankcs.hanlp.dictionary.CoreBiGramTableDictionary')
    print(CoreDictionary.getTermFrequency("秦机"))
    print(CoreBiGramTableDictionary.getBiFrequency("秦机","的"))
运行上述代码后,控制台输出效果如下:
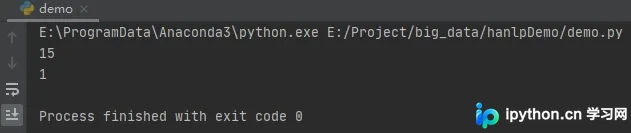
此处演示通过CoreDictionary.getTermFrequency()方法获取词“秦机”的一元频次,以及通过CoreBiGramTableDictionary.getBiFrequency()方法获取二元语法“秦机 的”的条件频次。
构建词网
前文已介绍特殊符号“始##始”代表句子起始,“末##末”代表句子结束。词网(WordNet)是指由句子中所有匹配的一元语法节点构成的有向无环图。以MSR词典中的句子“秦机和科技”为例,基于给定的一元词典,我们将句子中所有可能的词语提取出来,构建出如下词网结构:
[始##始]
[秦机]
[]
[和,和科]
[科技]
[技]
[末##末]
对应的词网可视化图如下所示:
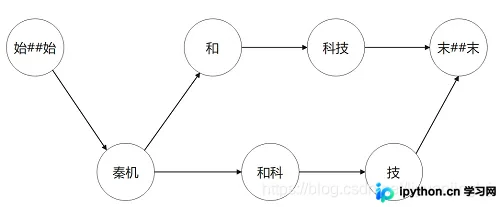
此处仅为示例说明词网概念,需注意“和科”并非实际词汇,仅为构建过程中的临时节点。
接下来,我们将通过具体代码实现词网的构建。相关代码如下:
def build_wordnet(sent, trie):
    JString = JClass('java.lang.String')
    Vertex = JClass('com.hankcs.hanlp.seg.common.Vertex')
    WordNet = JClass('com.hankcs.hanlp.seg.common.WordNet')
    searcher = trie.getSearcher(JString(sent), 0)
    wordnet = WordNet(sent)
    while searcher.next():
        wordnet.add(searcher.begin + 1,
                    Vertex(sent[searcher.begin:searcher.begin + searcher.length], searcher.value, searcher.index))
    # 原子分词,保证图连通
    vertexes = wordnet.getVertexes()
    i = 0
    while i < len(vertexes):
        if len(vertexes[i]) == 0:  # 空白行
            j = i + 1
            for j in range(i + 1, len(vertexes) - 1):  # 寻找第一个非空行 j
                if len(vertexes[j]):
                    break
            wordnet.add(i, Vertex.newPunctuationInstance(sent[i - 1: j - 1]))  # 填充[i, j)之间的空白行
            i = j
        else:
            i += len(vertexes[i][-1].realWord)

    return wordnet


if __name__ == "__main__":
    MODEL_PATH = "123"
    HanLP.Config.CoreDictionaryPath = MODEL_PATH + ".txt"
    HanLP.Config.BiGramDictionaryPath = MODEL_PATH + ".ngram.txt"
    CoreDictionary = SafeJClass("com.hankcs.hanlp.dictionary.CoreDictionary")
    CoreBiGramTableDictionary = SafeJClass('com.hankcs.hanlp.dictionary.CoreBiGramTableDictionary')
    print(build_wordnet("秦机和科技", CoreDictionary.trie))
执行代码后,输出结果与上述图示结构基本一致:
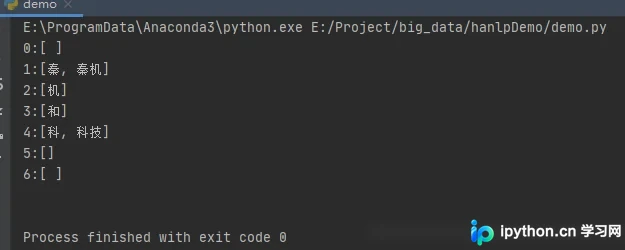
维特比算法
若将词图中每条边赋予二元语法的概率作为权重(距离),则求解词图上的最短路径成为关键问题。
假设文本长度为n,则理论上存在2^(n-1)种切分方式,因为每两个字符间都有“切分”或“不切分”两种选择,导致时间复杂度高达O(2^(n-1))。这在实际应用中是不现实的,因此引入维特比算法(Viterbi Algorithm)进行优化。
维特比算法的核心原理包含前向与后向两个步骤:
- 前向过程:从起点开始向后遍历节点,动态更新到达当前节点的最小累积概率(最小花费)及对应的前驱指针。
- 后向过程:从终点出发,沿前驱指针反向回溯,从而重构出最短路径。
维特比算法的Python实现代码如下:
def viterbi(wordnet):
    nodes = wordnet.getVertexes()
    # 前向遍历
    for i in range(0, len(nodes) - 1):
        for node in nodes[i]:
            for to in nodes[i + len(node.realWord)]:
                # 根据距离公式计算节点距离,并维护最短路径上的前驱指针from
                to.updateFrom(node)
    # 后向回溯
    # 最短路径
    path = []
    # 从终点回溯
    f = nodes[len(nodes) - 1].getFirst()
    while f:
        path.insert(0, f)
        # 按前驱指针from回溯
        f = f.getFrom()
    return [v.realWord for v in path]
实战
现在进行完整测试:使用msr_test_gold.utf8语料训练模型,针对句子“秦机和科技”构建常见词图,最后运行维特比算法获取分词结果。详细代码如下:
if __name__ == "__main__":
    MODEL_PATH = "123"
    corpus_path = r"E:\ProgramData\Anaconda3\Lib\site-packages\pyhanlp\static\data\test\icwb2-data\gold\msr_test_gold.utf8"
    train_model(corpus_path, MODEL_PATH)
    HanLP.Config.CoreDictionaryPath = MODEL_PATH + ".txt"
    HanLP.Config.BiGramDictionaryPath = MODEL_PATH + ".ngram.txt"
    CoreDictionary = SafeJClass("com.hankcs.hanlp.dictionary.CoreDictionary")
    CoreBiGramTableDictionary = SafeJClass('com.hankcs.hanlp.dictionary.CoreBiGramTableDictionary')
    ViterbiSegment = JClass('com.hankcs.hanlp.seg.Viterbi.ViterbiSegment')
    MODEL_PATH = "123"
    HanLP.Config.CoreDictionaryPath = MODEL_PATH + ".txt"
    HanLP.Config.BiGramDictionaryPath = MODEL_PATH + ".ngram.txt"
    sent = "秦机和科技"
    wordnet = build_wordnet(sent, CoreDictionary.trie)
    print(viterbi(wordnet))
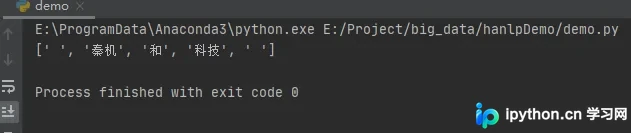
部分读者可能疑惑:既然二元模型中已包含“秦机 和 科技”样本,直接查找即可,为何还要构建词网并运行算法?这是否多此一举?为此,我们将测试文本替换为模型中不存在的“北京和广州”,再次运行程序,效果如下:
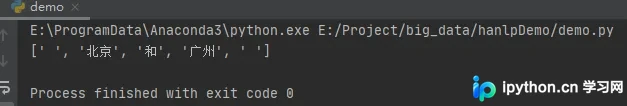
结果显示,模型依然正确输出分词结果[北京 和 广州],这体现了二元语法模型强大的泛化能力。至此,我们完整走通了语料标注、模型训练以及基于维特比算法的预测分词全流程。
关于Python预测分词的实现介绍至此,更多Python预测分词相关内容请搜索本站历史文章或继续浏览后续教程,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















