


Python Pandas多列分组统计中缺失值显示的误区解析

发布时间:2026-10-14 |
4人浏览过
本文解析Pandas使用groupby与size进行多列分组统计时,多级索引默认不显示重复外层键值的特性。通过具体数据示例说明982499等数值行的显示逻辑,指出这并非数据缺失,而是为了排版直观。文章提供完整代码示例,帮助开发者正确理解并处理此类统计结果,避免误判数据完整性。
Pandas多列分组统计的显示特性
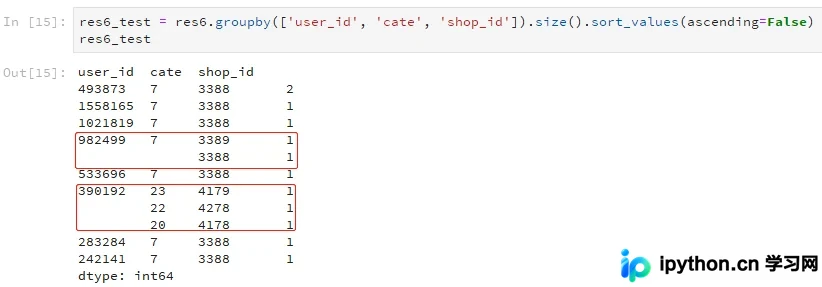
在使用Pandas库进行数据分析时,通过groupby([列名列表]).size()方法执行分组统计是常见操作。需要注意的是,当统计结果包含多级索引时,默认情况下,相同的外层索引值在输出显示中会被省略,仅显示第一行,后续相同值的行对应位置留空。
多级索引省略显示的逻辑解析
以具体数据为例,观察统计结果中的空行可以发现其规律。例如,数值为982499、7、3388且计数为1的那一行,其前两个字段值(user_id为982499,cate为7)与上一行完全一致,因此这两个字段在显示时被省略。同样,数值为390192、22、4278且计数为1的行,其第一个字段值(user_id为390192)与上一行相同,故该字段被省略。这种紧凑的展示方式虽然直观,但对于不熟悉Pandas多级索引机制的新手而言,容易将其误解为数据缺失或空值。
完整数据与操作示例
若对上述现象仍存疑惑,可参考下文提供的完整原始数据及对应的代码操作过程,以便更清晰地理解数据从原始状态到分组统计结果的转换逻辑。
import pandas as pd
res6 = pd.read_csv('test.csv')
res6.shape
(12, 3)
res6.columns
Index(['user_id', 'cate', 'shop_id'], dtype='object')
res6.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 12 entries, 0 to 11
Data columns (total 3 columns):
user_id    12 non-null int64
cate       12 non-null int64
shop_id    12 non-null int64
dtypes: int64(3)
memory usage: 368.0 bytes
res6.describe()
| user_id | cate | shop_id | |
|---|---|---|---|
| count | 1.200000e+01 | 12.000000 | 12.000000 |
| mean | 6.468688e+05 | 10.666667 | 3594.000000 |
| std | 3.988181e+05 | 6.665151 | 373.271775 |
| min | 2.421410e+05 | 7.000000 | 3388.000000 |
| 25% | 3.901920e+05 | 7.000000 | 3388.000000 |
| 50% | 4.938730e+05 | 7.000000 | 3388.000000 |
| 75% | 9.824990e+05 | 10.250000 | 3586.250000 |
| max | 1.558165e+06 | 23.000000 | 4278.000000 |
res6
| user_id | cate | shop_id | |
|---|---|---|---|
| 0 | 390192 | 20 | 4178 |
| 1 | 390192 | 23 | 4179 |
| 2 | 390192 | 22 | 4278 |
| 3 | 1021819 | 7 | 3388 |
| 4 | 242141 | 7 | 3388 |
| 5 | 283284 | 7 | 3388 |
| 6 | 1558165 | 7 | 3388 |
| 7 | 533696 | 7 | 3388 |
| 8 | 982499 | 7 | 3388 |
| 9 | 493873 | 7 | 3388 |
| 10 | 493873 | 7 | 3388 |
| 11 | 982499 | 7 | 3389 |
res6['user_id'].value_counts()
390192     3
982499     2
493873     2
242141     1
1021819    1
533696     1
1558165    1
283284     1
Name: user_id, dtype: int64
res6.groupby(['user_id']).size().sort_values(ascending=False)
user_id
390192     3
982499     2
493873     2
1558165    1
1021819    1
533696     1
283284     1
242141     1
dtype: int64
res6.groupby(['user_id', 'cate']).size().sort_values(ascending=False)
user_id  cate
982499   7       2
493873   7       2
1558165  7       1
1021819  7       1
533696   7       1
390192   23      1
         22      1
         20      1
283284   7       1
242141   7       1
dtype: int64
res6_test = res6.groupby(['user_id', 'cate', 'shop_id']).size().sort_values(ascending=False)
res6_test
user_id  cate  shop_id
493873   7     3388       2
1558165  7     3388       1
1021819  7     3388       1
982499   7     3389       1
               3388       1
533696   7     3388       1
390192   23    4179       1
         22    4278       1
         20    4178       1
283284   7     3388       1
242141   7     3388       1
dtype: int64
至此,关于Python中Pandas进行多列分组统计时出现的显示特性已介绍完毕。如需了解更多关于Pandas多列分组统计的高级用法或相关技巧,建议查阅本站过往文章或继续浏览后续相关内容。感谢大家的支持与关注!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















