


Python 编解码与文本文件处理实战指南

本文详解 Python 中常见的编解码问题,包括 UnicodeEncodeError、UnicodeDecodeError 及 SyntaxError 的成因与解决方案。重点介绍“Unicode 三明治”原则,强调在文件读写时显式指定 encoding 参数以避免 Windows 系统下的文件乱码问题,确保数据处理的准确性。
编解码器
字符与字节之间的转换过程被称为编解码。Python 内置了超过 100 种编解码器,常见的包括:
- ascii(英文体系)
- gb2312(中文体系)
- utf-8(全球通用)
- latin1
- utf-16
编解码器通常拥有多个别名,例如 utf8、utf-8 和 U8 均指向同一编码标准。
这些编解码器名称可以作为 encoding 参数,传递给 open()、str.encode() 以及 bytes.decode() 等函数。
UnicodeEncodeError
大多数非 UTF-8 编解码器(如 cp437)仅能处理 Unicode 字符的一个子集。当尝试将字符转换为字节,而目标编码中未定义该字符时,Python 会抛出 UnicodeEncodeError 异常。
解决方式之一是强制使用 utf8 编码进行转换。
另一种方式是使用 errors 参数来处理错误:
# 忽略 如b'So Paulo'
city.encode("cp437", errors="ignore")
# 替换为? 如b'S?o Paulo'
city.encode("cp437", errors="replace")
# 替换为XML实体 如b'São Paulo'
city.encode("cp437", errors="xmlcharrefreplace")
UnicodeDecodeError
在将字节序列解码为字符时,若遇到无法转换的字节,Python 会抛出 UnicodeDecodeError。这是因为并非所有字节都对应有效的 ASCII 字符,也并非所有字节序列都是合法的 UTF-8 编码。
处理此错误的方法与上述编码错误类似,可通过指定 errors 参数来忽略或替换非法字节。
SyntaxError
Python 3 默认假设源代码使用 UTF-8 编码。如果加载的 .py 模块中包含非 UTF-8 数据且未声明编码格式,解释器会抛出 SyntaxError 异常。
解决方法是在文件顶部添加编码声明注释:
# coding: cp1252
然而,这种做法并非最佳实践。更推荐的做法是定位报错字符,并将其转换为标准的 UTF-8 编码。
从网络直接复制代码粘贴到 IDE 中执行时,经常容易触发此类错误。
处理文本文件
遵循“Unicode 三明治”原则:
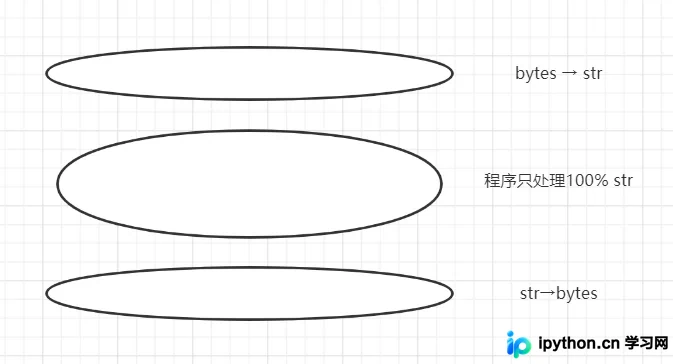
在程序内部应尽量减少对二进制数据的接触,将字节解码为字符后,仅处理字符串对象。例如在 Django 框架中,视图函数应返回 Unicode 字符串,由 Django 负责将响应数据编码为字节序列,且默认使用 UTF-8 编码。
Python 内置的 open 函数遵循这一原则:读取文件时自动进行必要的解码,以文本模式写入文件时自动进行必要的编码。
文件乱码
Windows 系统更容易出现此问题,因为其并未统一采用 UTF-8 编码。以 Windows 10 为例:
>>> open("cafe.txt", "w", encoding="utf8").write("café")
4
>>> open("cafe.txt").read()
'caf茅'
如果在写入文件时指定了 utf8 编码,但读取时未指定,Python 将使用系统默认编码进行解码:
>>> import locale
# 打开文件用这个
# 如果没有设置PYTHONENCODING环境变量,sys.stdout/stdin/stderr也用这个
>>> locale.getpreferredencoding()
'cp936'
这导致 cp936 编码将最后一个字节错误地解码为“茅”字,而非预期的“é”。
>>> import sys
# 二进制数据和字符串之间转换用这个
>>> sys.getdefaultencoding()
'utf-8'
>>> import sys
# 文件名(不是文件内容)用这个
>>> sys.getfilesystemencoding()
'utf-8'
GNU/Linux 或 Mac OS X 系统通常不会遇到此问题,因为它们的默认编码多年来一直稳定为 UTF-8。
解决方案是绝不依赖系统默认编码,打开文件时必须显式传入 encoding 参数。因为不同设备的默认编码可能不同,甚至同一设备在不同时间也可能发生变化。
小结
本文介绍了 Python 的编解码器机制,以及可能出现的 UnicodeEncodeError、UnicodeDecodeError 和 SyntaxError 问题,并给出了 Python 的 open 函数处理文本文件的原则,最后对 Windows 容易出现的文件乱码问题进行了说明。
到此这篇关于 Python 编解码问题及文本文件处理方法的文章就介绍到这了,更多相关Python编解码及文本处理内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
参考资料:
《流畅的Python》
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















