


详解Python中的进程和线程

本文深入解析Python中的进程与线程概念,阐述两者的定义、区别及关系。通过对比并行与并发、同步与异步,结合代码示例演示单进程、多进程及多线程的执行效率差异。重点讲解多进程间通过Queue进行数据共享的方法,以及多线程在GIL限制下的执行机制与创建方式,帮助开发者根据场景选择合适的并发模型。
进程是什么?
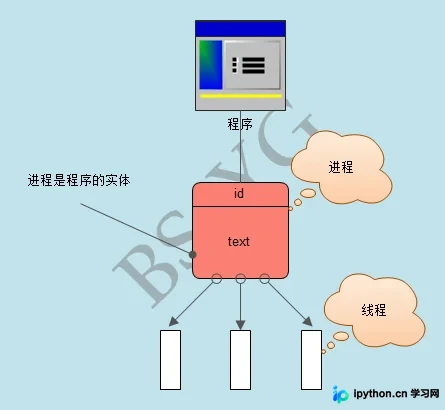
进程是指一个程序在特定数据集上的一次动态执行过程。它主要由程序、数据集和进程控制块三部分构成。其中,程序定义了进程的功能与执行逻辑;数据集包含执行过程中所需的资源;进程控制块则记录进程的外部特征及执行状态,是操作系统识别和管理进程的唯一标识。
线程是什么?
线程,又称轻量级进程,是CPU调度的基本执行单元,也是程序执行的最小单位。它由线程ID、程序计数器、寄存器集合和堆栈组成。引入线程的主要目的是降低程序并发执行时的系统开销,从而提升操作系统的并发性能。值得注意的是,线程本身不拥有系统资源。
进程和线程的区别
进程是计算机中程序关于某数据集合的一次运行活动,它是系统进行资源分配和调度的基本单位,也是操作系统结构的基础。简单来说,进程是具有独立功能的程序关于某个数据集合的一次运行活动,是资源分配和调度的独立单位。 线程则是进程的一个实体,作为CPU调度和分派的基本单位,它是比进程更小的、能独立运行的基本单位。
进程和线程的关系:
(1) 一个线程只能属于一个进程,而一个进程可以包含多个线程,但至少必须有一个线程。 (2) 资源是分配给进程的,同一进程内的所有线程共享该进程的所有资源。 (3) CPU时间片是分配给线程的,即真正在CPU上运行的是线程。
并行和并发
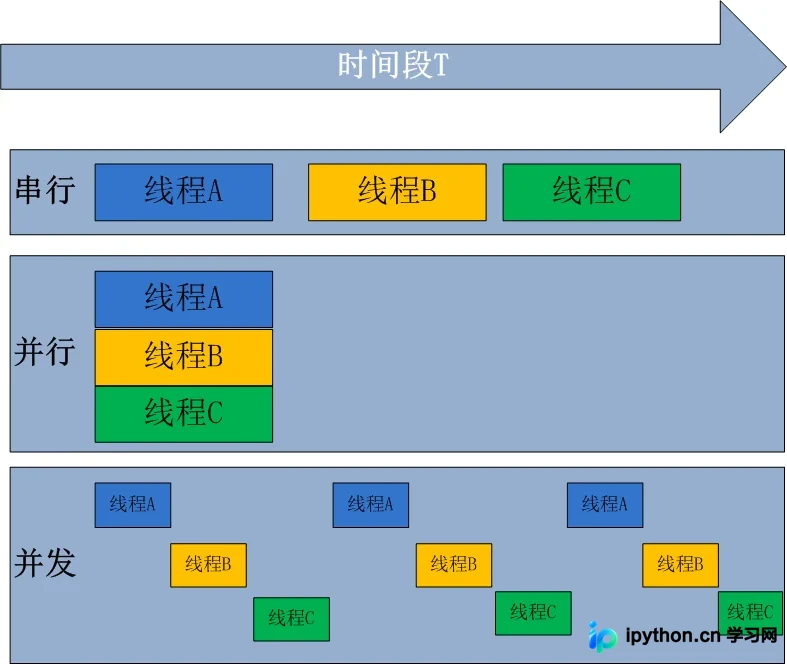
并行处理(Parallel Processing)是指计算机系统中能够同时执行两个或更多个处理任务的计算方法。它可以在同一程序的不同方面同时工作,主要目的是节省解决大型和复杂问题所需的时间。
并发处理(concurrency Processing)是指在一个时间段内,有多个程序处于从启动到运行完毕的状态。这些程序都在同一处理机(CPU)上运行,但在任意特定的时刻点上,只有一个程序在处理机(CPU)上执行。
同步和异步
同步是指当一个进程在执行某个请求时,如果该请求需要一定时间才能返回信息,那么该进程将会一直等待,直到收到返回信息后才继续执行后续操作。 异步是指进程不需要一直等待,而是继续执行下面的操作,不管其他进程的状态。当有消息返回时,系统会通知进程进行处理,这样可以提高执行的效率。 举个例子,打电话时就是同步通信,发短息时就是异步通信。
单例执行
from random import randint
from time import time, sleep


def download_task(filename):
    print('开始下载%s...' % filename)
    time_to_download = randint(5, 10)
    sleep(time_to_download)
    print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))


def main():
    start = time()
    download_task('Python入门.pdf')
    download_task('av.avi')
    end = time()
    print('总共耗费了%.2f秒.' % (end - start))


if __name__ == '__main__':
    main()
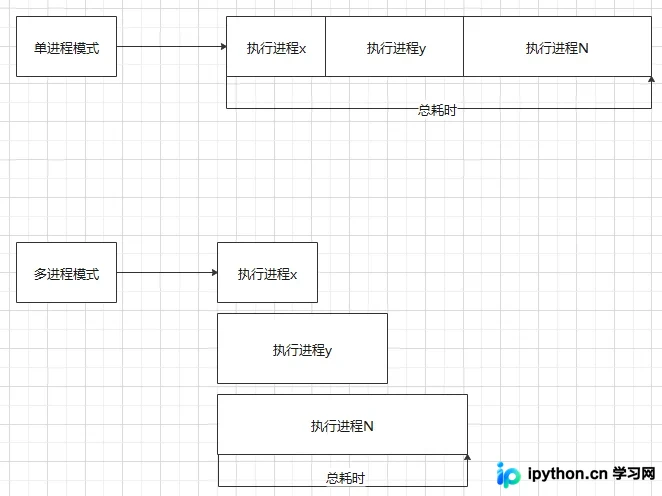
由于运行是顺序执行的,所以总耗时是多个进程时间的总和。
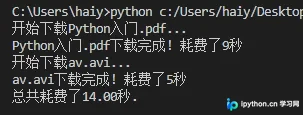
因为是单进程任务,所有任务都是排队进行,所以这种执行效率非常低。我们来添加多进程模式进行多进程同时执行,这样一个进程执行时,另一个进程无需等待,执行时间将大大缩短。
多进程
from random import randint
from time import time, sleep
from multiprocessing import Process
from os import getpid


def download_task(filename):
    print('启动下载进程,进程号:[%d]'%getpid())
    print('开始下载%s...' % filename)
    time_to_download = randint(5, 10)
    sleep(time_to_download)
    print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))


def main():
    start = time()
    p1 = Process(target=download_task,args=('python入门.pdf',))
    p2 = Process(target=download_task,args=('av.avi',))
    p1.start()
    p2.start()
    p1.join()
    p2.join()
    # download_task('Python入门.pdf')
    # download_task('av.avi')
    end = time()
    print('总共耗费了%.2f秒.' % (end - start))


if __name__ == '__main__':
    main()
多个进程并排执行,总耗时就是最长耗时的那个进程的时间。
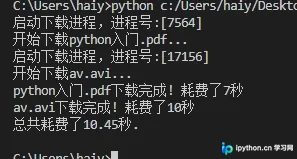
大致的执行流程如下图
多进程的特点是相互独立,不会共享全局变量,即在一个进程中对全局变量修改过后,不会影响另一个进程中的全局变量。
进程间通信
from random import randint
from time import time,sleep
from multiprocessing import Process
from os import getpid

time_to_download = 3
def download_task(filename):
    global time_to_download
    time_to_download += 1
    print('启动下载进程,进程号:[%d]'%getpid())
    print('开始下载%s...' % filename)
    sleep(time_to_download)
    print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))

def download_task2(filename):
    global time_to_download
    print('启动下载进程,进程号:[%d]'%getpid())
    print('开始下载%s...' % filename)
    sleep(time_to_download)
    print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))

def main():
    start = time()
    p1 = Process(target=download_task,args=('python入门.pdf',))
    p2 = Process(target=download_task2,args=('av.avi',))
    p1.start()
    p2.start()
    p1.join()
    p2.join()
    end = time()
    print('总共耗费了%.2f秒.' % (end - start))


if __name__ == '__main__':
    main()
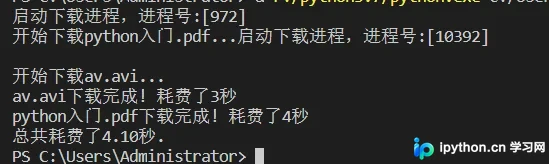
从执行结果可以看出,两个进程间的全局变量无法共享,所以它们是相互独立的
当然多进程也是可以进行通过一些方法进行数据共享的。可以使用multiprocessing模块的Queue实现多进程之间的数据传递,Queue本身是一个消息列队程序。
这里介绍Queue的常用进程通信的两种方法: put 方法用以插入数据到队列中, put 方法还有两个可选参数: blocked 和 timeout。如果 blocked 为 True(默认值),并且 timeout 为正值,该方法会阻塞 timeout 指定的时间,直到该队列有剩余的空间。如果超时,会抛出 Queue.full 异常。如果 blocked 为 False,但该 Queue 已满,会立即抛出 Queue.full 异常。
get 方法可以从队列读取并且删除一个元素。同样, get 方法有两个可选参数: blocked和 timeout。如果 blocked 为 True(默认值),并且 timeout 为正值,那么在等待时间内没有取到任何元素,会抛出 Queue.Empty 异常。如果 blocked 为 False,有两种情况存在,如果Queue 有一个值可用,则立即返回该值,否则,如果队列为空,则立即抛出Queue.Empty 异常。
Queue 队列实现进程间通信
from random import randint
from time import time,sleep
from multiprocessing import Process
import multiprocessing
from os import getpid

time_to_download = 3
def write(q):
    for i in ['python入门','av.avi','java入门']:
        q.put(i)
        print('启动写入进程,进程号:[%d]'%getpid())
        print('开始写入%s...' % i)
        sleep(time_to_download)

def read(q):
    while True:
        if not q.empty():
            print('启动读取进程,进程号:[%d]'%getpid())
            print('开始读取%s...' % q.get())
            sleep(time_to_download)
        else:
            break

def main():
    q = multiprocessing.Queue()
    p1 = Process(target=write,args=(q,))
    p2 = Process(target=read,args=(q,))
    p1.start()
    p1.join()
    p2.start()
    p2.join()


if __name__ == '__main__':
    main()
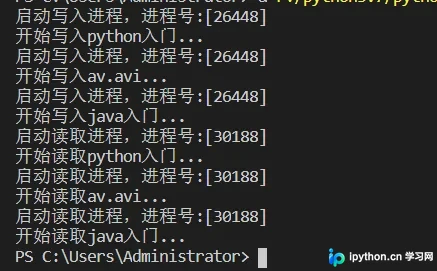
上一个进程写入的数据通过Queue队列共享给了下一个进程,然后下一个进程可以直接进行使用,这样就完成了多进程间的数据共享。
进程池
Pool类可以提供指定数量的进程供用户调用,当有新的请求提交到Pool中时,如果池还没有满,就会创建一个新的进程来执行请求。如果池满,请求就会告知先等待,直到池中有进程结束,才会创建新的进程来执行这些请求。 进程池中常见三个方法:
◆apply:串行 ◆apply_async:并行 ◆map
多线程
from random import randint
from time import time, sleep
from threading import Thread
from os import getpid

def download_task(filename):
    print('启动下载进程,进程号:[%d]' % getpid())
    print('开始下载%s...' % filename)
    time_to_download = randint(5, 10)
    sleep(time_to_download)
    print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))

def main():
    start = time()
    p1 = Thread(target=download_task, args=('python入门.pdf',))
    p2 = Thread(target=download_task, args=('av.avi',))
    p1.start()
    p2.start()
    p1.join()
    p2.join()
    end = time()
    print('总共耗费了%.2f秒.' % (end - start))

if __name__ == '__main__':
    main()
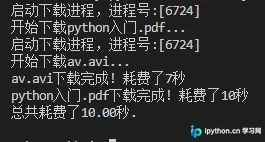
多线程执行因为GIL锁的存在,实际上执行是进行单线程,即一次只执行一个线程,然后在切换其他的线程进行执行,因为其中切换的时间非常的短,所以看上去依然像是多线程一起执行。
通过继承Thread类的方式来创建自定义的线程类,然后再创建线程对象并启动线程
from random import randint
from threading import Thread
from time import time, sleep

class DownloadTask(Thread):
    def __init__(self, filename):
        super().__init__()
        self._filename = filename

    def run(self):
        print('开始下载%s...'% self._filename)
        time_to_download = randint(5,10)
        sleep(time_to_download)
        print('%s下载完成!耗费了%d秒' %(self._filename, time_to_download))

def main():
    start = time()
    t1 = DownloadTask('python入门')
    t2 = DownloadTask('av.avi')
    t1.start()
    t2.start()
    t1.join()
    t2.join()
    end = time()
    print('共耗费了%.2f秒'%(end - start))

if __name__ == '__main__':
    main()
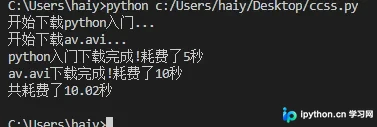
多线程使用类还是函数执行的结果完全一致,具体怎么使用可以结合自己的使用场景。
到此这篇关于详解Python中的进程和线程的文章就介绍到这了,更多相关Python进程和线程内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















