


非极大值抑制(NMS)算法详解与Python实现

本文详细解析非极大值抑制(NMS)算法在计算机视觉目标检测中的应用原理。从基础NMS的IoU计算与筛选流程,到Soft-NMS对高重叠目标的置信度修正策略,结合Python代码示例与Caffe实现,探讨其在R-CNN、Faster R-CNN等模型中的性能提升及局限性。
一、概述
本文不探讨通用的一维或二维NMS算法实现(相关参考可查阅论文《Efficient Non-Maximum Suppression》),而是聚焦于目标检测场景中用于提取最高置信度检测框的NMS机制。以行人检测为例,滑动窗口提取特征并经分类器识别后,每个窗口都会生成一个分数。由于滑动窗口会产生大量相互包含或高度交叉的冗余窗口,此时需利用NMS选取邻域内分数最高(即行人概率最大)的窗口,并抑制那些低分窗口。
NMS在计算机视觉领域具有广泛应用,涵盖视频目标跟踪、数据挖掘、3D重建、目标识别及纹理分析等多个方向。
二、NMS 在目标检测中的应用
2.1、人脸检测框重叠例子
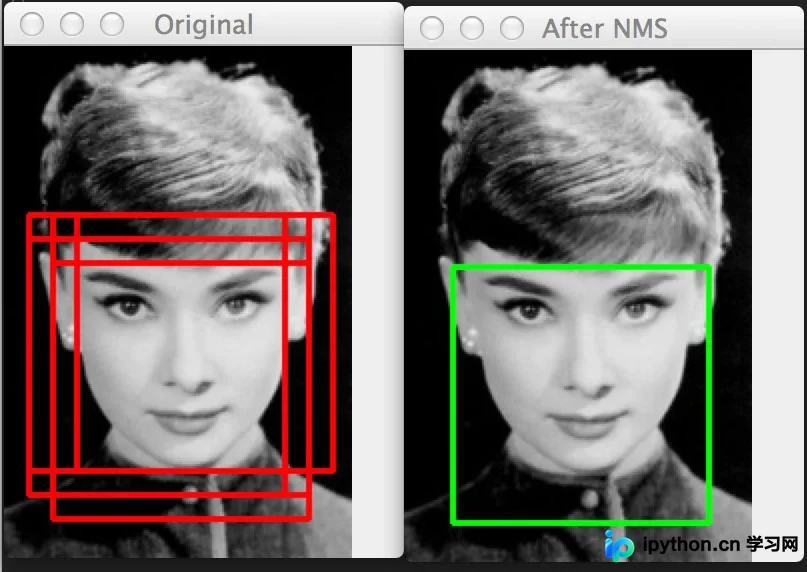
我们的核心目标是去除冗余检测框,仅保留最优的一个。
解决该问题有多种方式,Triggs等人建议使用Mean-Shift算法,通过检测框坐标与当前图像尺度的对数来识别多种模式。然而,其效果通常不如结合强分类器与NMS的方法理想。
2.2、目标检测 pipline
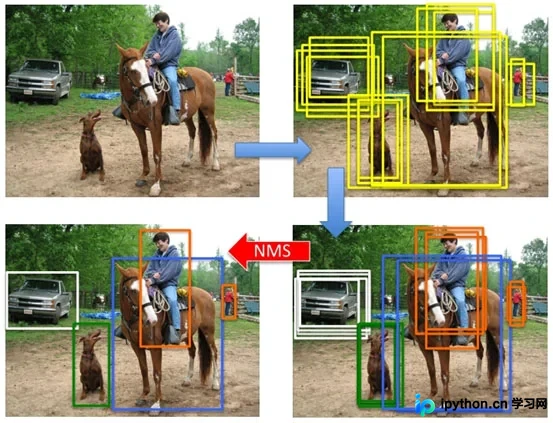
生成候选区域(proposal)后,使用分类网络输出每个框的各类置信度,利用回归网络修正位置坐标,最终应用NMS进行结果筛选。
三、NMS 原理
对于检测框列表B及其对应的置信度分数S,计算过程如下:首先选择具有最大分数score的检测框M,将其从集合B中移除并加入最终检测结果D。接着,通常将集合B中剩余检测框与M的交并比(IoU)大于阈值Nt的框从B中移除。重复此过程,直到集合B为空。
3.1、重叠率(重叠区域面积比例IOU)阈值
常用的阈值范围是 0.3 ~ 0.5。
排序方式可以依据右下角坐标、面积,或通过SVM等分类器得到的得分或概率进行,例如R-CNN中即采用按得分排序的方式。
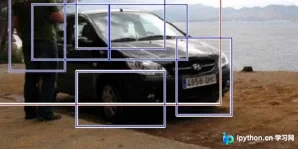
如上图所示,定位一辆车时算法可能输出一堆矩形框,我们需要判别哪些矩形框是无效的。非极大值抑制的具体步骤为:假设存在6个矩形框,根据分类器的类别分类概率进行排序,假设从小到大属于车辆的概率分别为A、B、C、D、E、F。
(1) 从最大概率矩形框F开始,分别判断A~E与F的重叠度IoU是否大于设定的阈值;
(2) 假设B、D与F的重叠度超过阈值,则剔除B、D,并标记第一个矩形框F为保留结果。
(3) 在剩余的矩形框A、C、E中,选择概率最大的E,然后判断E与A、C的重叠度,若重叠度大于一定阈值则予以剔除,并标记E为第二个保留的矩形框。
重复上述过程,直至找出所有被保留下来的矩形框。
3.2、代码示例
在R-CNN中使用NMS确定最终检测框,其过程是将每个候选框送入分类器,根据分类器的类别分类概率进行排序(论文中称为greedy-NMS)。实际上,也可以在分类前运用简化版NMS来剔除部分框。
Python实现的单类别NMS代码位于py_cpu_nms.py。
def py_cpu_nms(dets, thresh):
"""Pure Python NMS baseline."""
 #x1、y1、x2、y2、以及score赋值
 x1 = dets[:, 0]
 y1 = dets[:, 1]
 x2 = dets[:, 2]
 y2 = dets[:, 3]
 scores = dets[:, 4]
 #每一个检测框的面积
 areas = (x2 - x1 + 1) * (y2 - y1 + 1)
 #按照score置信度降序排序
 order = scores.argsort()[::-1]
 keep = [] #保留的结果框集合
 while order.size > 0:
 i = order[0]
 keep.append(i) #保留该类剩余box中得分最高的一个
 #得到相交区域,左上及右下
 xx1 = np.maximum(x1[i], x1[order[1:]])
 yy1 = np.maximum(y1[i], y1[order[1:]])
 xx2 = np.minimum(x2[i], x2[order[1:]])
 yy2 = np.minimum(y2[i], y2[order[1:]])
 #计算相交的面积,不重叠时面积为0
 w = np.maximum(0.0, xx2 - xx1 + 1)
 h = np.maximum(0.0, yy2 - yy1 + 1)
 inter = w * h
 #计算IoU:重叠面积 /(面积1+面积2-重叠面积)
 ovr = inter / (areas[i] + areas[order[1:]] - inter)
 #保留IoU小于阈值的box
 inds = np.where(ovr <= thresh)[0]
 order = order[inds + 1] #因为ovr数组的长度比order数组少一个,所以这里要将所有下标后移一位
 return keep
Faster R-CNN的MATLAB实现与Python版实现逻辑一致,代码见nms.m。此外,nms_multiclass.m实现了多类别NMS,仅是在每类上增加了一层for循环进行NMS处理。
四、NMS loss
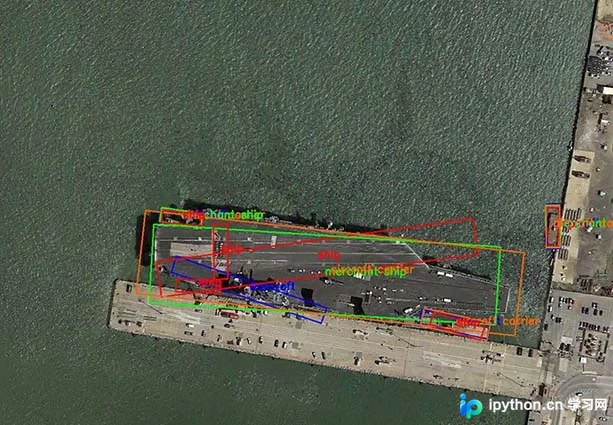
值得注意的是,对于多类别检测任务,若对每类分别进行NMS,当检测结果中包含两个被分到不同类别且IoU较大的目标时,会得到不可接受的结果。如下图所示:
一种改进方式是在损失函数中加入部分NMS损失。NMS损失可定义为与分类损失相同:
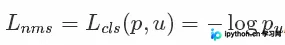
即真实类别u对应的log损失,p是C个类别的预测概率。这实际上相当于增加了分类误差。 参考论文《Rotated Region Based CNN for Ship Detection》(IEEE2017会议论文)的Multi-task for NMS部分。
五、Soft-NMS
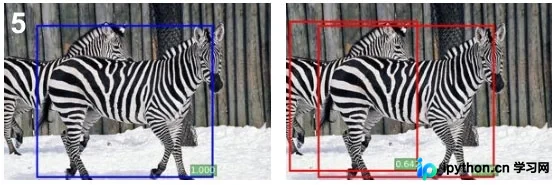
上述NMS算法的一个主要问题是,当两个真实目标(ground truth)的重叠度确实很高时,NMS会将具有较低置信度的框直接去掉(置信度置为0),参见下图所示。
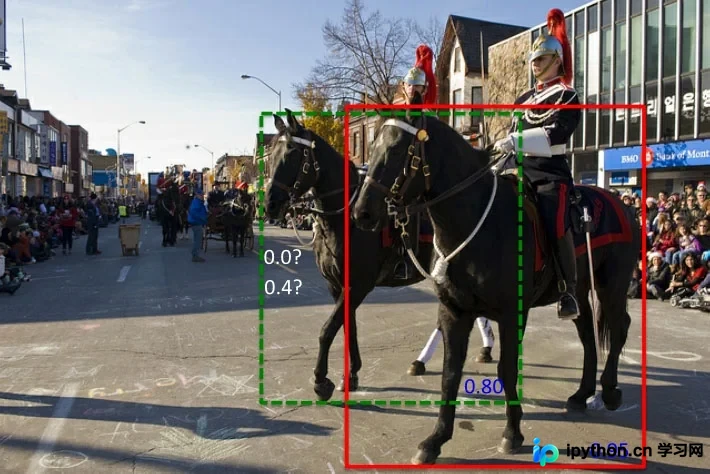
论文:《Improving Object Detection With One Line of Code》 改进之处:
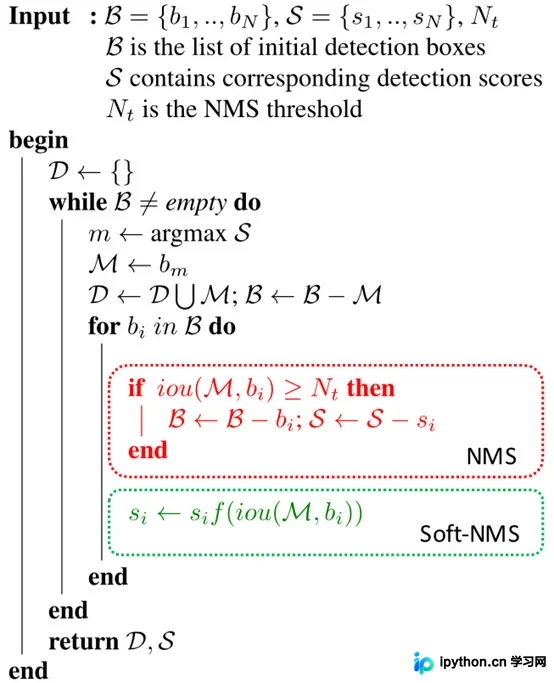
改进方法在于将置信度修改为IoU的函数:f(IoU),使其具有较低的值而不至于从排序列表中直接删除。
1.线性函数
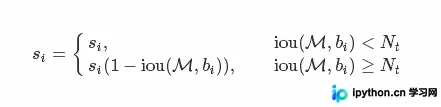
该函数值不连续,在某一点的值会发生跳跃。
2.高斯函数
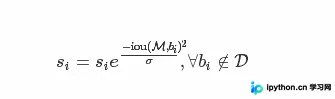
其时间复杂度与传统greedy-NMS相同,为

5.1、python代码实现
ua = float((tx2 - tx1 + 1) * (ty2 - ty1 + 1) + area - iw * ih)
ov = iw * ih / ua #iou between max box and detection box
if method == 1: # linear
	if ov > Nt:
		weight = 1 - ov
	else:
		weight = 1
elif method == 2: # gaussian
	weight = np.exp(-(ov * ov)/sigma)
else: # original NMS
	if ov > Nt:
		weight = 0
	else:
		weight = 1
# re-scoring 修改置信度
# boxes[pos, 4] = weight*boxes[pos, 4]
5.2、Caffe C++ 版实现
makefile/frcnn
效果
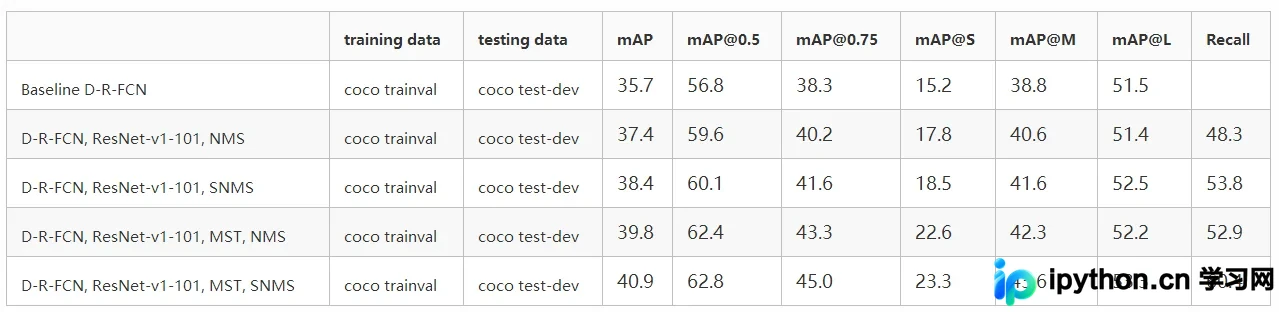
在基于proposal方法的模型结果上应用效果较好,检测效果提升如下:
在R-FCN以及Faster-RCNN模型的测试阶段运用Soft-NMS,在MS-COCO数据集上mAP@[0.5:0.95]能够获得大约1%的提升(详见这里)。如果应用到训练阶段的proposal选取过程,理论上也能获得提升。在实际实验中发现,确实对易重叠的目标类型有提高(目标不一定真的有像素上的重叠,切斜的目标的矩形边框会有较大的重叠)。
而在SSD、YOLO等非proposal方法中没有提升。
六、其它应用
边缘检测:Canny算子中的非极大值抑制是沿着梯度方向进行的,即判断是否为梯度方向上的极值点;
特征点检测:在角点检测等场景下说的非极大值抑制,则是检测中心点处的值是否是某一个邻域内的最大值。
以上就是详解非极大值抑制算法之Python实现的详细内容,更多关于非极大值抑制 Python实现的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















