


图解MySQL InnoDB MVCC实现原理:Undo Log与Read View怎么协作

假设一行数据原来的余额是 100,一个事务正在查询它,另一个事务却把余额改成了 120。第一个事务为什么有时还能继续看到 100,而且普通查询通常不需要把这行数据锁住?核心就在 InnoDB 的 MVCC:Undo Log负责保存能够回溯的旧版本,Read View负责判断哪个版本对当前查询可见。
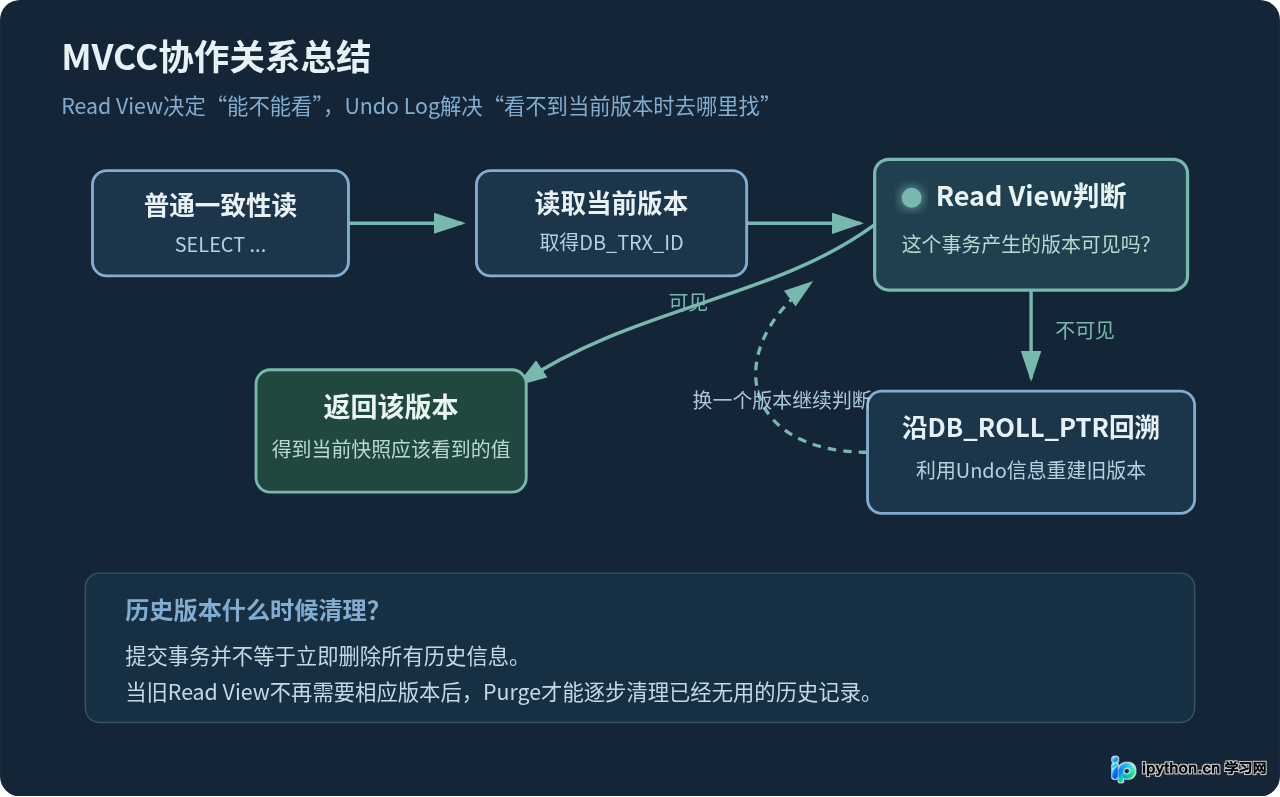
可以先记住一句最重要的话:Read View不保存数据版本,Undo Log也不决定数据是否可见。查询先拿到记录版本,由 Read View判断它能不能看;不能看,就顺着记录中的回滚指针进入 Undo Log寻找更旧版本,再继续判断,直到找到可见版本或确认不存在可见记录。
一、先理解MVCC究竟解决了什么问题
MVCC全称是 Multi-Version Concurrency Control,即多版本并发控制。它解决的问题并不是“让数据库完全不用锁”,而是让很多普通读取可以通过数据版本完成,从而减少读操作和写操作之间不必要的阻塞。
例如现在有一条记录:
id = 1
name = 'Alice'
balance = 100
事务B执行:
UPDATE account
SET balance = 120
WHERE id = 1;
从业务角度看,这行记录从 100 变成了 120。但对于 InnoDB 来说,并不是简单地把旧值彻底丢掉。为了支持事务回滚和一致性读,它还必须保留足够的信息,让系统能够找到修改前的版本。
这就形成了理解MVCC最关键的三个部分:
- 当前记录:聚簇索引中的最新记录版本。
- Undo Log:记录修改前的信息,使旧版本可以被重建。
- Read View:描述创建快照时事务系统的状态,用于判断某个版本是否应该被当前查询看到。
二、一行记录为什么能够形成“版本链”
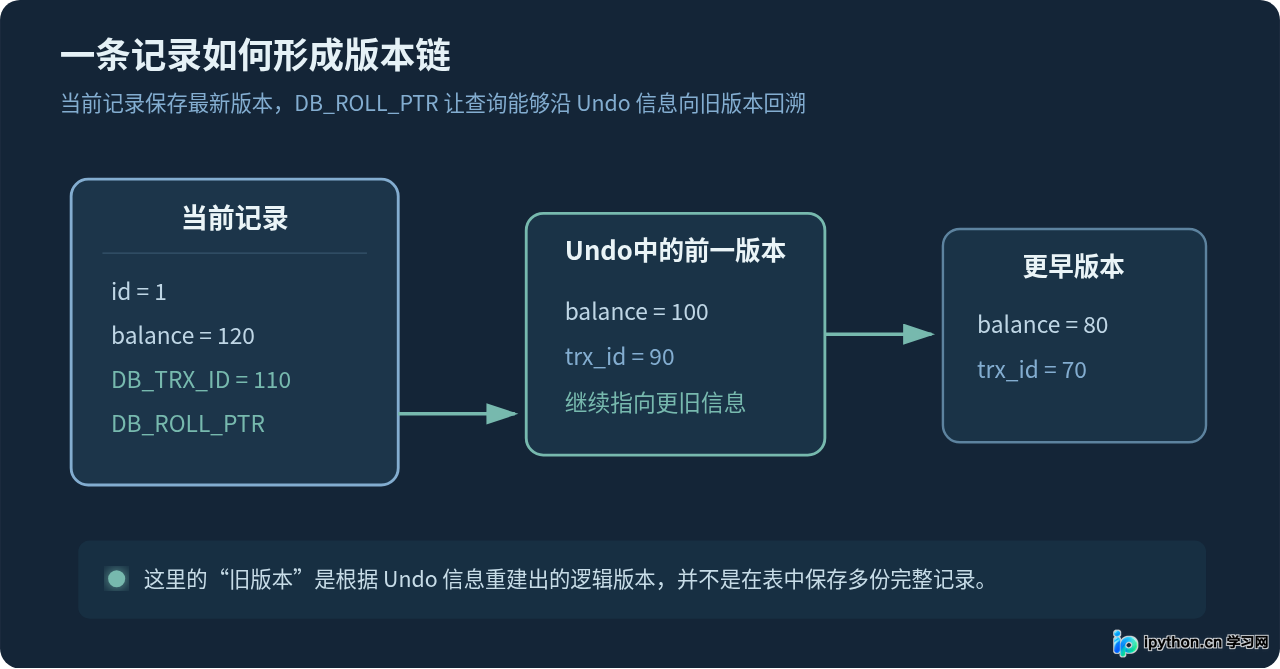
InnoDB记录内部除了用户定义的列,还保存了一些用于事务处理的隐藏信息。理解MVCC时最重要的是下面两个概念:
DB_TRX_ID:最近一次插入或修改该记录版本的事务ID。DB_ROLL_PTR:指向相应 Undo 记录的回滚指针,可用于寻找修改前的信息。
如果表本身没有合适的主键或非空唯一索引,InnoDB还可能生成内部行ID作为聚簇索引键。不过这个内部行ID不是MVCC可见性判断的核心,理解 Undo Log 和 Read View 时重点关注事务ID与回滚指针即可。
Undo Log保存的是完整旧记录吗?
理解这里时容易产生一个误区:认为每修改一次,InnoDB都会在 Undo Log 中复制一整行旧数据。
实际实现会根据操作类型保存恢复旧状态所需要的信息。读取历史版本时,InnoDB根据当前版本和相应 Undo 信息逐步构造出较旧版本。因此,“版本链”更适合作为逻辑上的历史版本链来理解,而不是表中真的存放了一排完整副本。
对于 MVCC一致性读,尤其需要关注的是修改产生的历史版本信息。Insert Undo主要用于插入事务自身发生回滚;事务提交后,没有其他事务需要通过 Insert Undo 看到“插入前的那一行”,因此它与 Update Undo在长期历史版本保留上的作用并不相同。
三、Undo Log有了旧版本,为什么还需要Read View
版本链只能回答:
“这条记录以前是什么样?”
它不能单独回答:
“对于我这个事务来说,哪个版本才应该看见?”
比如当前版本由事务110产生,旧版本由事务90产生。事务110到底能不能看,取决于查询建立快照时事务110是什么状态。如果事务110当时还没有提交,那么这个版本通常不应该出现在当前一致性读的快照中。
Read View就是用来描述这一时刻的事务可见性边界。
可以把Read View理解成一张“事务快照名单”
为了便于理解,可以把一个 Read View抽象成下面几项信息:
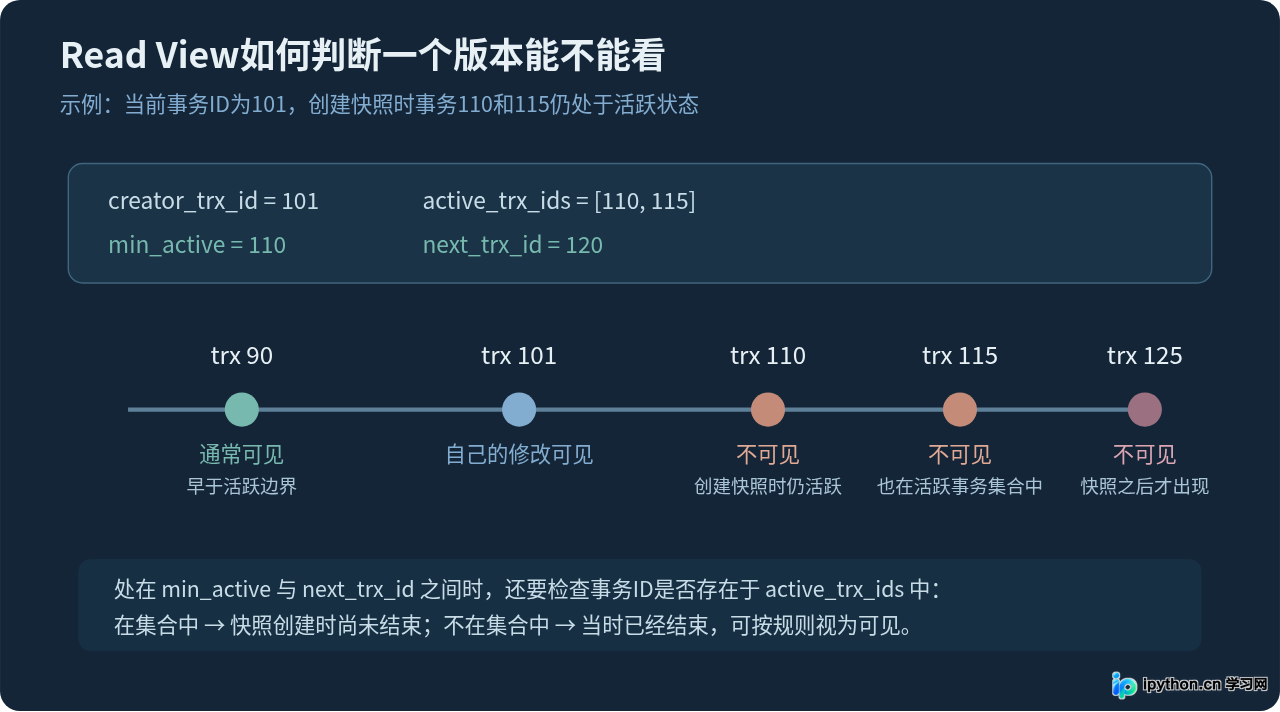
- creator_trx_id:创建这个 Read View的事务自身ID。
- active_trx_ids:创建快照时仍然活跃的事务ID集合。
- min_active_trx_id:这些活跃事务中较小的事务ID边界。
- next_trx_id:创建快照时尚未分配给后续事务的事务ID边界,可理解为快照时事务系统的高水位线。
源码中实际字段名称与抽象文章里的命名不一定完全相同。学习MVCC时没必要先死记源码变量名,先理解它们分别代表什么更重要。
四、Read View的可见性规则到底怎么判断
假设从某个记录版本中读到了事务ID row_trx_id,可以用下面的思路理解其可见性。这里是便于学习的逻辑表达,不要求与源码条件分支逐行对应。
情况1:这个版本就是当前事务自己产生的
如果:
row_trx_id == creator_trx_id那么自己的修改对自己可见。
例如事务A先执行:
UPDATE account
SET balance = 150
WHERE id = 1;
随后在同一个事务里查询这行数据,不可能因为旧快照而让事务连自己刚刚改过的数据都看不到。
情况2:版本来自很早以前已经存在的事务
如果这个版本的事务ID比创建 Read View时最小的活跃事务还小,说明产生这个版本的事务在快照建立之前就已经结束,因此通常可以看到。
用前面的示例:
min_active_trx_id = 110
row_trx_id = 90
事务90早于快照中的活跃事务边界,这个版本属于快照建立前已经存在的历史。
情况3:版本来自快照建立以后才出现的事务
如果:
row_trx_id >= next_trx_id说明产生这个版本的事务在 Read View创建时还没有进入当前快照所代表的事务范围,因此不能看到。
情况4:事务ID落在两个边界之间
这是最容易混淆的情况。
假设:
min_active_trx_id = 110
next_trx_id       = 120
active_trx_ids    = [110, 115]
现在有版本由事务112产生。
112虽然介于110与120之间,但它不在活跃列表中,这说明在创建 Read View时,事务112已经结束,因此它产生的已提交版本可以进入这个快照。
如果版本来自事务115:
115 in [110, 115]说明快照创建时事务115仍然活跃,因此它的这个版本对当前一致性读不可见。
所以,不能简单地根据事务ID“大于还是小于当前事务ID”决定可见性。事务并发执行时,开始顺序、事务ID分配和提交顺序不是同一个概念,Read View中的活跃事务集合正是为了解决这种情况。
五、Undo Log与Read View真正协作时发生了什么
现在把两个组件放到同一条查询路径里。
假设当前聚簇索引记录是:
balance = 120
DB_TRX_ID = 110
DB_ROLL_PTR = → 前一个版本
而当前事务的 Read View中,事务110属于创建快照时尚未结束的事务。
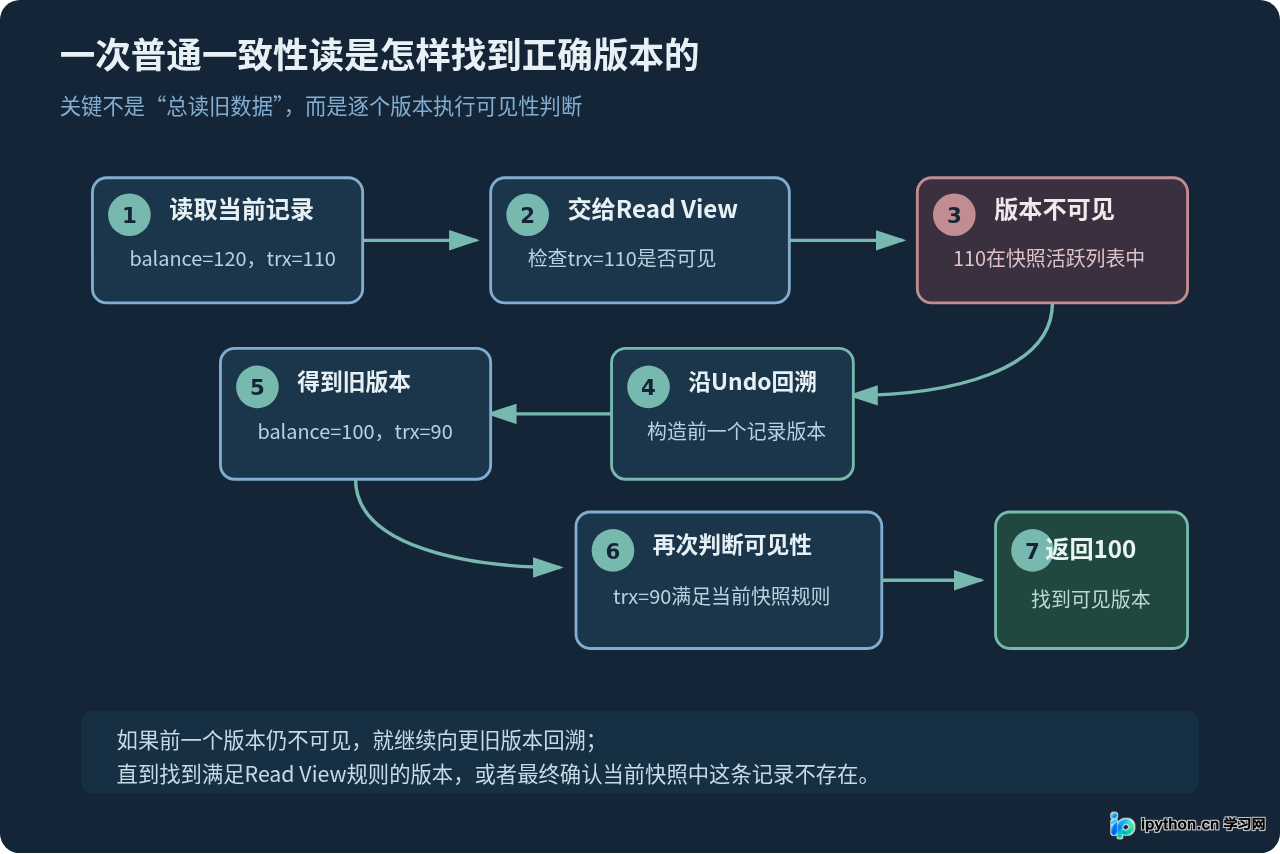
那么查询过程并不是直接返回120,而是:
- 读取当前记录。
- 取出当前版本对应的事务ID 110。
- 使用 Read View检查事务110产生的版本是否可见。
- 发现110位于活跃事务集合中,因此当前版本不可见。
- 根据
DB_ROLL_PTR和 Undo 信息构造前一个版本。 - 假设前一个版本由事务90产生,继续使用同一个 Read View判断。
- 事务90产生的版本符合可见性规则,于是返回旧值100。
因此可以把两者的职责概括成:
| 组件 | 主要职责 | 不能单独完成什么 |
|---|---|---|
| Undo Log | 保存恢复旧状态所需的信息,支持回滚和历史版本构造 | 不知道当前查询应该看哪个版本 |
| Read View | 描述快照建立时的事务状态,判断记录版本是否可见 | 本身不保存某行数据的旧值 |
| 记录中的事务信息 | 告诉系统当前版本由哪个事务产生,并提供历史回溯入口 | 仅凭事务ID不足以完成完整快照读取 |
六、用两个事务完整走一遍MVCC
下面用一个更具体的场景说明为什么同一个数据库,在 REPEATABLE READ 和 READ COMMITTED 下会得到不同结果。
先准备示例表:
CREATE TABLE account (
    id BIGINT PRIMARY KEY,
    balance INT NOT NULL
) ENGINE=InnoDB;

INSERT INTO account (id, balance)
VALUES (1, 100);
假设初始记录由更早的事务90产生。下面的事务编号只是为了说明机制,并不是要求用户能够在客户端直接控制 InnoDB内部事务ID。
REPEATABLE READ:同一事务通常继续使用第一次一致性读建立的快照
事务A:
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;

START TRANSACTION;

SELECT balance
FROM account
WHERE id = 1;
示例结果:
balance
-------
100
这次一致性读建立了事务A之后读取所使用的快照。假设此时事务B处于活跃状态,并且事务B的内部事务ID为110。
事务B随后修改:
START TRANSACTION;

UPDATE account
SET balance = 120
WHERE id = 1;

COMMIT;
现在物理上的当前记录已经可以是:
balance = 120
DB_TRX_ID = 110
事务A再次执行:
SELECT balance
FROM account
WHERE id = 1;
在同一个 REPEATABLE READ事务的一致性读语义下,仍然会依据之前建立的 Read View判断。
如果事务110在那个快照创建时仍然处于活跃状态,那么事务110产生的新版本对这张快照不可见。InnoDB因此通过 Undo 信息找到事务90对应的旧版本,事务A仍然得到:
balance
-------
100
这里尤其值得注意:
不是事务A一直读取某个提前复制好的“100”,而是第二次查询仍使用原来的事务快照规则,然后在需要时重新寻找符合该快照的历史版本。
七、READ COMMITTED为什么可能第二次就看到120
READ COMMITTED与 REPEATABLE READ一个非常关键的区别,是一致性读创建和使用 Read View的时机。
| 隔离级别 | 一致性读的Read View | 典型效果 |
|---|---|---|
| READ COMMITTED | 每次一致性读通常使用新的Read View | 同一事务中的两次SELECT可能看到其他事务在期间提交的新数据 |
| REPEATABLE READ | 同一事务中的普通一致性读通常复用第一次一致性读建立的快照 | 后续普通快照读保持相同的历史视角 |
如果事务A改用 READ COMMITTED:
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;

START TRANSACTION;

SELECT balance
FROM account
WHERE id = 1;
第一次可能看到100。
此后事务B把余额更新成120并提交。
事务A第二次执行同样的普通查询时,会建立新的 Read View。此时事务B已经提交,不再属于新快照中的活跃事务,所以版本120可以变得可见:
SELECT balance
FROM account
WHERE id = 1;
示例结果:
balance
-------
120
因此,“READ COMMITTED只能读取已经提交的数据”虽然方向没错,但如果想真正理解其实现,还应该补充一句:
每次一致性读重新获取事务视角,是它能够看到期间新提交版本的重要原因。
八、普通SELECT和SELECT FOR UPDATE不能混为一谈
学习MVCC时另一个常见问题,是看到 REPEATABLE READ能够读历史版本后,以为事务里的任何SQL都会一直读老版本。
并不是这样。
普通查询:
SELECT balance
FROM account
WHERE id = 1;
通常属于一致性读,会使用MVCC快照。
而下面这种查询:
SELECT balance
FROM account
WHERE id = 1
FOR UPDATE;
属于锁定读。它的目的通常是读取当前可用于后续修改的数据,并对相应记录或范围加锁,因此不能简单套用“普通快照读一直沿用旧 Read View”的理解方式。
同样,下面这些操作本身也需要处理当前可修改的数据并配合锁机制:
UPDATE account
SET balance = balance + 10
WHERE id = 1;

DELETE FROM account
WHERE id = 1;FOR UPDATE、条件更新、乐观锁或其他并发控制方式,需要根据业务一致性要求决定。
九、删除操作在MVCC里为什么也能保留历史可见性
DELETE同样不能简单理解成“执行后立刻从所有历史视角中物理消失”。
例如事务B删除:
DELETE FROM account
WHERE id = 1;

COMMIT;
如果仍然存在一个较早建立的 Read View,而按照这个快照该记录在当时应该存在,那么 InnoDB仍然需要保留足够的历史信息,让旧快照能够得到符合自身视角的结果。
等到系统确认没有任何仍然需要这些旧版本的事务快照后,相关历史版本才可以逐步由 purge机制清理。
这也解释了为什么:
事务提交,并不意味着所有 Undo历史信息都能立即删除。
是否能清理,要考虑是否还有正在运行的一致性读需要这些历史版本。
十、为什么长事务会让Undo历史版本积累
假设一个 REPEATABLE READ事务建立了很早的 Read View,然后几十分钟甚至更长时间都没有结束。
与此同时,其他事务不断执行:
UPDATE ...
DELETE ...
UPDATE ...
DELETE ...
从这些写事务自己的角度看,它们可能早就已经提交。但旧事务仍然有可能根据自己较早的 Read View访问历史数据。
于是一些历史版本暂时不能被清理,否则旧事务需要沿版本链回溯时就找不到应该看到的数据了。
因此在实际数据库维护中,长期运行的事务值得重点关注。它可能带来的影响包括:
- 历史版本保留时间增加;
- Undo相关空间和历史链增长;
- purge清理进度受到限制;
- 某些需要寻找较旧版本的查询回溯成本增加。
所以问题并不是“Undo Log越大就一定是MVCC故障”,而应该继续检查是否存在长期不提交的事务、长时间运行的一致性读,或者持续产生大量更新的工作负载。
十一、把Read View判断规则再压缩成一张图
十二、几个特别容易理解错的地方
1. MVCC不是完全不加锁
MVCC主要帮助普通一致性读减少与写操作之间的直接冲突,但数据库中的更新、删除、锁定读、唯一约束检查等操作仍然会使用锁。
因此下面这种说法不准确:
InnoDB用了MVCC,所以读写都不用锁。更准确的理解是:
很多普通快照读可以通过历史版本完成,而不用等待正在修改记录的事务结束。
2. Read View不是数据快照文件
Read View并没有把查询涉及的数据复制一份。
它更像是一套“可见性规则”和创建快照时的事务状态信息。真正需要旧数据时,系统才结合 Undo信息寻找适合当前视角的历史版本。
3. Undo Log不只是为了ROLLBACK
看到“Undo”这个名字,很容易只想到:
ROLLBACK;实际上,Undo信息除了支持事务回滚,也是 InnoDB MVCC构造历史版本的重要基础。
如果没有这些历史信息,Read View就算知道“当前版本不能看”,也没有办法获得应该返回的旧版本。
4. REPEATABLE READ也不意味着任何情况下都只能看到事务开始时的数据
需要区分:
- 普通一致性读;
- 事务自己的修改;
- 锁定读;
- UPDATE、DELETE等当前操作。
事务自己的修改对自己可见,而锁定读和写操作不能简单按照普通一致性读的快照规则理解。
5. Read View通常不是在START TRANSACTION时简单复制整个数据库状态
以常见的 REPEATABLE READ一致性读为例,理解时应关注一致性快照实际建立的时机,而不是把 START TRANSACTION机械理解成“立即复制一份数据库”。
实际需要严格控制快照建立时机时,也应结合具体事务语句和 MySQL行为进行设计,而不是仅凭“事务开始时间”推断所有可见性。
十三、从一条记录重新串起整个MVCC过程
现在回到最开始的例子。
原始版本:
balance = 100
trx_id = 90
事务110将其修改为:
balance = 120
trx_id = 110
与此同时,某个较早建立的 Read View认为事务110对应的版本不可见。
那么整个读取过程就是:
- InnoDB从索引中取得最新记录版本120。
- 读取这个版本对应的事务ID 110。
- Read View检查110在当前快照中的状态。
- 发现110的版本对该快照不可见。
- 根据回滚指针和 Undo信息寻找旧版本。
- 构造出事务90对应的余额100版本。
- Read View再次判断事务90对应的版本。
- 事务90的版本可见,于是查询返回100。
如果使用 READ COMMITTED,并且下一条查询重新创建 Read View,而事务110此时已经提交,那么新的 Read View可能允许看到事务110产生的版本,于是直接返回120,不必继续回溯到100。
这正是 Undo Log与 Read View协作的完整逻辑。
- 记录中的事务ID告诉InnoDB“这个版本是谁修改的”。
- Read View告诉InnoDB“这个版本对当前一致性读能不能看”。
- 如果不能看,就利用回滚指针和Undo信息寻找更旧版本,再重新判断。
- 当没有任何仍然有效的快照需要旧版本后,Purge才可以逐步清理这些历史信息。
所以,MVCC并不是某一个单独组件实现的功能。记录中的事务信息、Undo历史版本、Read View可见性判断以及Purge清理机制共同组成了InnoDB多版本并发控制的完整链路。其中最需要掌握的关系就是:Undo Log解决“历史版本从哪里来”,Read View解决“当前事务应该看哪个版本”。把这两个职责区分清楚,再理解 READ COMMITTED与 REPEATABLE READ的 Read View创建方式,InnoDB MVCC的大部分核心行为就能串起来了。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















