


Python Scrapy框架爬取小说实战:从项目创建到数据保存

本文详细介绍如何使用Python Scrapy框架进行小说网站数据爬取。内容涵盖Scrapy架构解析、项目与Spider创建、XPath数据提取、Items字段定义、Pipeline数据处理及Settings配置。通过fiction.py等核心代码示例,演示从章节列表解析到内容保存至TXT文件的完整流程,适合初学者掌握Scrapy实战应用。
Scrapy框架简介
Scrapy是一个基于Twisted构建的异步处理框架,采用纯Python语言开发,专为提取结构化数据而设计。该框架架构清晰,模块间耦合度低,具备极强的可扩展性,开发者仅需编写少量代码即可实现高效的数据抓取。
其整体架构如下图所示:
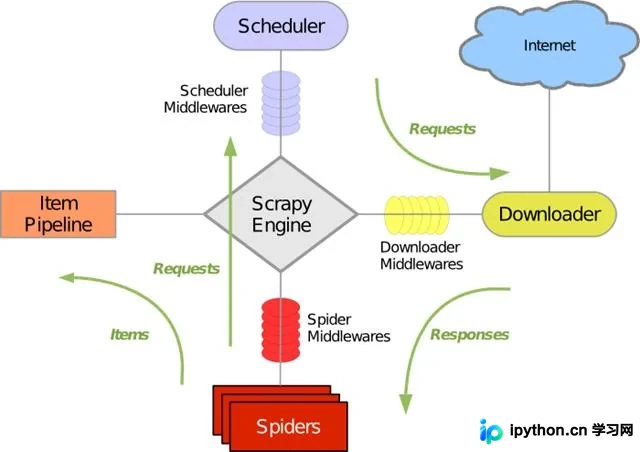
Scrapy Engine(引擎)是整个框架的核心组件,而在实际开发中,我们主要接触和编写代码的模块通常集中在Item Pipeline(项目管道)和Spiders(爬虫)模块。
创建Scrapy项目
首先,通过执行以下命令来初始化一个Scrapy项目,具体执行过程及结果如下图所示:
Scrapy startproject Fiction运行结果如下图所示:
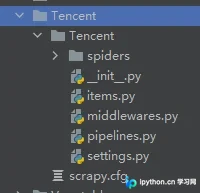
从上图可以看出,我们在C盘根目录下成功创建了一个名为Fiction的Scrapy项目。系统同时提示我们可以使用特定命令来生成第一个Spider爬虫,相关命令如下所示:
cd Fiction          #进入目录
scrapy genspider example example.com    #创建spider爬虫
在上述命令中,example代表我们自定义的爬虫名称,而example.com则表示该爬虫允许爬取的域名范围。
Fiction项目文件夹的具体内容结构如下图所示:
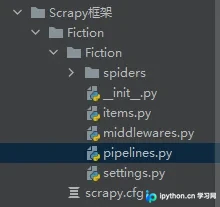
创建Spider爬虫
在前述步骤中,我们已成功构建Scrapy项目并掌握了Spider的创建方法。接下来,我们将创建一个名为fiction的Spider爬虫,其目标域名为www.17k.com,具体代码如下所示:
scrapy genspider fiction www.17k.com执行上述代码后,spiders文件夹中会生成一个fiction.py文件,这便是我们刚刚创建的Spider爬虫文件。
文件结构如下图所示:
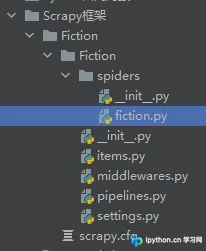
面对生成的多个py文件无需惊慌,通常情况下,我们主要关注并编写代码的文件包括刚创建的spider爬虫文件、items.py以及pipelines.py。具体分工如下:
fiction.py:主要用于编写数据爬取逻辑,负责解析服务器响应、提取目标数据以及生成新的请求;items.py:主要用于预先定义爬取数据的字段,以避免拼写错误或字段定义不一致。当然,也可以选择不预先定义,直接在fiction.py中进行定义;pipelines.py:主要用于编写数据清洗、验证以及存储数据的逻辑。当我们需要将数据直接保存为csv、xml、pickle、marshal或json等格式文件时,无需在pipelines.py中编写额外代码,只需执行以下命令即可:
scrapy crawl fiction 文件名.后缀若需将数据保存至MongoDB数据库,则需编写以下代码:
from pymongo import MongoClient
client=MongoClient()
collection=client["Fiction"]["fiction"]
class Test1Pipeline:
def process_item(self, item, spider):
collection.insert(item)
return itemSpider爬虫数据提取
在开始提取数据之前,首先访问目标小说网站并打开浏览器的开发者工具,界面如下图所示:
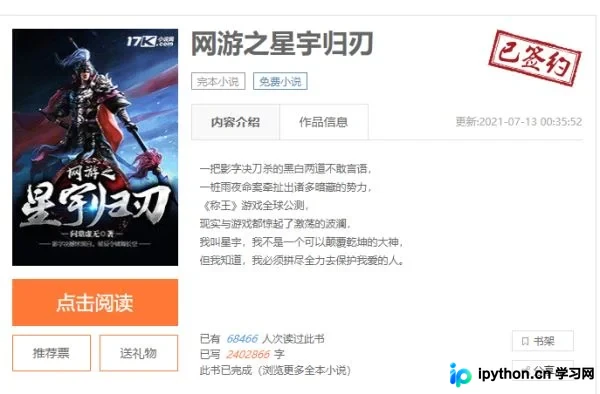
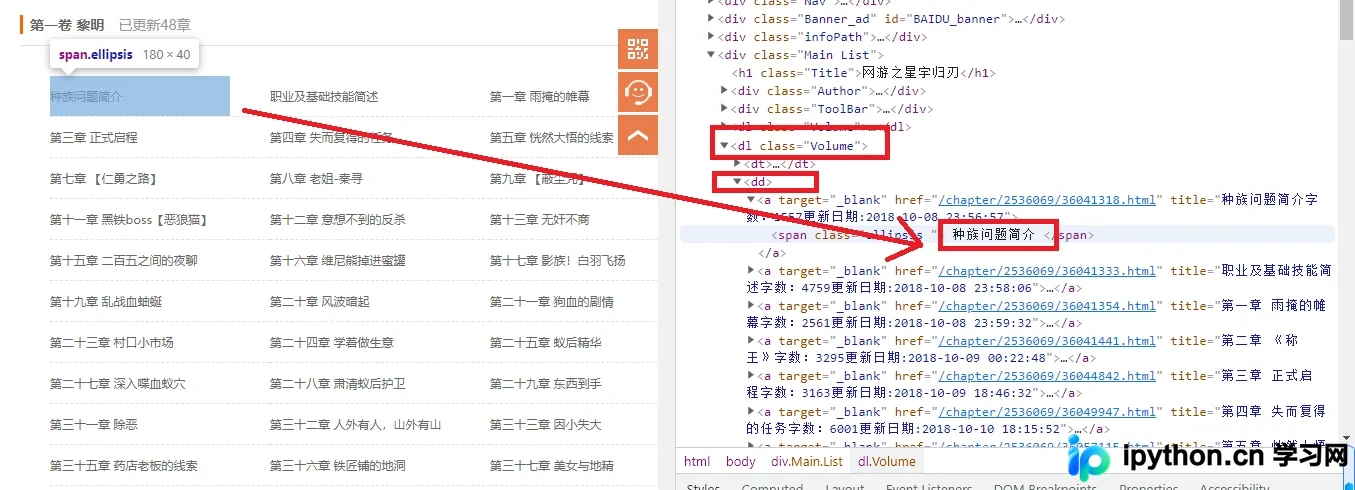
通过观察上图可以发现,<dl class="Volume">标签内存储了所有小说的章节名称。点击任意章节即可跳转至对应的章节详情页,因此我们可以利用XPath定位该div元素作为爬取范围,并通过for循环遍历获取每个章节的名称及其URL链接。
跳转至章节内容页面后,再次打开开发者工具,界面如下图所示:
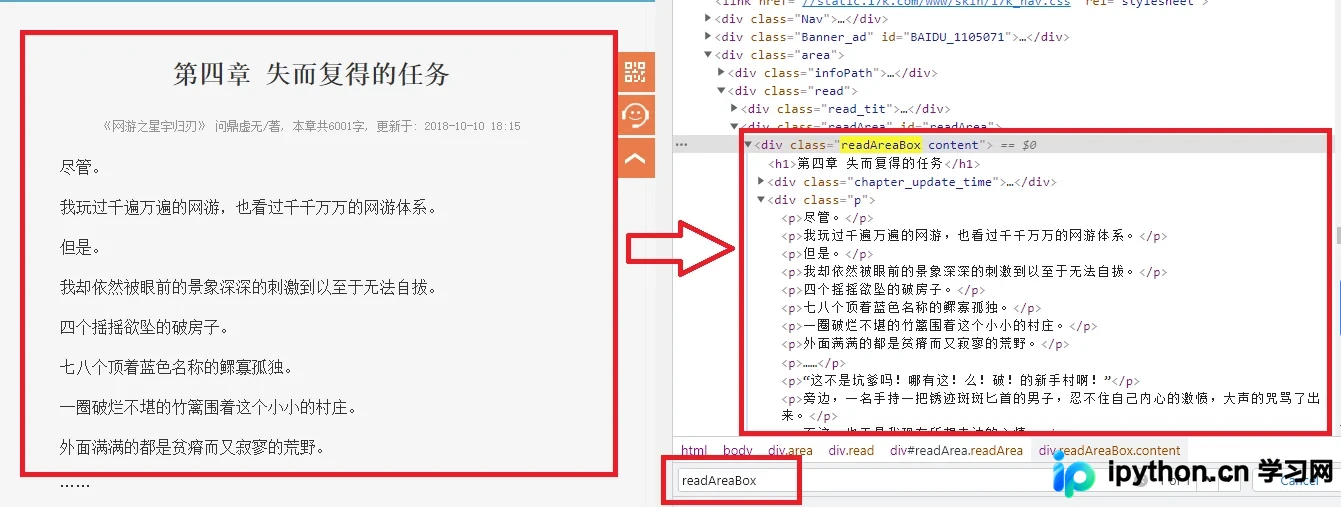
通过上图分析可知,小说正文内容存储在<div class="readAreaBox">标签内。我们可以通过for循环遍历该dl下的<div class="p">元素以获取章节全部内容,同样也可以使用XPath进行提取。
items.py代码定义字段
细心的读者可能已经注意到,我们需要提取的关键字段包括章节名、章节URL链接以及章节内容。其中,章节名和章节内容是需要持久化保存的数据,因此建议先在items.py文件中定义好字段名,具体代码如下所示:
import scrapy
class FictionItem(scrapy.Item):
# define the fields for your item here like:
name = scrapy.Field()
text = scrapy.Field()定义字段非常简单,只需使用字段名=scrapy.Field()的语法即可。
在items.py中预先定义字段的一个显著优势是,当获取到数据时,可以使用不同的item对象来存储不同类型的数据。在将数据传递给pipeline时,可以通过isinstance(item,FictionItem)来判断数据所属的item类型,从而进行差异化的数据处理。
定义好字段后,我们需要在pipeline.py文件中编写代码,对不同item的数据进行区分处理,具体代码如下:
from Fiction.items import FictionItem
class FictionPipeline:
    def process_item(self, item, spider):
        if isinstance(item,FictionItem):
            print(item)
当然,在当前的爬取项目中,实际上只需要一个class类。上述代码仅用于演示如何判断和区分数据属于哪个item。
fiction.py代码提取数据
fiction.py文件即为我们创建的spider爬虫,打开该文件,其初始代码内容如下所示:
import scrapy
class FictionSpider(scrapy.Spider):
name = 'fiction'
allowed_domains = ['www.17k.com']
start_urls = ['http://www.17k.com/']
def parse(self, response):
pass其中各部分含义如下:
name:定义爬虫名称的字符串,每个项目中该名称必须唯一,用于区分不同的Spider。启动爬虫时使用scrapy crawl +该爬虫名字;allowed_domains:定义允许爬取的域名,防止爬虫意外爬取到其他网站;start_urls:定义最开始爬取的url;parse():该方法负责解析返回的响应、提取数据或进一步生成待处理的请求。注意:不能修改这个方法的名字。
大致了解该文件各部分功能后,我们开始提取首页的章节名和章节URL链接,具体代码如下所示:
import scrapy
from Fiction.items import FictionItem
class FictionSpider(scrapy.Spider):
name = 'fiction'
allowed_domains = ['www.17k.com']
start_urls = ['https://www.17k.com/list/2536069.html']
def parse(self, response):
html = response.xpath('//dl[@class="Volume"]')
books = html.xpath('./dd/a')
for book in books:
item =FictionItem()
item['name'] = []
name = book.xpath('./span/text()').extract()
for i in name:
item['name'].append(i.replace('\n', '').replace('\t', ''))
href = book.xpath('./@href').extract_first()
href = 'https://www.17k.com' + href
yield scrapy.Request(url=href, callback=self.parse_detail, meta={'item': item})首先导入FictionItem,然后将start_urls链接修改为待爬取的URL。在parse()方法中,使用xpath获取章节名和URL链接,通过for循环调用FictionItem(),并将章节名存入item中。
通过生成器yield返回调用scrapy.Request()方法,其中:
url=href:表示下一个待爬取的URL链接;callback:表示指定parse_detail函数作为解析处理回调;meta:实现在不同解析函数之间传递数据。
在上一步中,我们指定了parse_detail函数作为解析处理回调。接下来将编写parse_detail函数以获取章节内容,具体代码如下所示:
    def parse_detail(self,response):
        string=""
        item=response.meta['item']
        content=response.xpath('//*[@id="readArea"]/div[1]/div[2]//p/text()').extract()
        for i in content:
            string=string+i+'\n'
        item['text']=string
        yield item
首先定义一个空变量string,然后通过response.meta[]来接收item数据,其参数对应上一步中的meta={'item': item}中的item。接着获取章节内容,最后将章节内容存储在item['text']中,并通过生成器yield将数据返回给引擎。
pipelines.py代码保存数据
章节名和章节内容已全部获取完毕,接下来我们将获取的数据保存为txt文件,具体代码如下所示:
from Fiction.items import FictionItem
import time
class FictionPipeline:
    def open_spider(self, spider):
        print(time.time())
    def process_item(self, item, spider):
        if isinstance(item, FictionItem):
            title = item['name']
            content = item['text']
            with open(f'小说/{title[0]}.txt', 'w', encoding='utf-8')as f:
                f.write(content)
    def close_spider(self, spider):
        print(time.time())
首先导入FictionItem和time模块,在open_spider()和close_spider()方法中编写代码调用time.time()以获取爬取的开始时间和结束时间。随后在process_item()方法中,将引擎返回的item['name']和item['text']分别存放在title和content变量中,并通过open打开txt文件,调用write()将章节内容写入txt文件中。
settings.py代码启动爬虫
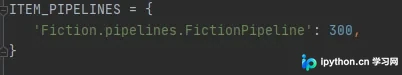
在启动爬虫前,我们需要先在settings.py文件中配置引擎。配置方式很简单,只需找到下图中的代码,并取消注释即可:
有人可能会问:User-Agent在哪里设置?我们可以在settings.py文件中设置User-Agent,具体代码如下:

好了,所有代码编写完毕,接下来启动爬虫。执行代码如下:
scrapy crawl fiction启动爬虫后,控制台会输出大量log日志数据。此时,可以通过在settings.py中添加以下代码来屏蔽这些log日志:
LOG_LEVEL="WARNING"结果展示
至此,关于使用scrapy框架爬取小说的教程就讲解完毕,感谢大家的观看!
更多关于Python爬虫教程Scrapy框架爬取的资料,请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















