


Python零基础怎么学:从环境配置到项目实战的系统学习路径

零基础学习编程的核心难点并不在语法记忆,而在于建立一条反馈及时、边界明确的落地闭环。本文针对初学者容易陷入的“配不好开发环境、背完语法写不出程序、找不到练习抓手”三大障碍,提供一套从本地解释器安装配置、核心语法筛选消化,到模块化编程与自动化项目实操的完整路径。
一、全景图:四阶段渐进式学习框架
学习编程最怕在盲目铺展知识点时迷失方向。Python 的应用场景极广,覆盖数据分析、网络开发、系统运维、自动化办公及机器学习。如果零基础学习者一开始就试图覆盖所有分支,极易在无反馈的学习中耗尽精力。
合理的进阶路线应当遵循“能跑通环境 → 掌握基础构建块 → 组织多文件逻辑 → 产出可解决实际问题的脚本”。下方的学习路径图梳理了这四个阶段的核心交付物与验收标准:
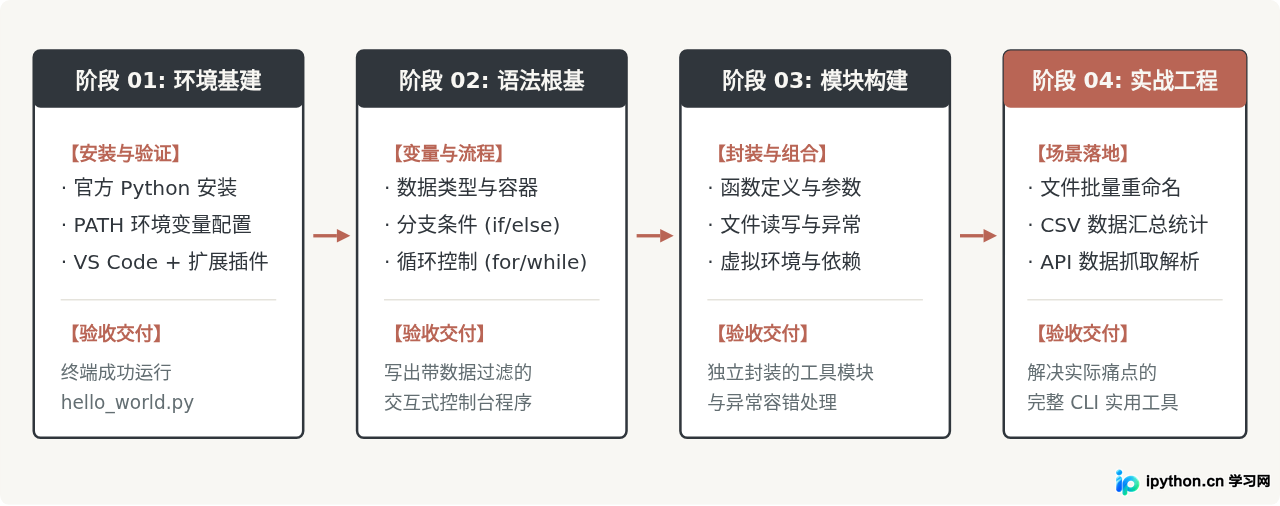
二、第一阶段:环境配置与开发工具搭建
初学者的第一道门槛往往不是代码语法,而是命令行与环境工具的配置。配置失败的主要根源是操作系统找不到 Python 解释器的路径,或者安装了多个混乱的版本。
1. 解释器安装与环境变量验证
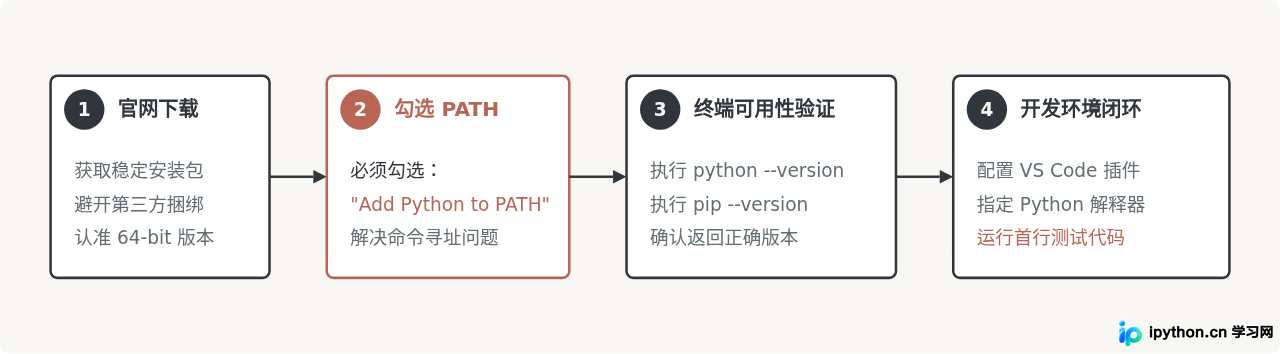
前往 Python 官方网站(python.org)下载最新的稳定版本(推荐 Python 3.11 或 3.12 以上的稳定分支)。
关键操作提醒:Windows 用户在安装欢迎界面务必勾选底部的 "Add python.exe to PATH"(将 Python 添加到系统环境变量)。若遗漏这一选项,系统命令行将无法识别 python 命令。
安装完成后,打开系统的终端(Windows 为 CMD 或 PowerShell,macOS 为 Terminal),分别执行以下两行指令进行测试:
python --version
pip --version
若系统提示 'python' 不是内部或外部命令,说明安装路径未写入系统的 PATH 变量中,需重新运行安装包选择 “Modify” 并补齐该勾选,或在系统高级设置中手动添加 Python 执行文件所在路径。
2. 编辑器选择与配置
对于零基础开发者,推荐使用 Visual Studio Code (VS Code),而非臃肿复杂的重型集成环境。其核心配置极为简单:
- 下载并安装 Visual Studio Code。
- 在左侧扩展商店(Extensions)中搜索并安装 Microsoft 官方发布的 Python 扩展。
- 新建一个工作文件夹,并在 VS Code 中打开该文件夹。
- 新建文件并命名为
app.py,编写第一行测试代码。
# app.py
print("Python 开发环境配置成功!")
在编辑器右上角点击运行三角图标,或在内置终端运行 python app.py。当终端正确打印出上述中文字符时,开发基础环境即告打通。
三、第二阶段:核心语法与控制流
学习语法的核心目的不是为了做语法选择题,而是理解数据如何在内存中存取,以及代码如何根据条件执行。
1. 核心数据类型与内存直觉
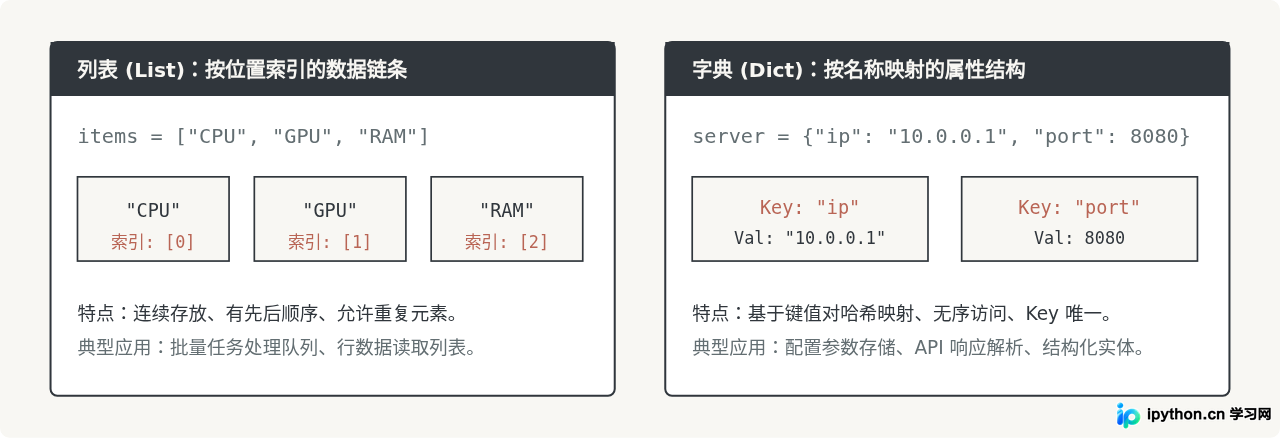
初学阶段重点掌握 4 种基础标量类型与 2 种最核心的集合类型:
- 数值型:
int(整数,用于计数与索引)与float(浮点数,用于精确度量)。 - 字符串:
str,使用单双引号包裹的字符序列。必须熟练掌握f-string格式化语法。 - 布尔型:
bool,只有True和False,用于逻辑分支判断。 - 列表与字典:
list(有序可变序列,用于存放一组数据)与dict(键值对集合,用于模拟具有属性的实体)。
2. 流程控制与基本计算
Python 使用严格的缩进(推荐 4 个空格)来定义代码块层次。以下为结合条件判断与循环控制的完整示例:
# 示例:根据阈值过滤服务器状态
server_metrics = [
    {"hostname": "web-01", "cpu_usage": 45},
    {"hostname": "db-master", "cpu_usage": 88},
    {"hostname": "cache-01", "cpu_usage": 92}
]

warning_threshold = 80

for server in server_metrics:
    host = server["hostname"]
    usage = server["cpu_usage"]

    if usage >= warning_threshold:
        print(f"[警告] 节点 {host} 负载过高: {usage}%")
    else:
print(f"[正常] 节点 {host} 运行正常: {usage}%")四、第三阶段:函数抽象、模块化与异常处理
随着脚本规模扩大,若把所有代码写在一个主流程中,后续维护与定位 bug 的难度会成倍增加。该阶段的重点在于培养封装意识。
1. 函数:逻辑复用与清晰边界
编写函数时,务必遵循单一职责原则:一个函数只做一件事,通过参数输入,通过返回值输出,避免过度依赖全局变量。
def calculate_disk_utilization(used_gb: float, total_gb: float) -> float:
    """计算磁盘使用百分比,保留两位小数。"""
    if total_gb <= 0:
        raise ValueError("总容量必须大于 0")
    return round((used_gb / total_gb) * 100, 2)
2. 防御性编程:文件 I/O 与异常捕获
处理外部输入(文件、网络请求、用户输入)时,必须假设错误随时会发生。永远使用 with 上下文管理器来安全读写文件,以确保即便发生中断,文件句柄也能被系统正确释放。
# 安全的文件读取模式
def load_config_file(filepath: str) -> str:
    try:
        with open(filepath, "r", encoding="utf-8") as file:
            return file.read()
    except FileNotFoundError:
        print(f"错误:找不到指定路径的文件 -> {filepath}")
        return ""
    except PermissionError:
        print(f"错误:权限不足,无法读取 -> {filepath}")
        return ""
五、第四阶段:两个可落地的实战项目
不要过早接触体量庞大的全栈框架。从小型自动化脚本起步,能在半小时内获得正向反馈,是建立编程信心的最佳路径。
实战项目 1:基于规则的日志/文档批量重命名脚本
实际业务场景:导出系统日志或备份文件时,文件名前缀杂乱。需要扫描特定目录下符合条件的文件,规范重命名并增加时间戳标识。
import os
from pathlib import Path

def standardize_filenames(target_dir: str, extension: str, prefix: str):
    folder = Path(target_dir)

    if not folder.exists() or not folder.is_dir():
        print(f"指定的目录不存在: {target_dir}")
        return

    # 筛选指定后缀的文件
    target_files = [f for f in folder.iterdir() if f.is_file() and f.suffix == extension]
    print(f"共发现 {len(target_files)} 个符合条件的文件。")

    for index, file_path in enumerate(target_files, start=1):
        new_name = f"{prefix}_{index:03d}{extension}"
        new_dest = folder / new_name

        # 执行重命名
        file_path.rename(new_dest)
        print(f"重命名: {file_path.name} -> {new_name}")

# 执行演示(在实际运行前确保该测试目录存在)
if __name__ == "__main__":
    test_folder = "./logs_backup"
    os.makedirs(test_folder, exist_ok=True)
    # 创建空文件进行测试
    (Path(test_folder) / "old_error.log").touch()
    (Path(test_folder) / "old_access.log").touch()

standardize_filenames(test_folder, ".log", "service_log")实战项目 2:CSV 格式业务指标统计与告警报表
实际业务场景:处理由监控或业务系统导出的 CSV 报表,计算平均处理时延,并将超过 SLA(服务等级协议)的记录筛选出来写入告警结果文件。
import csv

def generate_performance_report(source_csv: str, output_csv: str, latency_limit_ms: int):
    alert_rows = []
    total_latency = 0
    count = 0

    with open(source_csv, mode="r", encoding="utf-8") as src:
        reader = csv.DictReader(src)
        for row in reader:
            latency = int(row["latency_ms"])
            total_latency += latency
            count += 1

            if latency > latency_limit_ms:
                alert_rows.append(row)

    avg_latency = round(total_latency / count, 2) if count > 0 else 0
    print(f"数据处理完毕: 总记录 {count} 条, 平均时延: {avg_latency} ms")

    # 输出告警列表
    if alert_rows:
        fieldnames = alert_rows[0].keys()
        with open(output_csv, mode="w", encoding="utf-8", newline="") as dest:
            writer = csv.DictWriter(dest, fieldnames=fieldnames)
            writer.writeheader()
            writer.writerows(alert_rows)
        print(f"告警报表已生成: 写入 {len(alert_rows)} 条异常记录至 {output_csv}")
    else:
        print("所有接口响应均在阈值范围内,未触发告警。")
六、零基础避坑与进阶总结
初学者在学习 Python 时最容易陷入以下误区,建议对照检查自己的学习行为:
- 不要纯看视频不动手:阅读代码与亲自在编辑器中敲击运行所调动的认知完全不同。遇到示例代码,一定要亲手输入并运行一次,尝试故意写错参数观察报错信息。
- 学会自主阅读 Traceback 报错提示:当程序崩溃时,终端输出的最后两行通常是核心。例如
IndexError: list index out of range提示列表越界,KeyError: 'name'提示字典中没有该键。直接把错误类型的最后一行复制搜索,往往能在几秒钟内定位问题。 - 隔离依赖,学会使用 venv:后续安装第三方库时,养成使用
python -m venv .venv创建虚拟环境的习惯,避免将全局 Python 环境的依赖包弄乱。
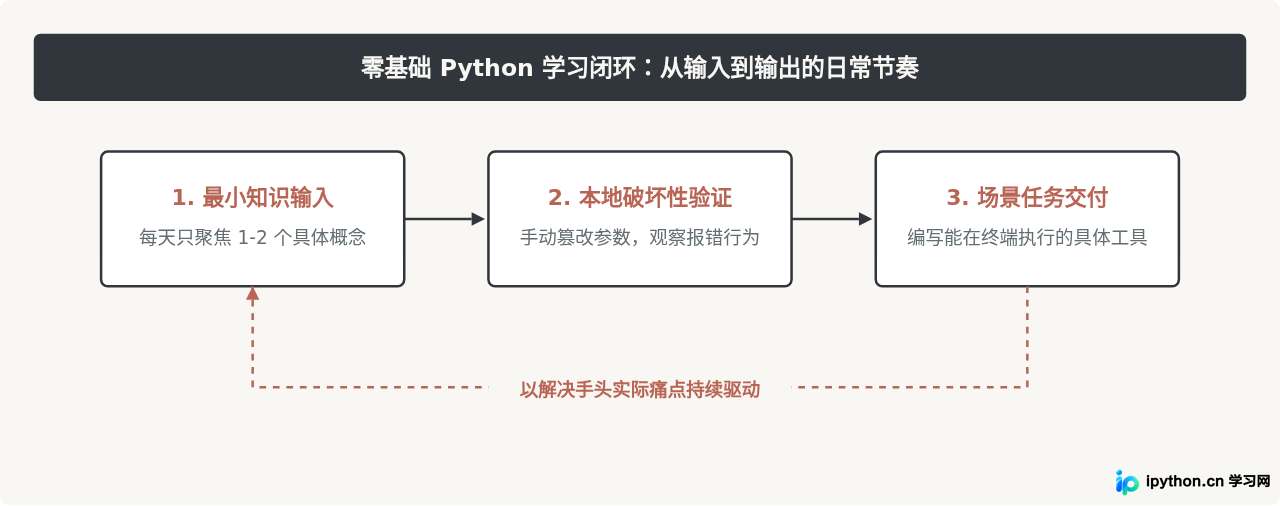
总结而言,零基础掌握 Python 的路径可以明确拆解为两步:先用最简单的解释器与单文件掌握语言基础表达,再用带文件或数据输入输出的小项目打通逻辑回路。不必把整本参考书背完才开始动手,带着目标写代码,遇到未知查官方文档,就是最系统也最快捷的学习方式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















