


Python使用xml.etree将XML文件批量转换为TXT文件的方法

发布时间:2026-10-14 |
2人浏览过
本文介绍如何利用Python内置的xml.etree模块,将XML格式数据高效转换为TXT文件。重点解析批量处理包含多个XML文件的文件夹场景,通过遍历目录、解析树结构并提取指定标签文本,实现自动化数据提取与格式转换,适用于数据分析前的预处理环节。
概述
首先介绍XML文件格式。从数据分析视角来看,XML数据集具备以下优势:开放性(支持跨平台读取处理,允许通过网络协议交换数据)、简单性(纯文本格式,便于跨系统交换)、结构与内容分离(区别于HTML,数据展示与数据本身独立)以及可扩展性(可衍生其他标记语言)。
问题描述
在数据分析过程中,如何有效利用XML中的数据?通常需要将此类文件转换为其他格式(更准确的说法是提取XML数据组成新的文件格式)。就我个人的观点,处理这方面的问题有点类似于网络爬虫,但不同于爬虫的是不需要考虑IP代理地址的问题(反爬确实是一个很难处理的问题)
问题解决方案
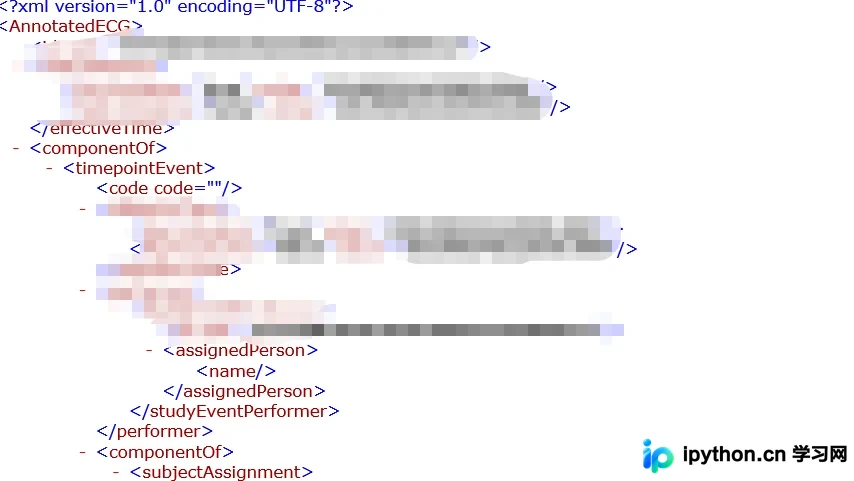
XML格式文件的内容显示大致如下:
import os
import sys
import xml.etree.ElementTree as ET
import glob

def xml_to_txt(indir, outdir):
    os.chdir(indir) # indir为xml文件来源的文件夹,outdir为转换的txt文件存储路径
    annotated = os.listdir('.') # 返回包含目录中文件名称的列表
    print(annotated)

    for i, file in enumerate(annotated):
        file_save = file.split('.')[0] + '.txt' #split将文件名与后缀名划分开来
        file_txt = outdir + "\\"+file_save
        f_w = open(file_txt, 'w')

        in_file = open(file,encoding='UTF-8')
        tree = ET.parse(in_file)
        root = tree.getroot()
        # 以下代码可忽略,你要在xml数据集上找到自己所需要数据对应的标签,想办法将其赋予一个变量,再将其写入新文件里就ok了
        for value in root.iter('xxx'):
            value = value.text
            f_w.write(value)
            f_w.write('\n\n')
补充说明:该方法在处理包含大量XML文件的文件夹时非常实用,能够直接读取并处理所有XML文件,操作便捷。
本文关于Python使用xml.etree方法将XML格式文件转换为TXT文件的介绍到此结束。如需了解更多Python XML转换TXT相关内容,请搜索本站历史文章或继续浏览后续文章,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















